Codex vs. MiniMax M2.1: replicando FoodCheck con dos IAs distintas
Una comparación práctica entre Codex y MiniMax M2.1 al replicar FoodCheck: qué cambia en el proceso, el resultado y la experiencia de construir con IA.
Comparar dos IAs programando no consiste solo en ver quién escribe mejor código. En la práctica, la diferencia más relevante aparece en cómo entienden una tarea abierta, cuánto contexto necesitan, qué decisiones toman cuando algo no está completamente especificado y cómo reaccionan a las correcciones. Esta es una experiencia concreta con las versiones y configuraciones utilizadas, no una evaluación general de los dos sistemas.
Para explorarlo, realicé una prueba: intenté replicar FoodCheck, una app publicada en GitHub Pages, con el objetivo de conservar su lógica de negocio y su interfaz. Este es el resultado.
La parte publicada en GitHub Pages debía ser estática. Este alojamiento no ejecuta código de servidor ni ofrece un backend tradicional. Eso no impide que el navegador llame a servicios externos: el Worker que aparece más adelante funciona fuera de GitHub Pages.
La misma aplicación, dos IAs:
- Codex (modelo gpt-5.1-codex-max), mi anterior asistente para desarrollar la app original.
- MiniMax M2.1 (Chat-Agent), al que di la URL para intentar replicar la aplicación.
El contraste entre ambos estilos fue más interesante de lo que esperaba.
FoodCheck como caso de estudio
FoodCheck no es solo una interfaz donde subes una foto y salen números. Por debajo hay decisiones de arquitectura críticas:
- Interpretación de imágenes de platos complejos, con estimaciones que requieren comprobación.
- Datos nutricionales y reglas relacionadas con el perfil que introduce el usuario; no una evaluación clínica validada.
- Persistencia local (registro diario) sin base de datos.
- Despliegue estático obligatorio en GitHub Pages.
Estas restricciones no son detalles técnicos, son el producto. Y aquí es donde la forma de trabajar de cada IA marca la diferencia.
Codex como copiloto: muy potente, pero necesita tareas bien acotadas
Con Codex (gpt-5.1-codex-max) la sensación general fue la de tener un copiloto sólido. Con un matiz: si no divides el trabajo en tareas muy específicas, tiende a dar más rodeos. Y además, cuando la app crece, a veces se olvida de lo que hizo varios mensajes atrás y hay que volver a explicarle el contexto.
En esta prueba, tendía a dispersarse sin instrucciones concretas. Tuve que dividir el problema en pasos, revisar propuestas que no encajaban con el despliegue final y recordarle las restricciones cuando recurría a patrones de desarrollo web incompatibles con ellas.
En mi caso, esto se notó especialmente en dos puntos: la detección de alimentos y la adaptación a una app estática.
La detección simulada como punto de partida
Igual que me ocurrió después con MiniMax, el punto de partida fue una detección ficticia simplificada, suficiente para que la UI y el flujo funcionen pero no aceptable si el objetivo es un análisis real de platos.
Aprendí que, si no insistes, la IA prefiere cerrar primero el producto visible y ya luego afinar el corazón técnico.
Llegar a una solución viable para GitHub Pages llevó iteraciones
Codex propuso configuraciones habituales en desarrollo web, como archivos .env o componentes propios de un backend). Las variables usadas durante la compilación no equivalen a secretos de servidor: cualquier valor incluido en el código que descarga el navegador queda expuesto. El código de servidor necesitaba otro alojamiento.
Hizo falta iterar hasta aterrizar en una solución compatible con una app estática, donde la parte inteligente vive fuera del frontend (por ejemplo, vía servicios externos).
Iniciativa conservadora
Al no haberle dado una indicación explícita sobre la base de datos nutricional a utilizar, Codex optó por una base de datos local muy reducida, con valores nutricionales introducidos manualmente para unos pocos alimentos. Desde el punto de vista del desarrollo incremental, esta decisión tiene sentido, ya que permite avanzar sin dependencias externas y validar el flujo completo de la aplicación.
Sin embargo, también muestra el patrón de Codex como copiloto, tendiendo a elegir soluciones seguras si no se le fuerza a ampliar el alcance. La integración con una base de datos real como OpenFoodFacts no surgió por inferencia de dominio, sino solo cuando se le indicó de forma explícita. Codex no se equivoca, pero tampoco asume contexto de producto si no se le pide.
MiniMax M2.1 como agente: rapidez, foco y buena inferencia de contexto
Con MiniMax M2.1 el enfoque fue distinto desde el principio. Lo utilicé para intentar replicar FoodCheck.
La diferencia se vio enseguida, ya que en apenas unos minutos fue capaz de:
- Hacer una primera lectura visual y lógica del producto original.
- Crear la carpeta y los archivos (index.html, styles.css, app.js, README.md).
- Desplegar una versión inicial funcional.
El agente también corregía algunos errores durante el proceso, de modo que en ocasiones yo solo veía la versión resultante.
Base de datos nutricional sin instrucciones explícitas
No tuve que mencionar Open Food Facts: el agente lo propuso como fuente de datos nutricionales. En esta prueba, esa iniciativa encajó bien con lo que necesitaba la aplicación.
Del token en el frontend al diseño correcto del sistema
Al integrar LLaVA vía Cloudflare, MiniMax propuso inicialmente que el usuario introdujera su API token en la aplicación. Esto complicaba el uso y exigía revisar cómo se trataba esa credencial; una clave compartida no debe incluirse en el código público.
Cuando pedí una alternativa, propuso un Cloudflare Worker como proxy para guardar el token fuera del código público y mantener el frontend estático. El Worker sigue siendo un servicio de servidor externo y necesita sus propios controles de acceso, límites y configuración.
En la práctica, este fue el punto donde MiniMax mostró más instinto de sistema y mayor capacidad para cerrar una solución completa de producto, no solo de código.
El punto débil de MiniMax: la fidelidad de la interfaz
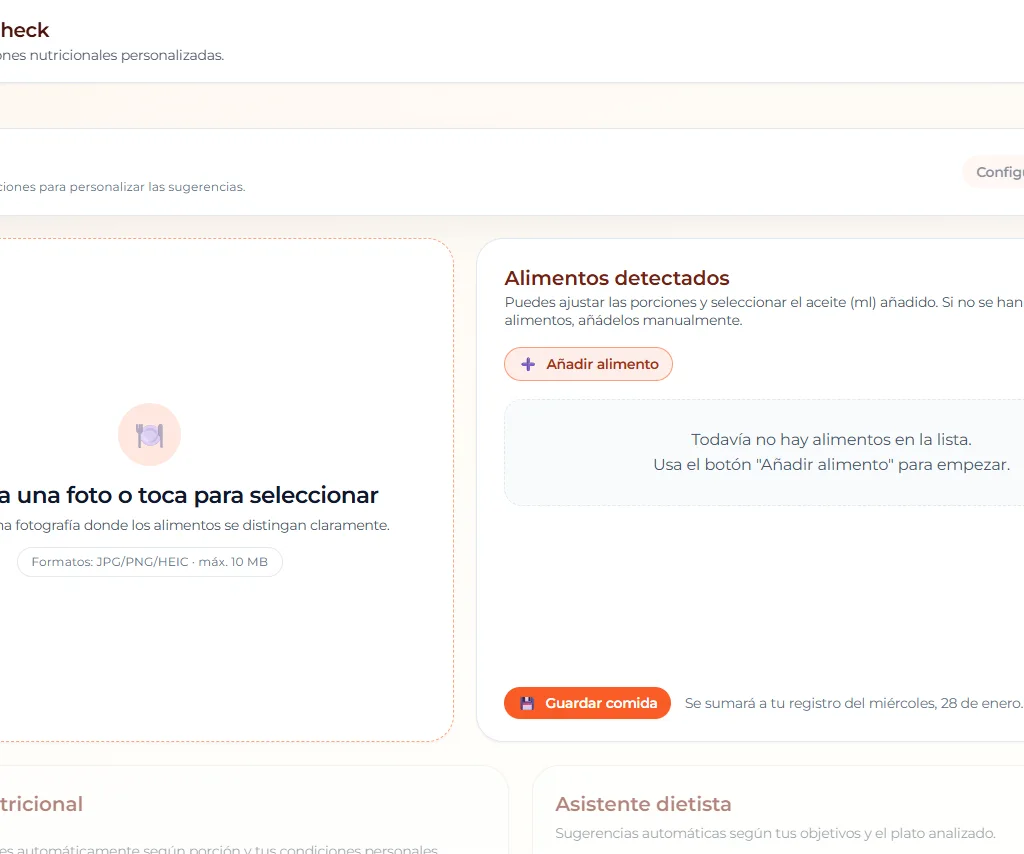
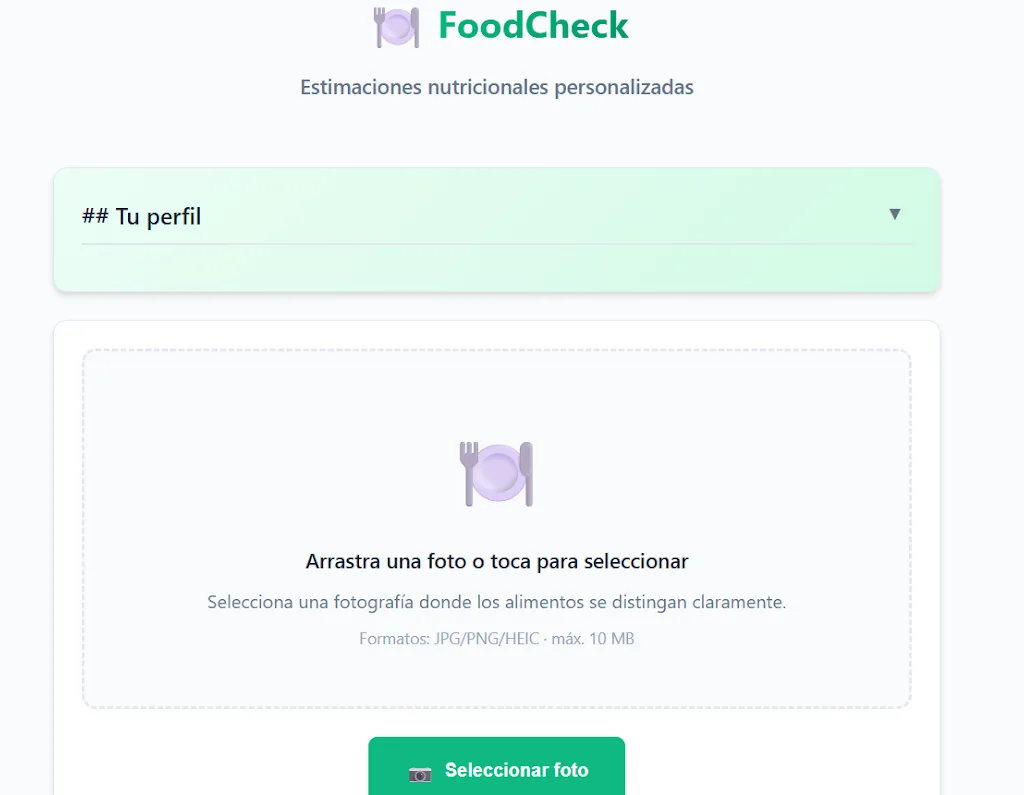
Sin embargo, esta autonomía que brilló en el backend, fracasó en el frontend. Donde MiniMax M2.1 no consiguió cerrar el objetivo fue en la replicación exacta de la interfaz.
Aunque intentó replicar exactamente el diseño y llegó a desplegar versiones afirmando que lo había conseguido, seguía habiendo diferencias. Y esto conecta con una realidad práctica, y es que “parecido” es fácil, pero “idéntico” es más complejo.
Un agente puede aproximar estilos, pero para clonar una interfaz de forma fiable suele necesitar acceso directo al CSS original, assets y una validación visual metódica (capturas comparativas, inspección de estilos, etc.). Sin eso, se queda en “muy similar” rellenando los huecos de diseño con su propia imaginación.
El tropiezo compartido con el «mínimo viable»
A pesar de sus diferencias, ambas IAs cayeron en la misma trampa al inicio: la detección simulada o simplificada. Pero esto no es un error raro, es un patrón. Se construye el “cascarón” del producto, y luego se conecta el motor real.
Ambos propusieron inicialmente TensorFlow.js + COCO-SSD. COCO-SSD reconoce un conjunto limitado de categorías de objetos, incluidos algunos alimentos, pero no ofrece por sí solo el análisis de ingredientes y cantidades de un plato complejo que buscaba para FoodCheck.
Mi lección fue que, en esta prueba, ambos priorizaron una interfaz funcional con una biblioteca conocida antes de resolver la interpretación de imágenes. Tuve que concretar mejor ese requisito y revisar las alternativas multimodales; usar un modelo más capaz tampoco elimina la necesidad de validar sus estimaciones.
Qué aporta Codex que MiniMax no
En mi experiencia con esta versión de Codex, la principal fortaleza fue el control. Cuando definía con claridad el diseño, las restricciones y el resultado esperado, sus propuestas se ajustaban mejor a lo solicitado. Eso no elimina los errores ni garantiza el mismo comportamiento en otras tareas.
Esto reduce el riesgo de soluciones elegantes pero incorrectas desde el punto de vista del producto. El coste es que exige más trabajo previo: descomponer el problema, anticipar restricciones y guiar activamente el camino. Codex no suele cerrar el sistema por ti, pero respeta mejor lo que tú defines como correcto.
Qué aporta MiniMax que Codex no
MiniMax M2.1 destaca cuando el problema es abierto y quería una primera versión funcional rápidamente. En mi prueba tomó más decisiones por iniciativa propia, como elegir Open Food Facts o proponer un Worker como proxy externo. Estas decisiones me resultaron útiles, aunque necesitaban revisión.
Esta autonomía acelera enormemente las primeras fases, pero introduce un riesgo. El modelo tiende a decidir qué es suficientemente bueno si no se le dan métricas claras. MiniMax no espera a que definas todos los detalles, los asume. Eso lo convierte en un generador de soluciones, pero en un asistente que necesita auditoría constante cuando la fidelidad importa.
Además, MiniMax parece ser mejor detective. Si el código falla, MiniMax suele mirar el error y proponer una solución que arregla el problema actual e incluso problemas futuros que uno aún no ha visto. Codex suele limitarse a arreglar solo lo que le pides.
Conclusión: dos estilos de IA, una misma responsabilidad humana
Este experimento deja una reflexión clara, y es que hoy en día, con IAs, hacer que una app exista es barato. En minutos puedes tener archivos, pantallas, incluso un flujo completo desplegado. Lo complejo empieza cuando tu objetivo no es simplemente que funcione, sino que sea exactamente lo que tú quieres.
Las dos IAs, de maneras distintas, rellenaron huecos. Si no defines con precisión cómo debe ser la arquitectura, proponen una. Si no delimitas qué significa “visión de platos complejos”, te ofrecen el modelo más a mano. Y si no instrumentas la fidelidad visual, te entregan una interfaz “bastante parecida” y la dan por buena.
Por eso, además de generar, hay que medir. En FoodCheck significaba comprobar las restricciones del despliegue: archivos estáticos en GitHub Pages y servicios externos para cualquier backend, comprobar las integraciones (tokens, CORS, endpoints, “Failed to fetch”) y establecer criterios visuales concretos para decidir si la réplica era fiel.
Si hay que destacar alguna diferencia práctica entre ambos modelos, podría decir que con Codex el trabajo humano se concentra al inicio, definiendo bien tareas, restricciones y arquitectura. Con MiniMax, el esfuerzo se desplaza al final revisando decisiones, detectando supuestos incorrectos y validando que tienes realmente lo que querías.
Ninguno elimina el trabajo del desarrollador; simplemente lo mueve de sitio. Elegir uno u otro no es tanto una cuestión de potencia del modelo como de en qué fase prefieres invertir tu atención. Pero en ambos casos, el resultado final depende menos del modelo que de la claridad con la que el desarrollador define qué cuenta como éxito.
En cualquier caso, quizá la enseñanza más interesante de todas es que cuando tienes un asistente que programa rápido, el trabajo se desplaza. Ya no es tanto escribir código, sino definir con precisión qué cuenta como correcto. Porque, si no lo defines tú, lo definirá la IA… y lo hará a su manera.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 6 feb 2026.
← Más historias de la comunidad