AImagining Tales
Un prototipo de Saturdays.AI Madrid que resume cuentos con T5, genera ilustraciones con VQGAN+CLIP y reúne texto e imágenes en un PDF.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
AImagining Tales nació en la quinta edición del curso de Saturdays AI Madrid, como propuesta para el desafío de crear un proyecto de impacto social utilizando la Inteligencia Artificial.
La finalidad de este proyecto es ser capaces de ilustrar cuentos.
Generación de imagen por AImagining Tales
¿Quiénes somos?
El equipo pertenece al itinerario de aprendizaje profundo (Deep Learning). Desde el principio nos interesaban el procesamiento de imágenes y el de texto, así que decidimos combinarlos.
- David Cayuelas García
- Marta Díez Díez
- Alejandra De Francisco Rus
- Claudia Lucio Sarsa
- Pablo Rodríguez Lapetra
¿Cuál es nuestra motivación?
Queremos explorar si una representación visual de los textos puede ayudar a personas con dificultades de aprendizaje, especialmente a niños y niñas. Es la motivación de este prototipo; todavía no hemos evaluado su eficacia educativa.
Adicionalmente, buscamos potenciar la escritura infantil, de forma que el niño pueda imaginar y escribir un cuento y, a continuación, verlo plasmado en imágenes autogeneradas.
De algún modo nos recuerda a las coloridas vidrieras de las iglesias. Su finalidad original era representar pasajes bíblicos para transmitir al pueblo, en su mayoría analfabeto, sus enseñanzas, a las que de otra manera no eran capaces de acceder.
AImagining Tales nace con la intención de facilitar el acercamiento a la lectura y la escritura.
¿En qué consiste nuestra solución?
Queremos construir una herramienta capaz de ilustrar cuentos a través de la Inteligencia Artificial.
En su concepción básica, nuestra herramienta procesaría el texto de un cuento como entrada para generar una imagen representativa de su contenido. Los textos originales, acompañados de sus correspondientes imágenes, se recopilarían en un documento PDF.
Para generar las imágenes elegimos VQGAN+CLIP, una combinación de modelos que nos resultó interesante en el momento del proyecto. Como el texto de entrada tiene límites de longitud, necesitamos resumir los pasajes antes de generar las ilustraciones.
Se ha optado por desarrollar un modelo de Procesamiento del Lenguaje Natural (NLP) para resumir los textos originales. Dicho modelo estará basado en modelos de sumarización existentes, reentrenados para nuestra tarea específica: la interpretación y resumen de cuentos.
Finalmente, texto e imágenes serán recopilados en un documento en formato PDF.
Con todo ello, el flujo sería el siguiente:
El cuento pasaría por un modelo NLP de sumarización, que daría como salida el texto resumido. Este resultado sería la entrada de la red VQGAN+CLIP, de la que se obtendría su representación. Una vez completadas las etapas, el texto del cuento y sus imágenes se combinarían en un documento PDF para su uso (más adelante se ilustra cada paso).
1. El dataset: Shmoop Corpus
Entrenar un resumidor plantea un reto importante: necesitamos narraciones con descripciones y diálogos, acompañadas de resúmenes escritos por personas. Preparar ese material es costoso y puede limitar la viabilidad del proyecto.
Afortunadamente, nos encontramos con que un grupo de investigadores de la Universidad de Toronto ya se había enfrentado a este problema. Para poder trabajar sobre modelos de sumarización, proponen su propio conjunto de datos: Shmoop Corpus.
Shmoop Corpus consta de 231 historias con 7.234 capítulos en total, con sus correspondientes resúmenes. Las historias, tal y como se indica en el paper original, han sido extraídas del Proyecto Gutenberg y los resúmenes desde la web de Shmoop, que da nombre al corpus. El verdadero elemento diferenciador en este dataset es que, además, proporcionan las claves para relacionar el par texto-resumen.
El equipo de Shmoop Corpus proporciona el conjunto de ficheros que contienen tanto las historias completas organizadas en carpetas (una por cada capítulo) como los ficheros en los que se indica el alineamiento/claves texto-resumen. Para la obtención de los resúmenes desde la web de Shmoop hemos recurrido a prácticas de raspado web (web scraping).
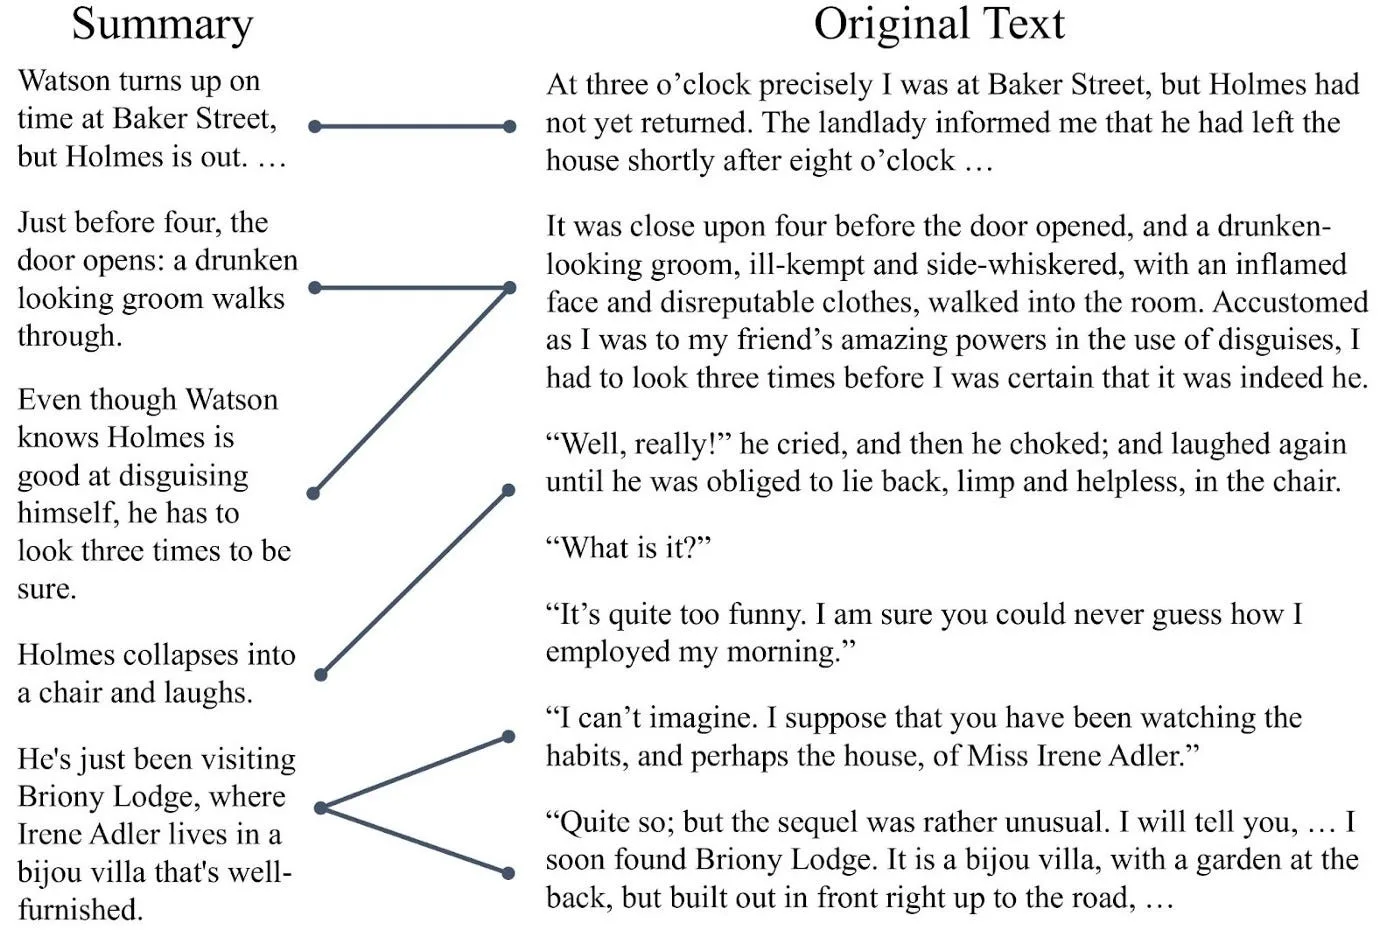
Ejemplo de un par texto-resumen del artículo original de Shmoop Corpus.
Para agrupar estos datos y obtener finalmente un dataset en el formato adecuado para entrenar el modelo, se lleva a cabo una tarea de agregación de la información desagregada en diferentes niveles de archivos (textos, resúmenes, claves texto-resumen).
El resultado de este procesamiento, un dataframe con una columna de párrafos y otra de resúmenes, es el input de entrenamiento del summarizer.
2. Procesamiento de textos: Summarizer
Tras la recopilación y procesamiento de los datos, estamos preparados para entrenar nuestro modelo sumarizador, en adelante el summarizer.
Un modelo de resumen busca producir una versión más breve que conserve la información principal. Los métodos extractivos seleccionan fragmentos originales; los abstractivos generan texto nuevo. T5 es un modelo generativo que puede reutilizar partes del original, pero sus resúmenes también pueden omitir detalles o introducir errores. summarizer.
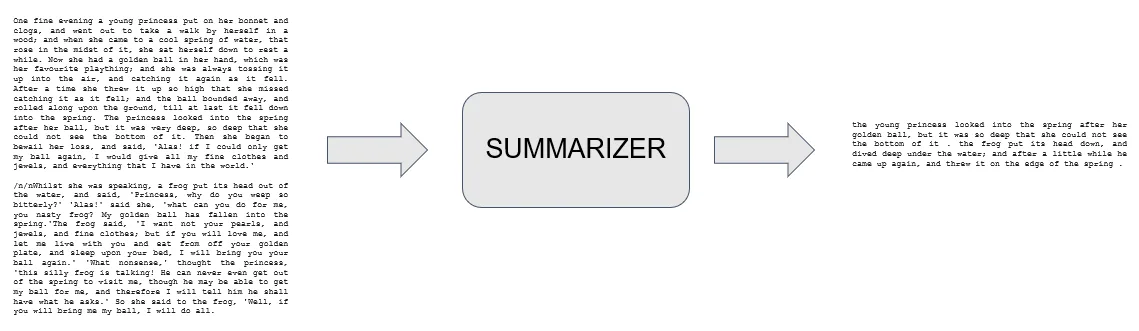
Resumen de un texto tras pasarlo por el Summarizer.
Actualmente, existen multitud de modelos preentrenados con este propósito, la mayoría de ellos basados en transformers. Estos están recogidos en la plataforma Hugging Face, un proyecto especializado en tareas de NLP y que persigue democratizar el acceso a la IA facilitando herramientas, datasets, modelos, etc. en abierto y para la comunidad.
En particular, en este proyecto hemos tomado como base tanto el tokenizer como el resumidor del modelo T5 de Google y lo hemos reentrenado con nuestro propio conjunto de datos para que sea capaz de interpretar y resumir no solo narraciones sino también diálogos. Este procedimiento de reentrenamiento para adaptarlo a una nueva tarea es lo que se conoce como transfer learning.
Nota para orientarse: el tokenizador divide el texto en unidades llamadas tokens y les asigna identificadores numéricos. El modelo transforma esos identificadores en representaciones vectoriales o embeddings. Tokenizar y crear embeddings son pasos relacionados, pero distintos.
Al ajustarlo a nuestros datos, buscamos mejorar los resúmenes literarios. Esa mejora debe comprobarse; no está garantizada por el reentrenamiento. El texto generado por el summarizer servirá de entrada al generador de imágenes.
3. Generación de imágenes: VQGAN + CLIP
Tras aplicar el summarizer sobre nuestros textos, es hora de usar estos resúmenes para generar las imágenes que ilustrarán nuestras historias. Para ello, nos hemos centrado en modelos de generación de imágenes a partir de texto.
Después de hacer la correspondiente investigación del actual estado del arte (más allá de DALL-E y DALL-E 2), encontramos una implementación muy interesante que une VQGAN y CLIP (Vector Quantized Generative Adversarial Network and Contrastive Language–Image Pre-training).
Las redes GANs (Generative Adversarial Networks) son sistemas compuestos por dos redes neuronales, que básicamente “se enfrentan” una contra otra. Un generador que sintetiza imágenes o datos, y un discriminador, que aprende a distinguir los datos generados de los reales. El entrenamiento alterna ambos componentes, aunque no garantiza una mejora continua.
En este concepto se basa nuestro modelo. VQGAN aporta la representación generativa de las imágenes, mientras que CLIP puntúa la correspondencia entre texto e imagen. Esa puntuación sirve para orientar la generación hacia el texto de entrada.
Además, en este proceso se pueden añadir multitud de parámetros: imágenes de referencia, estilos, más de un único texto, el tamaño de la imagen generada, etc.
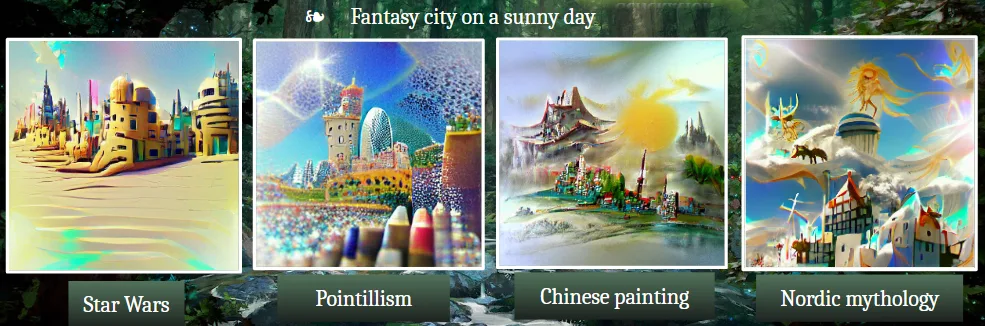
Representación de “Fantasy city on a sunny day” con diferentes estilos.
Por supuesto, el reto ha sido entender este modelo ya entrenado, para saber qué parámetros se ajustan mejor a nuestro proyecto, así como los textos de entrada que mejores resultados dan (ni muy cortos, ni muy largos, diferencias entre un único texto con sentido o conceptos clave…).
4. Generación de cuentos: PDF generator
Por último, es hora de unir el resultado de todos los pasos en nuestro cuento ilustrado.
Para ello, hemos desarrollado una serie de funciones que crean el cuento en formato PDF. Aquí unimos los textos iniciales, junto con las imágenes generadas a partir de los resúmenes.
Tras barajar diferentes opciones de librerías de Python que ofrecen esta funcionalidad (ReportLab, PyPDF2), nos decidimos por PyFPDF por el manejo más sencillo.
La primera página es una portada con el título y una imagen generada a partir de él. Para las páginas siguientes ofrecemos varios formatos que cambian la posición de la ilustración.
Además, hemos decidido dar un estilo de cuento a nuestros documentos, con un borde y detalles en las esquinas.
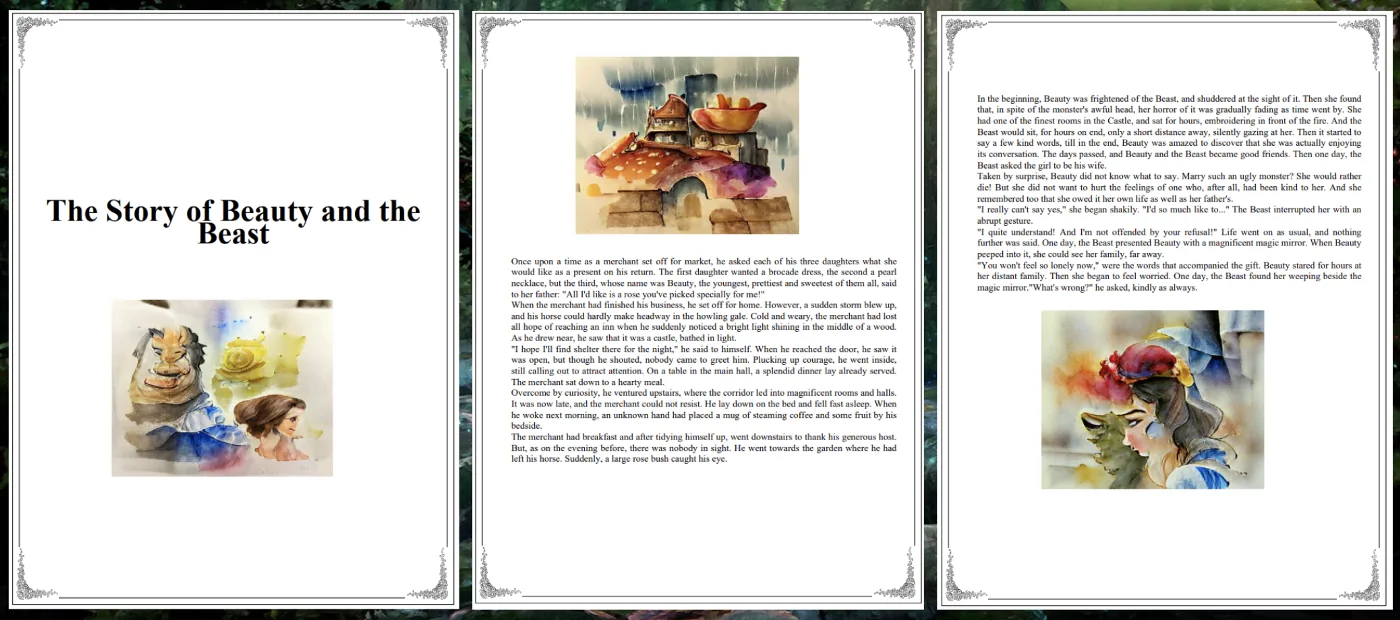
“La Bella y la Bestia” ilustrado por AImagining Tales.
Próximos pasos y reflexiones
Esta propuesta es una primera iteración, una prueba de concepto, el resultado del trabajo colaborativo de nuestro equipo a lo largo de seis semanas.
A través de nuestro proyecto queremos poner en valor el inmenso potencial que ofrece la Inteligencia Artificial para dar soluciones a problemas reales de actualidad, soluciones que están al alcance de todos.
Aún queda por hacer para que AImagining Tales sea una realidad.
Y colorín colorado…
Si te has quedado con ganas de más y quieres revisar el código en mayor profundidad, te invitamos a visitar nuestro repositorio de Github.
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 7 jun 2023.
← Más historias de la comunidad