Predicción de fallos en motores de turboventiladores con LSTM
Un proyecto de mantenimiento predictivo que aplica redes LSTM a datos simulados de turboventiladores para explorar la detección anticipada de fallos.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
Integrantes:
- Alanoca Huaycho, Alvaro (https://www.linkedin.com/in/alvaro-alanoca-huaycho-b582b6139/)
- Martínez Alegría, Albert (https://www.linkedin.com/in/albert-martinez-alegria/ )
INTRODUCCIÓN
El mantenimiento correctivo puede resultar costoso: además de la reparación, una avería puede detener la producción. El mantenimiento preventivo, en cambio, programa intervenciones según intervalos definidos, aunque algunas piezas todavía puedan seguir funcionando. El reto es complementar estos enfoques con información sobre el estado real de los equipos.
Los avances tecnológicos permiten estudiar nuevas formas de anticipar fallos. Este enfoque se conoce como mantenimiento predictivo (PdM). Los sensores pueden aportar datos de vibración, temperatura y otras variables; los análisis de aceites o grasas ofrecen información adicional sobre el estado de los equipos.
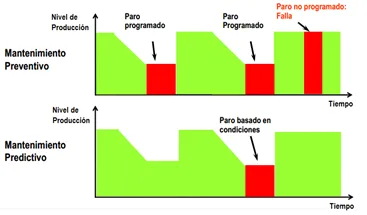
Fig. 1. Diferencia de ganancia por producción entre el mantenimiento preventivo tradicional y el mantenimiento predictivo, donde solamente se detiene la producción basado en condiciones.
DESCRIPCIÓN DEL PROBLEMA
Queremos reducir el tiempo y los recursos que exige responder a una avería, y estudiar si las intervenciones preventivas pueden ajustarse mejor al estado del equipo. Ambos tipos de mantenimiento influyen en la disponibilidad de la maquinaria y en la continuidad de la producción.
DATASET
Utilizamos datos simulados de degradación de turboventiladores generados con C-MAPSS, de la NASA. Sus registros representan ciclos operativos, no días naturales. El enfoque podría investigarse en otras máquinas rotativas, como motores o bombas hidráulicas, pero requeriría datos y validación específicos para cada equipo.
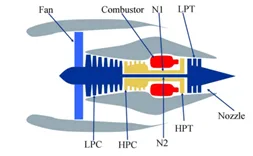
Fig. 2. Imagen del turboventilador simulado por C-MAPSS.
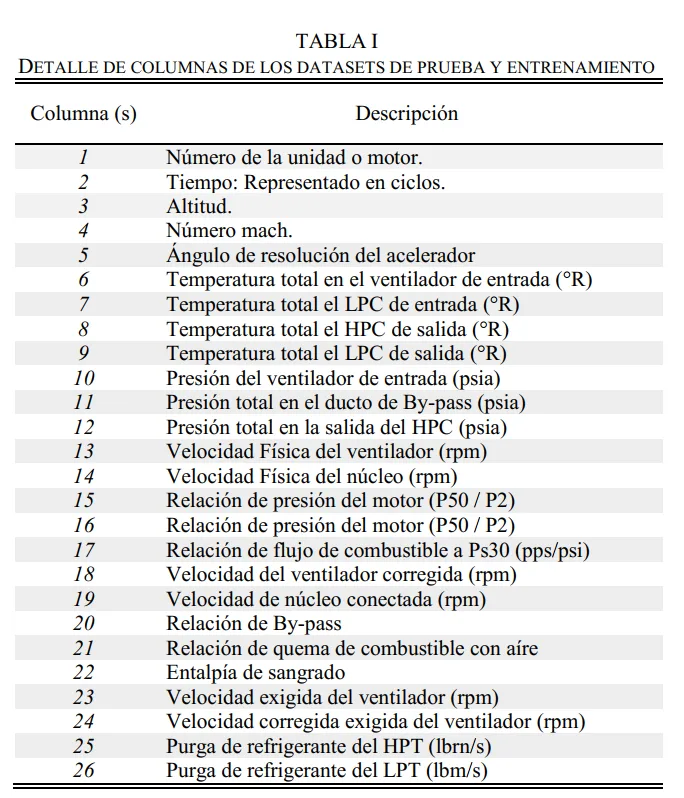
Tabla 1. Detalle de las columnas de los datasets de prueba y entrenamiento.
SOLUCIÓN PROPUESTA
El proyecto explora la detección de fallos dentro de un horizonte de funcionamiento. El objetivo es apoyar la planificación de paradas y la compra de repuestos con más antelación.
SELECCIÓN DEL MODELO
RNN
Las redes neuronales recurrentes (RNN) procesan secuencias manteniendo un estado que incorpora información de pasos anteriores. Esto permite modelar relaciones temporales, aunque las RNN convencionales pueden tener dificultades con dependencias largas.
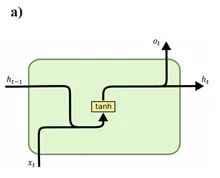
Fig. 3. Arquitectura de una Red neuronal recurrente (RNN)
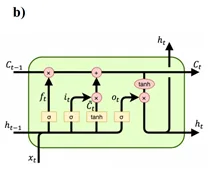
Fig. 4. Arquitectura de una Long Short-Term Memory (LSTM)
LSTM
El entrenamiento de una RNN puede verse afectado por gradientes que se desvanecen o crecen demasiado. Las redes LSTM son una variante diseñada para manejar mejor dependencias largas. Sus celdas de memoria y compuertas regulan qué información conservar, actualizar o transmitir; no son automáticamente el mejor modelo para cualquier problema.
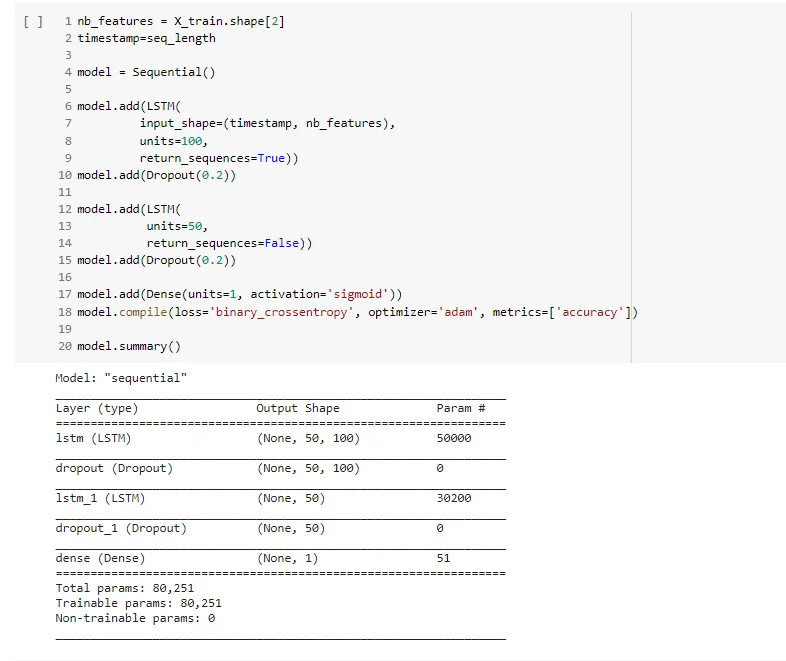
Fig. 5. Programación de la RNN con LSTM
La red tiene dos capas LSTM, con 100 y 50 unidades respectivamente. Después de cada una se aplica dropout para reducir el sobreajuste. Una capa densa final con activación sigmoide produce una puntuación entre 0 y 1; interpretarla como probabilidad fiable exige evaluar su calibración.
PCA
El análisis de componentes principales (PCA) es una técnica no supervisada que permite reducir la dimensionalidad y preparar los datos para el modelo.
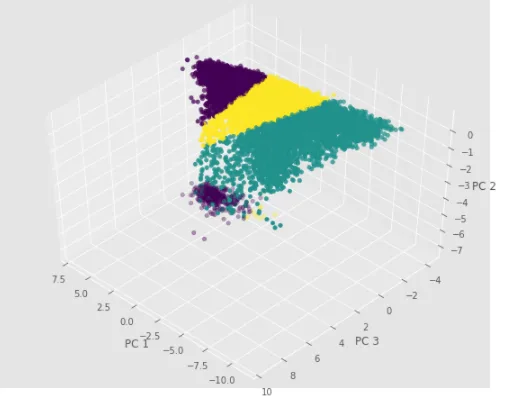
Fig. 6. PCA aplicado a tres dimensiones para poder graficarlo.
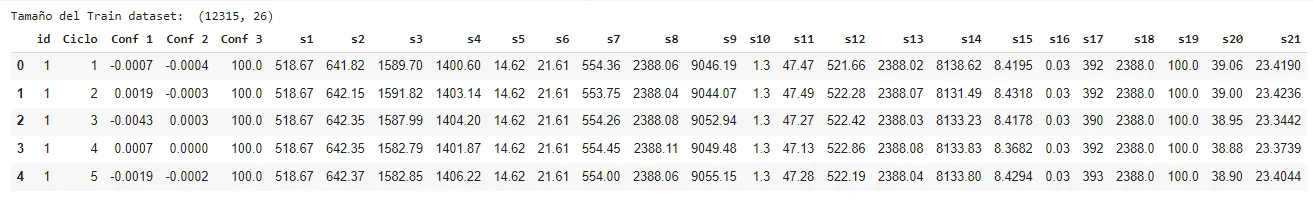
Fig. 7. Datos completos: 21 sensores y 3 parámetros de funcionamiento.
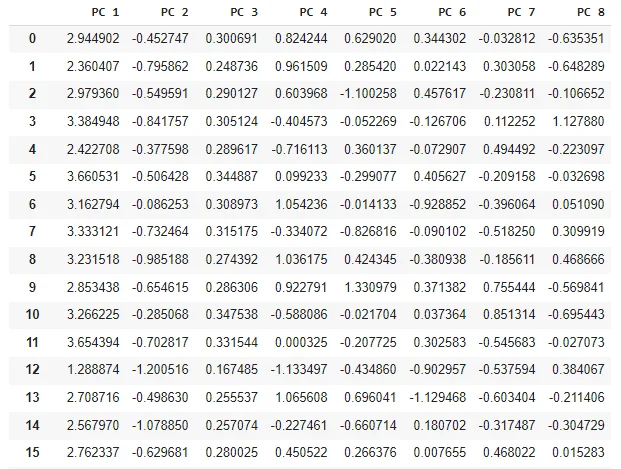
Fig. 7. Datos del dataset con PCA aplicado. Se reducen a 8 componentes principales.
MÉTRICAS
En las pruebas recogidas se reporta una exactitud del 95,11 % y varias medidas F1; la media macro es la menor. También aparece un 97 % al comparar predicciones con datos de prueba. Son resultados de las evaluaciones descritas y no deben combinarse en una única cifra de rendimiento sin identificar sus particiones y condiciones.
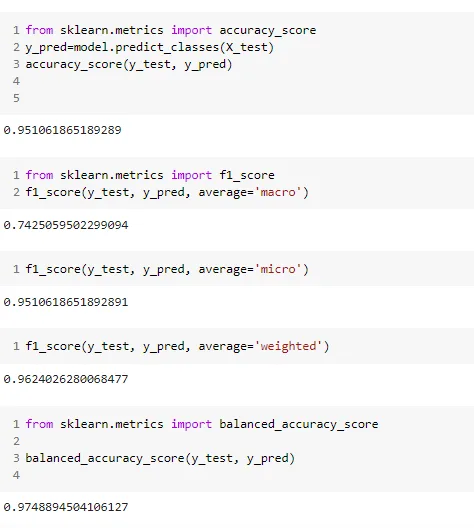
Fig. 8. Métricas calculadas: Accuracy Score, F1-Score Macro, F1-Score Micro, F1-Score Weighted.
ANÁLISIS DE RESULTADOS
La matriz de confusión mostrada corresponde a una exactitud del 92,77 %. La curva ROC permite examinar el equilibrio entre verdaderos y falsos positivos para distintos umbrales; por sí sola no establece un umbral operativo seguro.
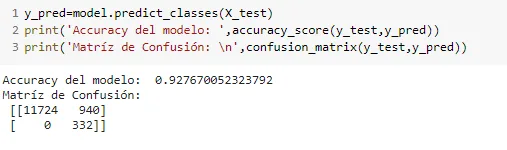
Fig. 9. Matriz de Confusión
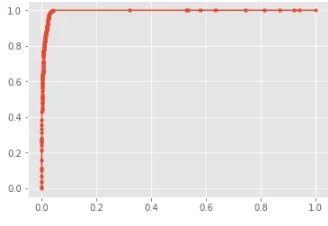
Fig. 10. ROC CURVE
RESULTADO
El prototipo produce una estimación de fallo dentro de un horizonte de 30 ciclos. La interfaz original lo presenta como «30 días», pero el conjunto C-MAPSS mide ciclos operativos. Al seleccionar el identificador del motor, en el ejemplo se muestra para el motor 16 un valor del 1,8 %. Esta salida no garantiza que el motor sea seguro ni sustituye las inspecciones y los criterios de mantenimiento.
En una posible aplicación, repetir el análisis periódicamente podría ayudar al equipo de mantenimiento a priorizar revisiones. Las decisiones operativas requerirían validación y supervisión técnica.
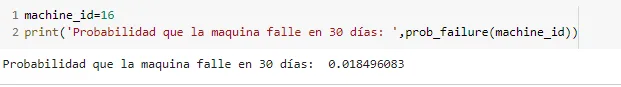
Fig. 11. Salida del prototipo. La etiqueta original «30 días» debe interpretarse con cautela: los datos utilizados están expresados en ciclos operativos.
CONCLUSIÓN
La aplicación muestra cómo analizar datos de un equipo para explorar la detección anticipada de fallos. Con validación adicional, este tipo de enfoque podría ayudar a planificar el mantenimiento y la compra de repuestos; el experimento no demuestra que determine el momento exacto de una avería.
El resultado cercano al 95 % corresponde a una de las evaluaciones del modelo sobre datos simulados. Antes de usarlo en una planta industrial sería necesario validarlo con los equipos reales, estudiar los falsos negativos y calibrar sus salidas. Los sensores conectados mediante IoT podrían aportar los datos necesarios para ese trabajo.
Un mantenimiento mejor ajustado al estado de los equipos podría reducir sustituciones innecesarias y aprovechar mejor aceites y grasas. La posible reducción de residuos industriales tendría que medirse en una implantación real.
CÓDIGO
BIBLIOGRAFÍA
[1] D. Bruneo y F. De Vita, “Sobre el uso de redes LSTM para mantenimiento predictivo en industrias inteligentes”, en Actas — Conferencia internacional IEEE sobre computación inteligente de 2019, SMARTCOMP 2019, 2019, págs. 241–248, doi: 10.1109/SMARTCOMP.2019.00059.
[2] S. Guldamlasioglu y O. Aydın, “Using LSTM networks to predict engine condition on large scale data processing framework”, 2017, doi: 10.1109/ICEEE2.2017.7935834.
[3] L. Swanson, “Linking maintenance strategies to performance,” Int. J. Prod. Econ., vol. 70, no. 3, pp. 237–244, Apr. 2001, doi: 10.1016/S0925–5273(00)00067–0
[4] A. Martínez, “Redes Neuronales Recurrentes con LSTM aplicado al Mantenimiento Predictivo, Caso: Degradación de motores de turboventiladores”, 2020, Universidad Católica Boliviana “San Pablo”.
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 10 ago 2022.
← Más historias de la comunidad