MLOps en 2026 y el trabajo de llevar la IA a producción
Llevar un modelo de inteligencia artificial a producción es solo el principio. MLOps permite gestionar su ciclo de vida, desde los datos y el entrenamiento hasta el despliegue, la monitorización y el mantenimiento. En este artículo repasamos las principales prácticas y herramientas de MLOps en 2026, así como los nuevos desafíos que plantean los modelos de lenguaje y los agentes de IA.
Este archivo incluye traducciones automáticas. El audio, el vídeo y el texto de las imágenes conservan su idioma original.
Imagina que entrenas un modelo para anticipar cuántos productos venderá una tienda. En las pruebas, las predicciones son buenas. Lo conectas al sistema de pedidos y, durante unas semanas, ayuda a ajustar las compras. Entonces llega una promoción, cambia el comportamiento de los clientes y las estimaciones empiezan a fallar. La aplicación sigue respondiendo; el servidor no muestra errores. Sin embargo, el almacén empieza a llenarse de productos que nadie compra.
Ese salto entre un modelo que funciona en pruebas y un sistema que sigue siendo útil en el mundo real es el terreno de MLOps. Para entenderlo hay que mirar más allá del algoritmo: qué datos recibe, cómo se actualiza, quién valida los cambios y qué ocurre cuando sus predicciones dejan de ser fiables.
El ecosistema actual ofrece herramientas para resolver cada una de esas necesidades. Conocer su función permite elegir una arquitectura razonable, tanto para un primer proyecto como para una plataforma que opera muchos modelos. También ayuda a entender por qué los modelos de lenguaje y los agentes están ampliando este trabajo.
Qué es MLOps y qué añade a DevOps
MLOps, abreviatura de Machine Learning Operations, reúne prácticas de aprendizaje automático, ingeniería de software y operaciones para desarrollar y mantener sistemas de ML en producción. Su objetivo es poder reconstruir cómo se obtuvo un modelo, introducir mejoras con controles y detectar cuándo hace falta intervenir.
Esto incluye una forma de trabajar. El equipo que prepara los datos, quien entrena el modelo y quien mantiene el servicio necesitan acordar qué significa que el sistema funcione bien. En nuestra tienda, reducir el error de predicción importa, pero también importa que el pedido llegue a tiempo y que el modelo no provoque compras desproporcionadas. Debe haber una persona o equipo responsable de actuar ante una incidencia.
MLOps toma de DevOps el control de versiones, las pruebas automatizadas y la colaboración entre desarrollo y operaciones. Añade una dificultad: parte del comportamiento del software se aprende de los datos. El mismo código, entrenado con otra información, puede generar un modelo distinto. Además, el entorno puede cambiar sin que nadie haya modificado la aplicación.
Por eso, las pruebas de software siguen siendo necesarias, pero deben acompañarse de controles sobre datos y calidad predictiva. Un servicio puede responder rápido y devolver resultados equivocados. La guía de arquitectura MLOps de Google Cloud sitúa precisamente esas validaciones y la monitorización dentro del proceso de desarrollo y operación.
El ciclo empieza antes del entrenamiento
Volvamos a la tienda. Antes de elegir un algoritmo hay que decidir qué se quiere predecir, con cuánto tiempo de antelación y qué información estará disponible al hacer el pedido. Si entrenamos usando datos que solo conoceremos después de la venta, las pruebas ofrecerán una impresión engañosa del rendimiento. Es la llamada fuga de información o data leakage.
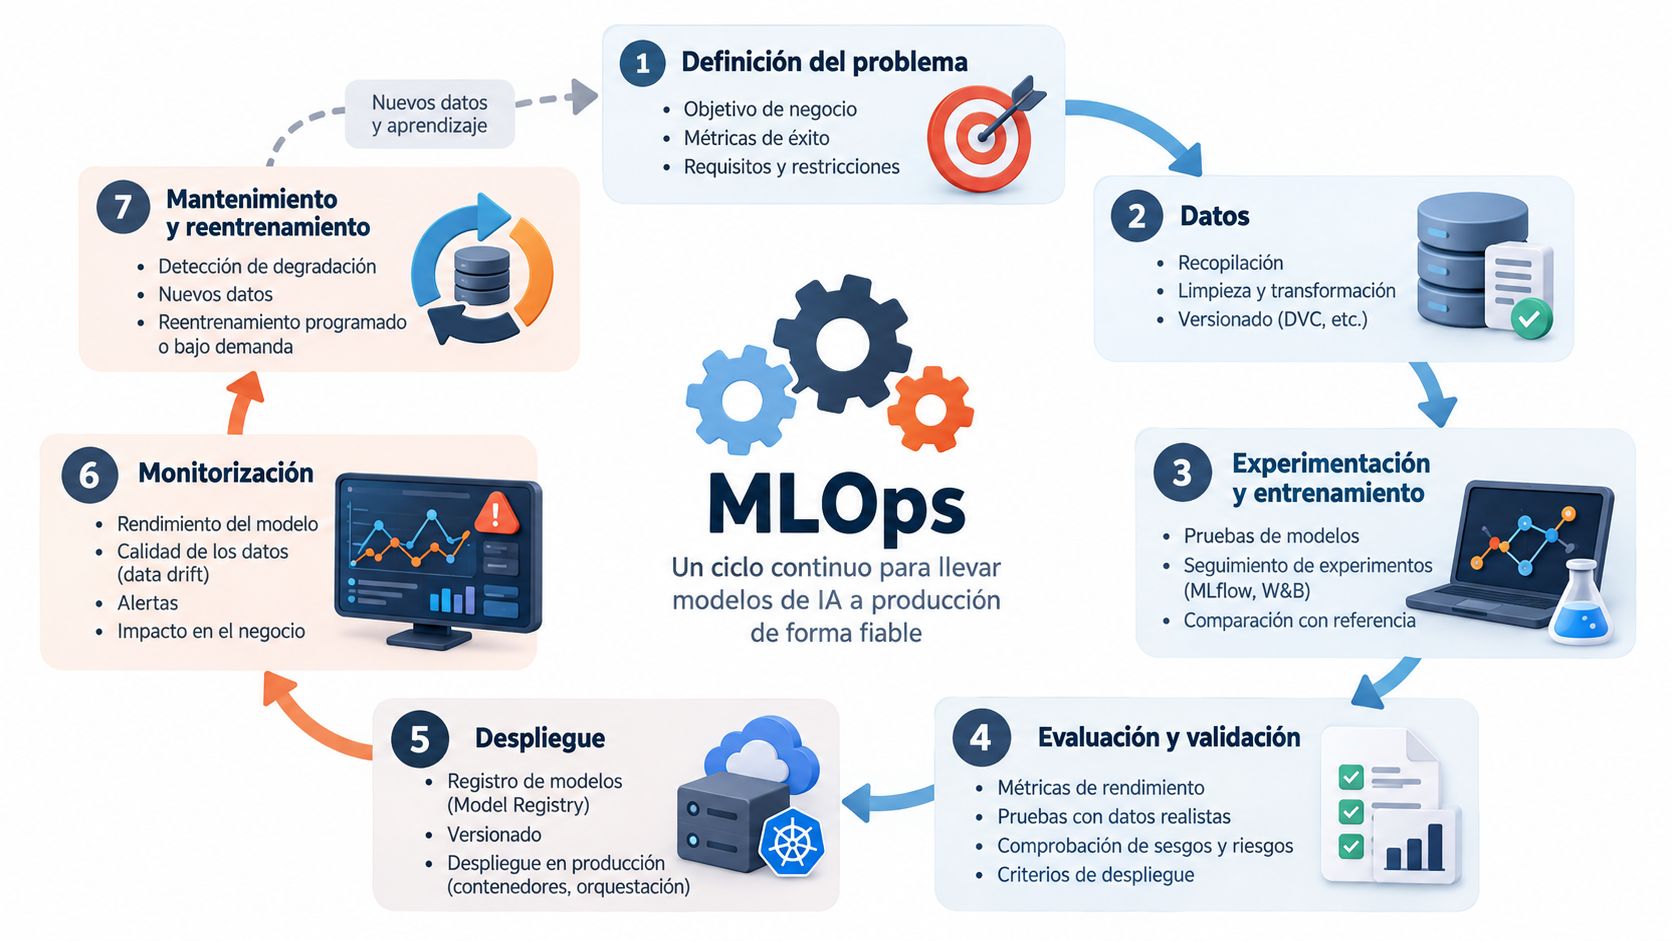
Con el problema definido, el trabajo conecta la preparación de datos con la experimentación, el entrenamiento y la evaluación. El modelo candidato se compara con una referencia sencilla o con la versión que ya está en uso. Si cumple los requisitos, se registra y se despliega. Las predicciones y los resultados reales permiten después revisar su comportamiento y decidir si conviene corregir los datos, cambiar el modelo o reentrenarlo.
No todas las vueltas de ese ciclo terminan en un nuevo despliegue. Un entrenamiento puede fallar las pruebas, y una alerta puede descubrir un problema en el origen de los datos. Esa posibilidad de detenerse es parte del diseño.
Poder reconstruir un resultado
Git guarda el historial del código y la configuración. Para relacionarlo con archivos grandes de datos o modelos, DVC mantiene referencias versionadas mientras los archivos se conservan en un almacenamiento separado. Así podemos identificar qué conjunto de datos corresponde a una revisión del proyecto sin introducirlo entero en el repositorio de Git.
La necesidad de identificar los datos existe desde el primer modelo. DVC es una opción; también pueden servir instantáneas inmutables o versiones de tablas, según la plataforma utilizada. Guardar únicamente una consulta a una base de datos que cambia no permite reconstruir necesariamente el conjunto original.
Durante la experimentación, MLflow Tracking registra parámetros, métricas y artefactos, como modelos o gráficos. Pesos y sesgos permite seguir y comparar ejecuciones con visualizaciones compartidas. Ambas herramientas ayudan a responder una pregunta cotidiana: qué configuración produjo aquel resultado que parecía tan bueno.
Para reproducir el entrenamiento también hay que conservar las dependencias, las transformaciones y las condiciones relevantes de ejecución. Fijar una semilla aleatoria ayuda, aunque no garantiza resultados idénticos con cualquier hardware o biblioteca.
Cuando elegimos un candidato, un registro de modelos organiza sus versiones y las vincula con su procedencia. El Model Registry de MLflow, por ejemplo, ofrece versiones, etiquetas y alias. Ese registro debe conectarse con el historial de despliegues: marcar una versión como aprobada no demuestra por sí solo que sea la que está atendiendo peticiones.
Validar algo más que una métrica
En una predicción de demanda, conviene evaluar con una separación temporal que respete el orden de los acontecimientos. El modelo debe enfrentarse a periodos posteriores a aquellos de los que aprendió. También interesa revisar resultados por tienda o categoría: una mejora media puede esconder errores graves en los productos menos vendidos.
La validación incluye las entradas esperadas, los valores ausentes y la coherencia de las transformaciones entre entrenamiento e inferencia, es decir, el momento de producir predicciones. Si durante las pruebas calculamos las ventas de los últimos siete días de una forma y en producción lo hacemos de otra, el modelo recibirá información diferente de la que aprendió a interpretar.
Cuando muchas aplicaciones comparten variables, un feature store puede ayudar a gestionarlas. Feast, por ejemplo, facilita el acceso a características históricas para entrenamiento y a valores recientes para inferencia. Su utilidad crece cuando hay que reutilizar esas variables y controlar su coherencia; para un único modelo, un proceso de transformación compartido y bien probado puede ser suficiente.
Automatizar el proceso con criterios de parada
Un pipeline es un flujo de tareas con dependencias: no tiene sentido evaluar un modelo antes de entrenarlo ni entrenar con datos que no han superado los controles de calidad. La orquestación añade programación, seguimiento de ejecuciones y gestión de fallos.
Apache Airflow encaja en flujos por lotes con tareas y dependencias definidas. Prefect permite organizar flujos en Python con seguimiento y reintentos. Kubeflow Pipelines está orientado a flujos de ML compuestos por pasos contenerizados, especialmente en entornos Kubernetes. Son alternativas con distintos encajes; no hace falta instalar las tres.
La integración continua, o CI, comprueba los cambios del proyecto mediante pruebas. Con una herramienta como GitHub Actions, una modificación puede activar pruebas del código, verificar transformaciones y construir el paquete que se desplegará. La entrega continua prepara versiones que pueden publicarse tras una aprobación; el despliegue continuo automatiza también ese último paso. Ambas prácticas suelen agruparse bajo las siglas CD.
En ML aparece además el entrenamiento continuo, o CT: ejecutar de forma repetible el entrenamiento cuando se cumple una condición, como disponer de nuevos datos validados. «Continuo» no significa entrenar sin descanso ni sustituir automáticamente el modelo que está en uso.
Para nuestra tienda, el flujo podría ejecutarse cada semana, comprobar la calidad de los datos y comparar un candidato con la versión actual. Si empeora demasiado en una categoría importante, se detiene. Si supera las pruebas, queda disponible para aprobación. Los umbrales y la intervención humana dependen del impacto de un error y deben definirse antes de automatizar la decisión.
La infraestructura depende de cómo se utilizará el modelo
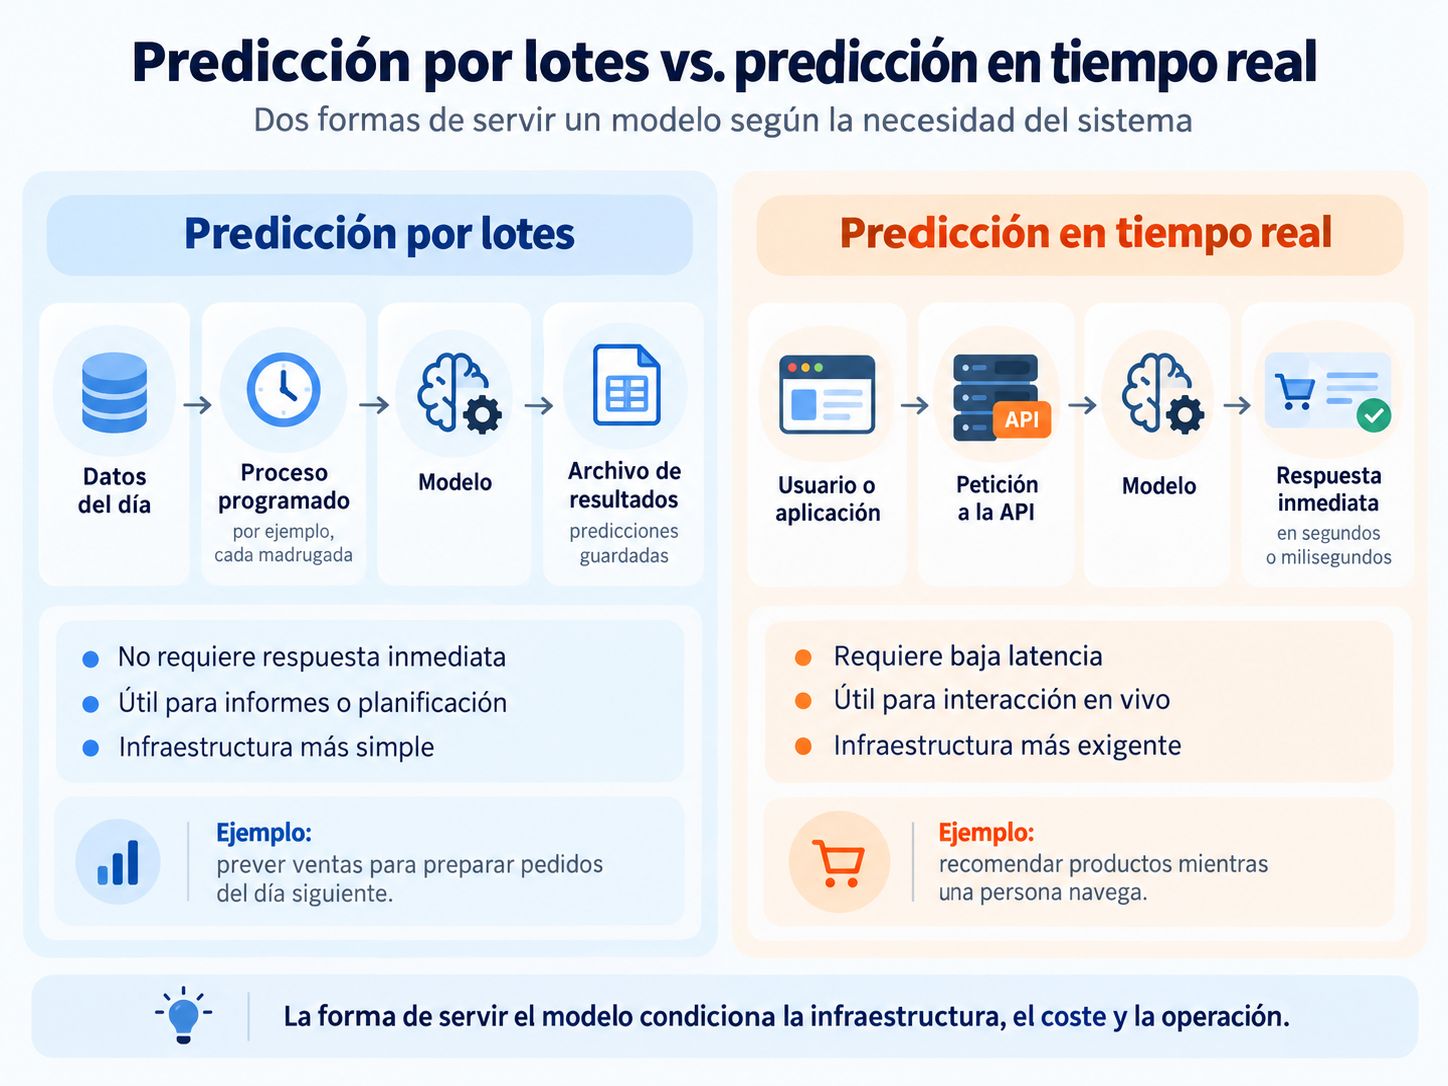
Una predicción diaria para preparar pedidos puede ejecutarse por lotes: el proceso calcula los resultados, los guarda y termina. Un sistema que recomienda productos mientras alguien navega necesita responder a cada petición con poca latencia. Otros modelos se ejecutan dentro de un dispositivo, cerca del lugar donde se capturan los datos.
Esta diferencia determina buena parte de la infraestructura. Mantener una API encendida permanentemente no aporta demasiado si solo necesitamos un archivo de predicciones cada madrugada.
Para un servicio sencillo, FastAPI puede exponer una interfaz que reciba entradas y devuelva predicciones. Docker empaqueta la aplicación y sus dependencias en un contenedor, reduciendo diferencias entre entornos. El modelo puede incluirse en la imagen o recuperarse de un almacenamiento versionado. En ambos casos hay que identificar exactamente qué versión se carga; las dependencias del sistema y los controladores de GPU siguen requiriendo atención.
Kubernetes administra aplicaciones contenerizadas distribuidas: mantiene réplicas, reemplaza contenedores que fallan y permite configurar el escalado. Sobre esa base, KServe añade capacidades especializadas para servir modelos. Esa infraestructura resulta útil cuando hay necesidades de escala y un equipo capaz de operarla. Un servicio gestionado o una máquina virtual pueden cubrir un proyecto más pequeño.
Por debajo están las redes, el almacenamiento, los permisos y los recursos de cómputo. Terraform permite describir infraestructura mediante archivos versionados, revisar cambios y crear entornos de forma consistente. Las credenciales requieren un sistema de gestión de secretos; no deben quedar dentro del repositorio ni de las imágenes.
También hay que diseñar cómo cambiar de versión. Un despliegue canary envía una parte del tráfico al candidato antes de ampliarlo. En modo shadow, el candidato recibe una copia de las peticiones y sus resultados se observan sin usarlos para decidir. Ambas estrategias ayudan a comprobar el comportamiento real. La vuelta atrás, o rollback, debe recuperar una combinación compatible de modelo, código y transformaciones, no únicamente un archivo de pesos.
Monitorizar cuando el servidor dice que todo va bien
La monitorización de infraestructura observa disponibilidad, errores, tiempos de respuesta y consumo de recursos. Prometheus recoge métricas y permite definir alertas; herramientas de visualización como Grafana ayudan a explorarlas. En un sistema de ML hace falta mirar además la calidad de las entradas y de las predicciones.
Un cambio en la distribución de los datos de entrada se conoce como data drift. Por ejemplo, una promoción puede aumentar la proporción de compras de cierto producto. El concept drift describe un cambio en la relación entre las entradas y aquello que intentamos predecir: unas señales que antes anticipaban bien la demanda pueden dejar de hacerlo. Son fenómenos relacionados, pero no equivalentes. Evidently explica esta distinción y sus implicaciones para la detección.
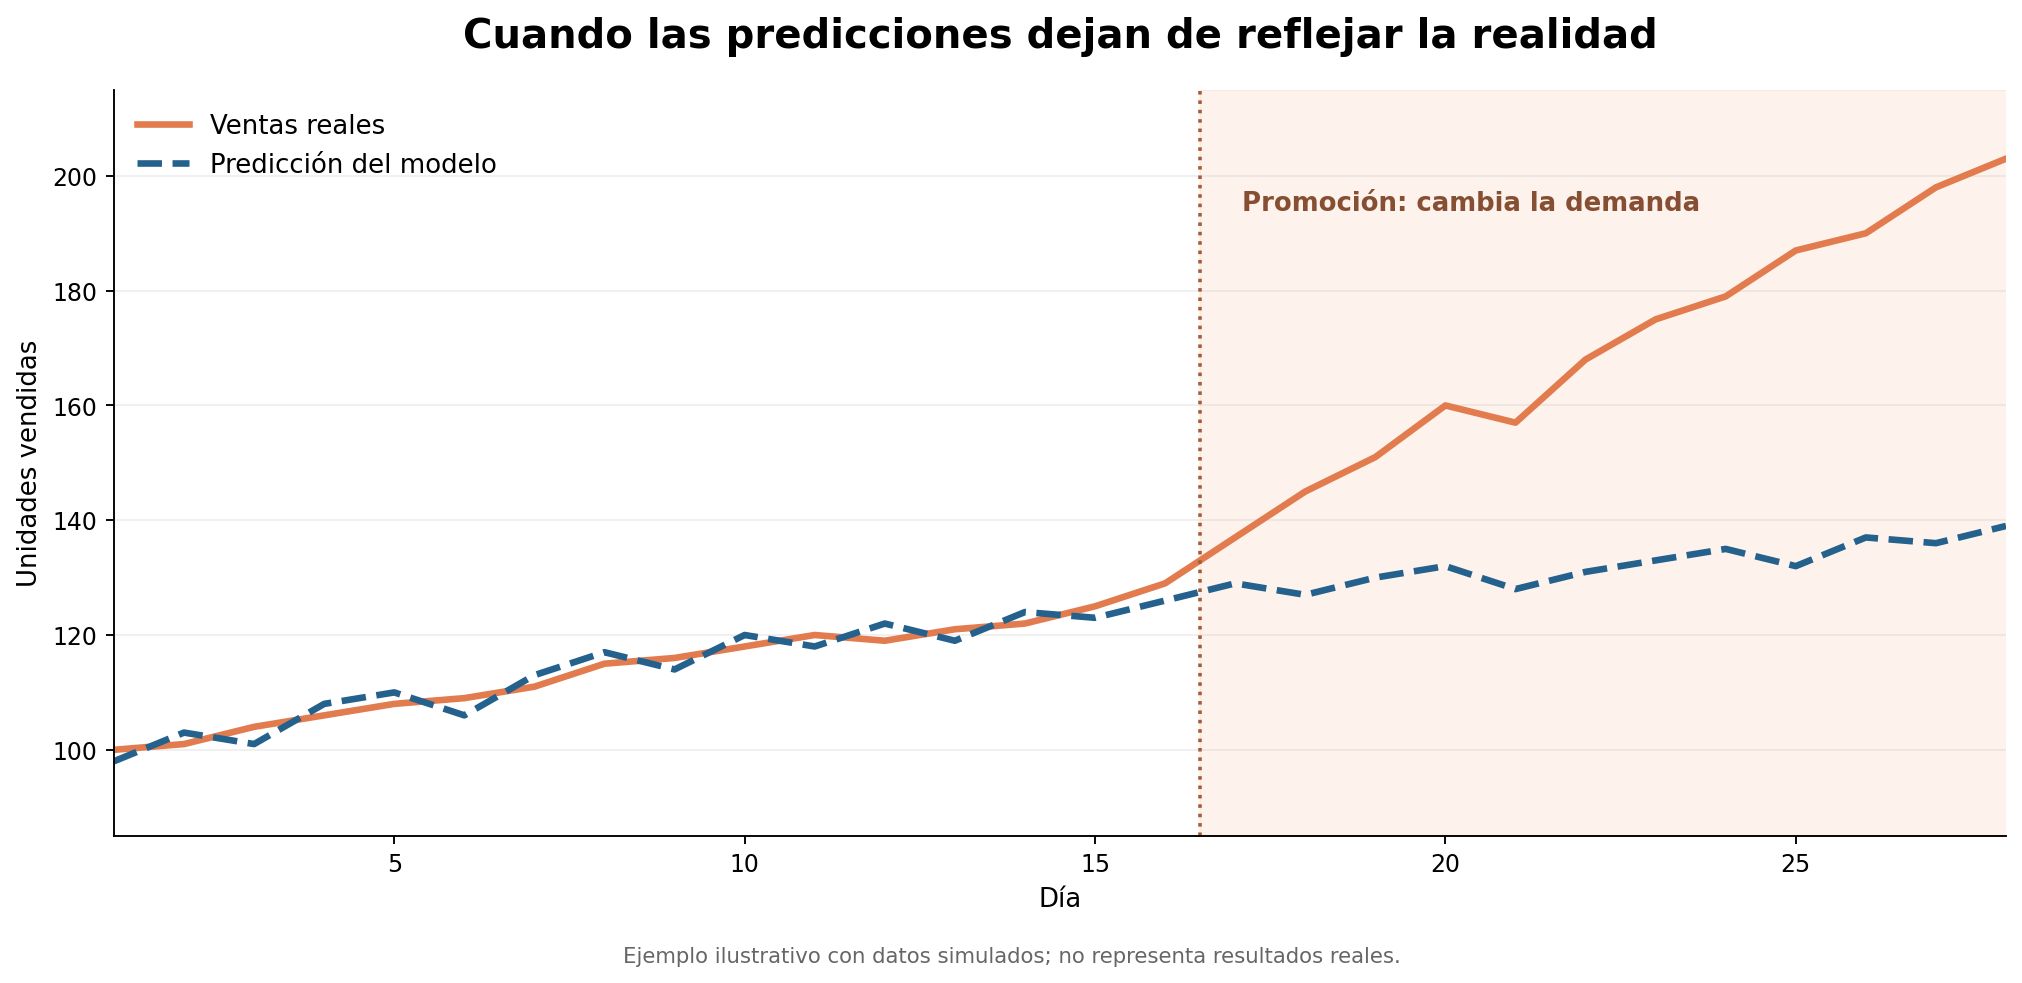
Evidently permite comparar datos actuales con una referencia para detectar cambios de distribución. Una alerta de drift es una señal que investigar: no demuestra por sí sola que el modelo haya empeorado. Tampoco la ausencia de drift garantiza predicciones correctas.
Para medir el error necesitamos conocer el resultado real. En nuestro ejemplo habrá que esperar a las ventas y considerar que quedarse sin existencias puede ocultar demanda. Esa demora obliga a combinar señales tempranas, como datos ausentes o valores extraños, con evaluaciones posteriores de calidad.
La observabilidad conecta estas señales con registros de ejecución y versiones para poder explicar un incidente. Una alerta útil debería indicar qué ha cambiado, a qué parte del sistema afecta y quién debe revisarlo. Si el problema es un sensor averiado o una columna mal calculada, reentrenar automáticamente puede consolidar el error. Primero se diagnostica; después se decide la respuesta.
Cloud y costes de mantener el sistema
Las plataformas cloud reúnen muchas de estas piezas. Amazon SageMaker AI ofrece servicios gestionados para construir, entrenar y desplegar modelos; es el nombre actual del servicio antes denominado Amazon SageMaker, hoy integrado en una plataforma más amplia. Azure Machine Learning cubre el ciclo de trabajo con recursos de entrenamiento, pipelines y despliegue.
En Google Cloud, el ecosistema conocido como Vertex AI ha evolucionado hacia Gemini Enterprise Agent Platform. La documentación oficial de cambios de nombre recoge esa transición, que abarca servicios de entrenamiento, pipelines, registro e inferencia. Conviene reconocer ambas denominaciones al consultar tutoriales y proyectos existentes.
Estas plataformas reducen el trabajo de integrar y mantener componentes, pero el equipo sigue siendo responsable de los datos, las evaluaciones y las decisiones de publicación. La elección depende también de la infraestructura ya disponible, los requisitos de acceso y la facilidad para trasladar modelos y procesos a otro entorno.
Comparar costes exige mirar más allá del precio de una máquina. Importan las horas de cómputo, los servicios que permanecen activos sin recibir peticiones, el almacenamiento, las transferencias y la observabilidad. Operar herramientas propias también consume tiempo de ingeniería. Un servicio gestionado puede resultar más económico en conjunto aunque alguna de sus tarifas sea mayor.
En la tienda, ejecutar las predicciones por lotes y apagar los recursos al terminar puede ser una decisión más valiosa que optimizar unos milisegundos de inferencia. Para otros sistemas será imprescindible mantener capacidad disponible. Conviene medir el coste por unidad útil, como mil predicciones o una tarea completada, junto con la calidad y la latencia.
LLMOps y agentes amplían lo que debemos controlar
Las aplicaciones generativas introducen otra situación: el equipo puede usar un modelo externo mediante una API sin entrenarlo. Aun así, debe evaluar cambios y controlar su funcionamiento. LLMOps aplica estos principios a sistemas basados en grandes modelos de lenguaje.
Pensemos ahora en un asistente que explica las previsiones de ventas consultando documentación de la empresa. Si usa RAG, o generación aumentada por recuperación, primero busca información relevante y después la aporta al modelo como contexto. El resultado dependerá del modelo, pero también de las instrucciones, los documentos recuperados y la configuración de búsqueda.
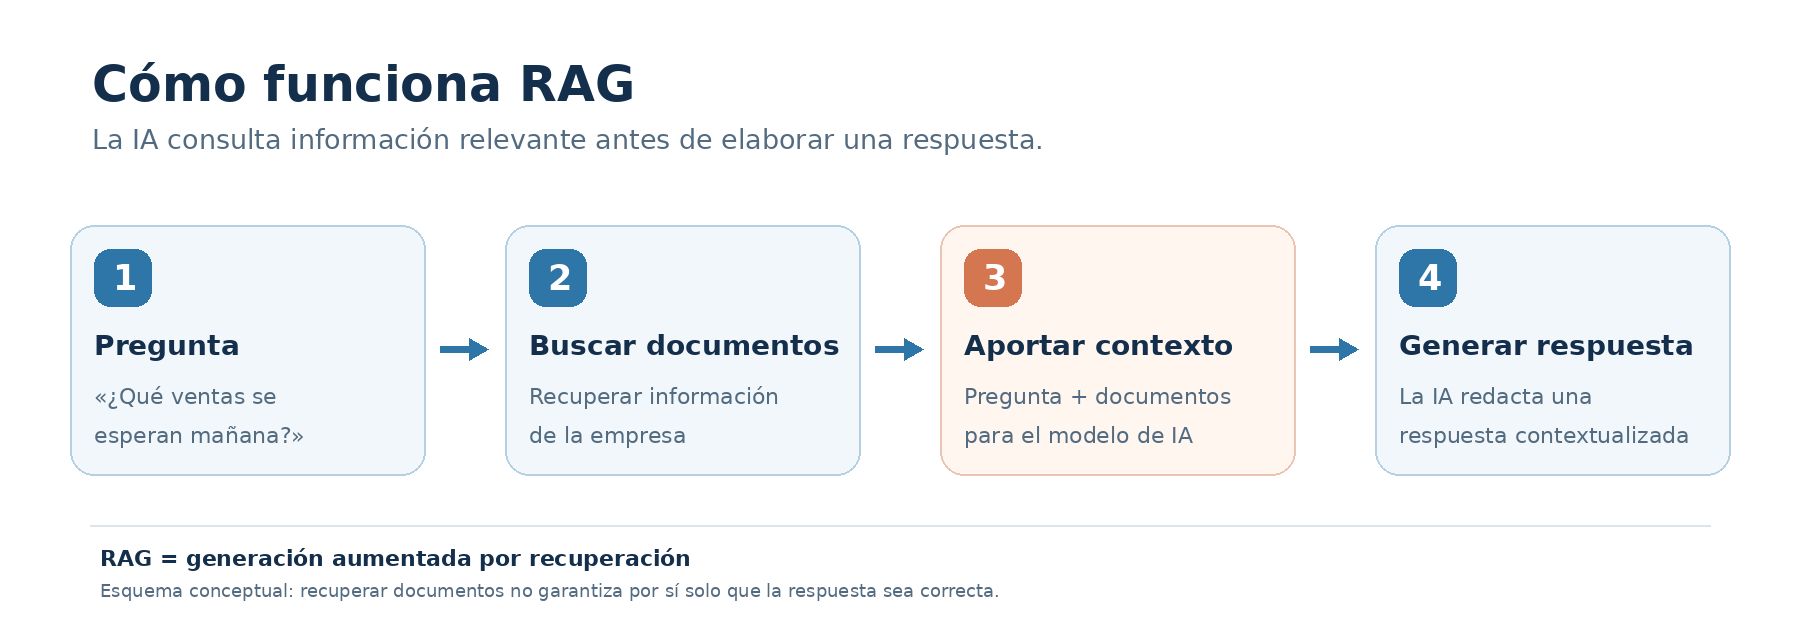
Por eso hay que versionar esos componentes, incluidos el conjunto de evaluación y, cuando corresponda, el índice y el modelo de embeddings que transforma documentos en representaciones numéricas para buscarlos. Si una respuesta contiene un dato falso, necesitamos distinguir entre una recuperación equivocada y una generación que se apartó de las fuentes. Cambiar el modelo no resolverá necesariamente un problema de documentos desactualizados.
La ampliación de las herramientas ya es visible: MLflow incorpora gestión de prompts, evaluación y trazas para aplicaciones generativas y agentes. Una traza registra los pasos observables de una ejecución, como llamadas al modelo, consultas y uso de herramientas, con sus tiempos y resultados. Permite localizar dónde falla el flujo; no equivale a conocer el razonamiento interno del modelo.
Evaluar respuestas y también acciones
La evaluación debe partir de tareas representativas. En el asistente de ventas interesa comprobar si recupera el documento adecuado, si respalda sus afirmaciones y si reconoce que le falta información. Las pruebas previas al despliegue pueden complementarse con evaluaciones sobre una muestra de interacciones reales. LangSmith documenta ambos flujos y cómo convertir fallos de producción en nuevos casos de prueba.
Las reglas automáticas sirven para verificar formatos o condiciones concretas. Los evaluadores basados en otros modelos ayudan a valorar respuestas abiertas, pero también pueden equivocarse: sus criterios necesitan contrastarse con revisión humana. La documentación de evaluación de LangSmith aborda estas distintas formas de evaluar.
Si el asistente puede crear un pedido, hablamos además de un agente que actúa sobre otros sistemas. Una respuesta bien redactada no garantiza que haya elegido el producto correcto o respetado los permisos. Hay que observar las llamadas a herramientas, limitar los pasos y el gasto, y exigir aprobación para acciones de impacto cuando el caso lo requiera. Los reintentos deben evitar pedidos duplicados.
En estas aplicaciones, los costes pueden acumularse en varias llamadas por tarea. La longitud del contexto, los reintentos y las evaluaciones también cuentan. Probar modelos más pequeños, reutilizar resultados cuando sea válido o reducir llamadas innecesarias permite buscar un equilibrio medible entre calidad, tiempo y coste.
Una arquitectura que el equipo pueda mantener
Para un primer modelo de demanda, una base razonable puede ser Git, datos identificables y recuperables, seguimiento de experimentos y un proceso de predicción por lotes. Desde el inicio hacen falta validaciones, una forma de detectar fallos y un procedimiento para recuperar una versión anterior. El grado de sofisticación puede crecer después.
Cuando se multiplican los entrenamientos o los modelos, aparecen razones concretas para añadir un orquestador, un registro compartido o una plataforma de despliegue. Si muchos equipos repiten la misma configuración, la ingeniería de plataformas puede ofrecer caminos comunes para entrenar y publicar con permisos, registros y controles ya preparados.
La gobernanza se incorpora a ese trabajo diario: documentar el uso previsto y los límites del modelo, conservar su procedencia, controlar accesos y registrar aprobaciones. También implica decidir qué datos se guardan en las trazas y durante cuánto tiempo. Registrar todo sin criterio puede exponer información sensible y encarecer la operación.
Conseguir que el modelo siga siendo útil
El éxito del modelo de nuestra tienda se comprobará en los pedidos de los próximos meses, bajo promociones, cambios de temporada y errores de datos. MLOps proporciona los medios para observar ese comportamiento y modificar el sistema sin perder la capacidad de explicar qué ocurrió.
Las herramientas elegidas pueden cambiar. Lo que necesita permanecer es la conexión entre la versión publicada, la evidencia que justificó publicarla y las señales que indican si sigue funcionando. Para un proyecto que sale del notebook, ese es un buen punto de partida: poder reconstruir el resultado, detectar un fallo y responder a él. Sobre esa base puede crecer una infraestructura que acompañe al modelo durante su vida real.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 31 oct 2026.
← Más historias de la comunidad