HUMANDS: inteligencia artificial para estudiar la rotación laboral
HUMANDS explora la predicción de la salida de empleados mediante machine learning y analiza cómo cambian las estimaciones al modificar los datos de entrada.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
Donostia. 2021
Inteligencia Artificial para empleados
Bilbao 2021. Pablo Martín García (pablo) y Omar Calderón (Omar Calderon). Las técnicas de inteligencia artificial aplicadas a empleados cubren una creciente necesidad dado lo costoso en tiempo y dinero que es conseguir buenos colaboradores para las empresas, además de eso la formación que tienen que darles para su buen desempeño dentro de la organización. Por ello, retener estos talentos se ha vuelto un gran reto y a la vez una necesidad, que no esta siendo nada fácil de enfrentar, las personas hoy en día ya no tienden a quedarse donde no están cómodas y no se sientan valoradas.
Las altas rotaciones de empleados se han vuelto normales en muchas empresas. Como ejemplo, en los sectores tecnológico y turístico, 75% de sus empleados a pesar de tener un puesto fijo, están en búsqueda activa de nuevas ofertas. Lo que representa un gran problema en términos de costes, ambiente laboral y eficiencia. Cuando se tiene un entorno laboral así, los otros empleados tienden a hacer lo mismo, ya que eso da sensación de inestabilidad y provoca atrasos en el trabajo.
Actualmente, uno de los problemas más graves a los que se enfrentan las empresas es la fuga de talento. Y, aunque esta migración de talento humano afecta a todas las empresas y todos los sectores, a día de hoy, en nuestro país, los sectores que se ven más perjudicados por este motivo son el tecnológico y el turístico. Según varias encuestas realizadas a lo largo de 2020, más del 75% de los empleados de estos sectores afirma que, a pesar de tener un puesto de trabajo, sigue buscando activamente otras ofertas de empleo, problema que intentaremos abordar con técnicas de inteligencia artificial.(https://interimgrouphr.com/blog/gestion-talento/fuga-talento-causas-soluciones/)
Actualmente en España 9 de cada 10 empleados no se sienten cómodos en su actual puesto de trabajo y esto hace que las organizaciones tengan que replantearse estrategias para mejorar las condiciones de sus colaboradores, pero los criterios para mejorar las mismas no deben ser elegidos por intuición, como se ha hecho toda la vida, lo que ha llevado a estos resultados actuales.
Uno de los motivos por los que las organizaciones pierden a sus empleados es la insatisfacción laboral. Por desgracia y según los datos que maneja Bizneo HR, casi 9 de cada 10 españoles son infelices en su puesto de trabajo. Y, ¿cuáles son las razones de este descontento? Entre otros, la imposibilidad de prosperar en la compañía y la dificultad para conciliar entre vida laboral y familiar. Principalmente.(https://www.bizneo.com/blog/como-evitar-la-fuga-de-talentos-en-tu-empresa/)
Objetivos:
- Estimar la probabilidad de salida de empleados a partir de los datos del proyecto mediante inteligencia artificial.
- Explorar información que pueda ayudar a plantear mejoras en las condiciones laborales y nuevas preguntas sobre retención de talento.
Datos:
IBM HR Analytics Employee Attrition & Performance
Utilizamos IBM HR Analytics Employee Attrition & Performance, un conjunto de 1.470 perfiles con variables como edad, remuneración y satisfacción laboral. Es un recurso para experimentar con modelos; este análisis no permite extraer conclusiones sobre la plantilla real de IBM.
Exploración de datos:
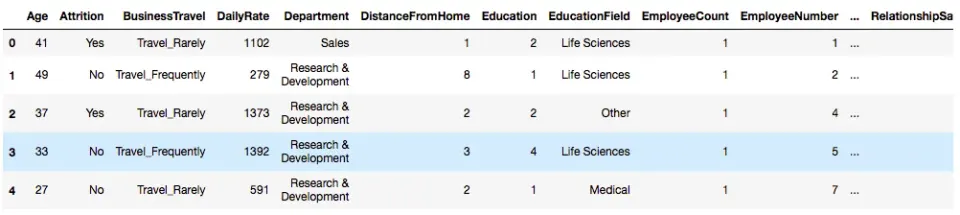
Vistazo a las primeras filas:
Descripción de columnas:
AGE: Valor numérco
ATTRITION: salida del empleado de la empresa (0=no, 1=sí). No mide desgaste emocional.
BUSINESS TRAVEL: (1=No viaje, 2=Viaja frecuentemente, 3=Viaja ocacionalmente)
DAILY RATE: Valor numérico — Nivel salarial
DEPARTMENT: (1=RRHH, 2=I&D, 3=Ventas)
DISTANCE FROM HOME: Valor numérico — Distancia desde casa
EDUCATION: Valor numérico
EDUCATION FIELD: (1=RRHH, 2=Ciencias, 3=Marketing, 4=Ciencias Médicas, 5=Otros, 6=Técnico)
EMPLOYEE COUNT: Valor numérico
EMPLOYEE NUMBER: Valor numérico — ID del Empleado
ENVIROMENT SATISFACTION: Valor numérico — Satisfacción con el ambiente
GENDER: (1=Femenino, 2=Masculino)
HOURLY RATE: Valor numérico — Salario por hora
JOB INVOLVEMENT: Valor numérico — Involucramiento en el trabajo
JOB LEVEL: Valor numérico — Nivel de trabajo
JOB ROLE: (1=Recepción, 2=RRHH, 3=LAB Técnico, 4=Manager, 5= Director de Gerencia, 6= Director de Investigación, 7= Científico de Investigación, 8=Ejecutivo de Ventas, 9= Representante de Ventas)
JOB SATISFACTION: Valor numérico — Satisfacción con el Trabajo
MARITAL STATUS: (1=Divorciado, 2=Casado, 3=Soltero)
MONTHLY INCOME: Valor numérico — Salario Mensual
MONTHY RATE: Valor numérico — Ratio Mensual
NUMCOMPANIES WORKED: Valor numérico — Número de Empresas Trabajadas
OVER 18: (1=Si, 2=No)
OVERTIME: (1=No, 2=Si)
PERCENT SALARY HIKE: Valor numérico — Porcentaje de Incremento Salarial
PERFORMANCE RATING: Valor numérico — Ratio de Desempeño
RELATIONS SATISFACTION: Valor numérico — Satisfacción de Relaciones
STANDARD HOURS: Valor numérico — Horas Estándar
STOCK OPTIONS LEVEL: Valor numérico — Opciones de Participaciones
TOTAL WORKING YEARS: Valor numérico — Total de Años Trabajados
TRAINING TIMES LAST YEAR: Valor numérico — Horas de Entrenamiento
WORK LIFE BALANCE: Valor numérico — Equilibrio Vida Laboral — Personal
YEARS AT COMPANY: Valor numérico — Total de Años en la Empresa
YEARS IN CURRENT ROLE: Valor numérico — Años en el Puesto Actual
YEARS SINCE LAST PROMOTION: Valor numérico — Última Promoción
YEARS WITH CURRENT MANAGER: Valor numérico — Años con el Gerente Actual
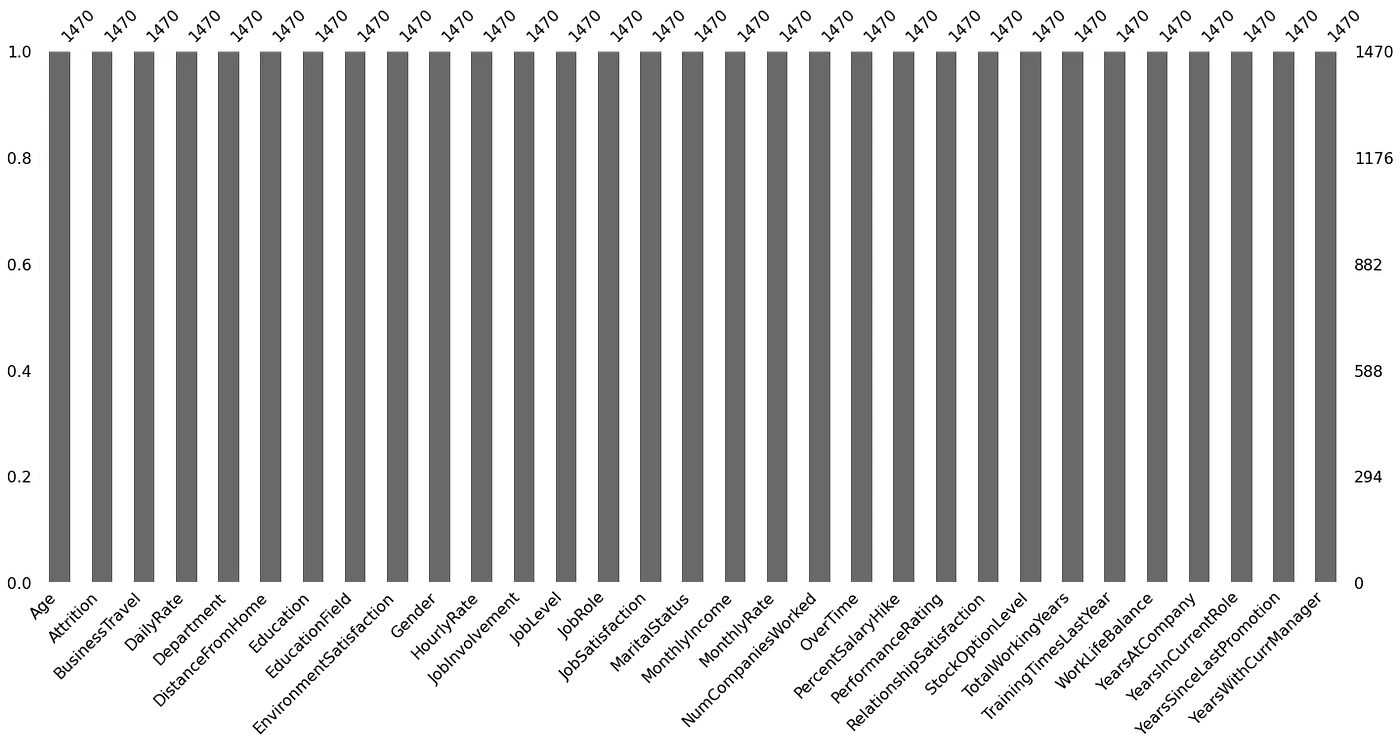
No existen valores nulos en el dataset:
Matriz de correlaciones:
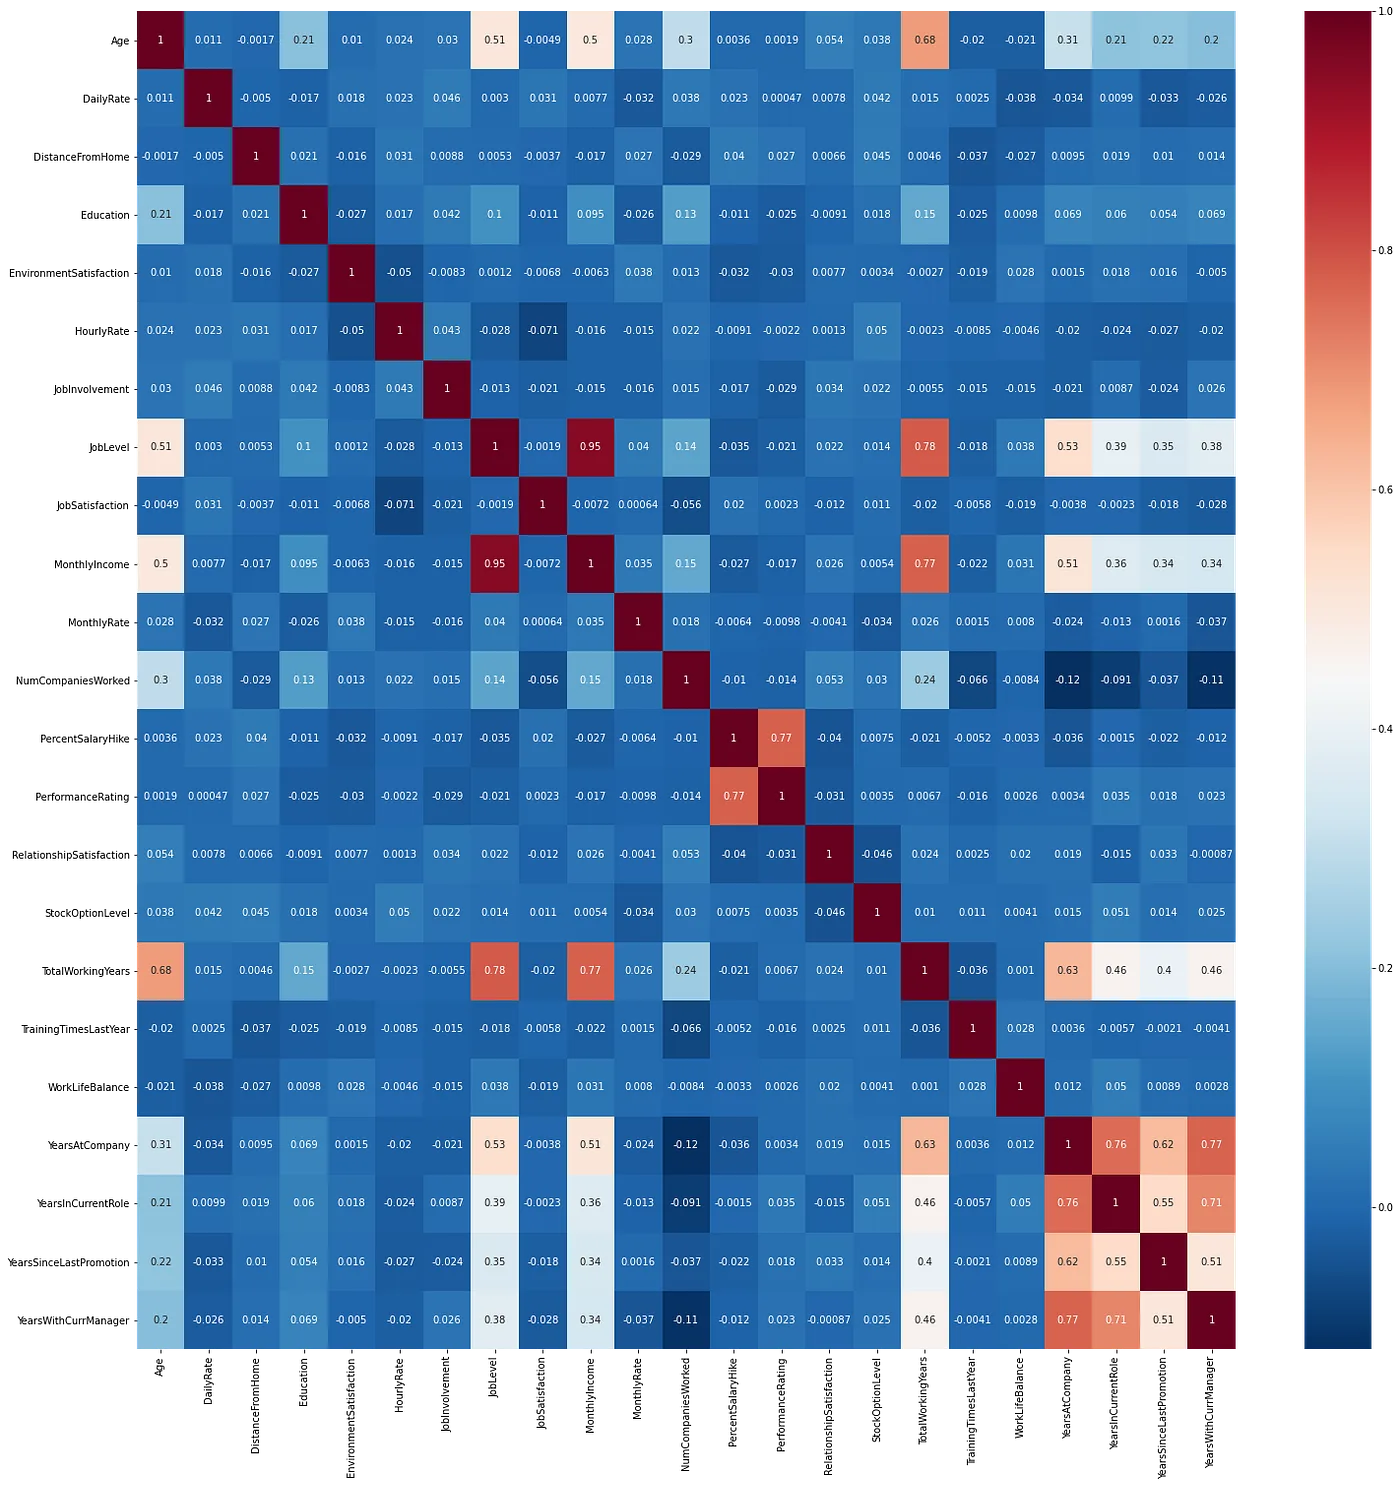
Matriz de correlaciones
Como podemos ver, dentro de la matriz, las variables que más correlacionas tienen entre sí son las variables relacionadas con tiempo, como la cantidad de años de experiencia, edad, etc. Entre sí y con variables como salario y nivel del puesto de trabajo.
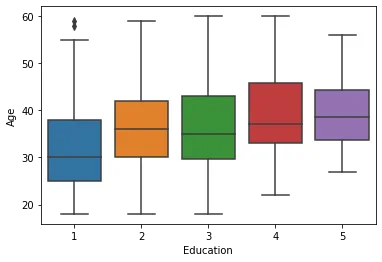
Nivel de educación y edad
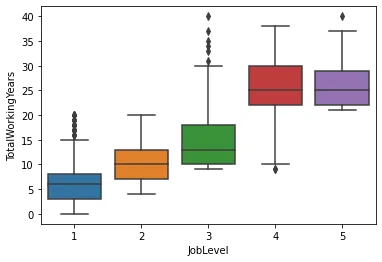
Años de experiencia y nivel de trabajo
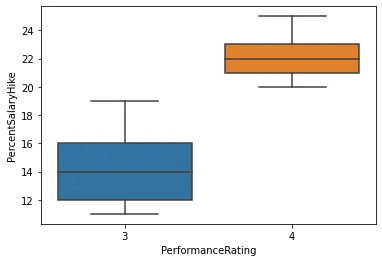
Ratio de desempeño y subida de salario
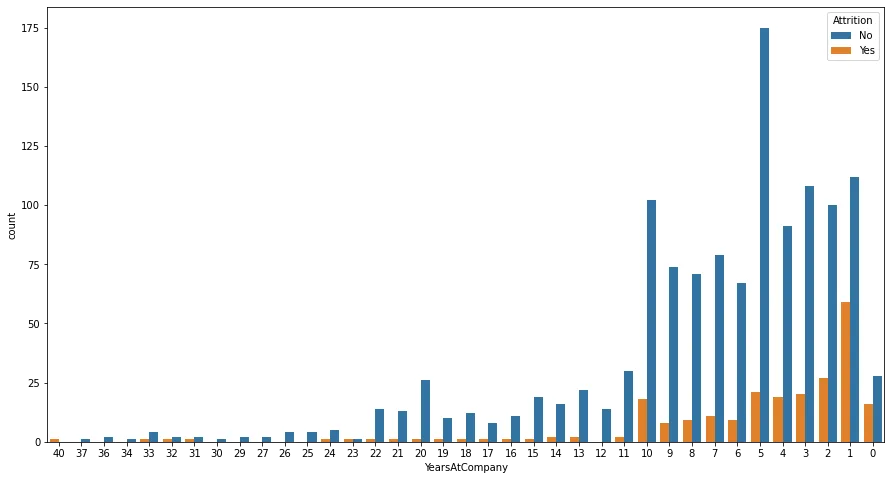
El siguiente gráfico muestra las salidas de empleados según su antigüedad, desde quienes llevan 40 años en la empresa hasta quienes acaban de incorporarse.
Features engineering:
Vamos a trabajar profundamente con nuestra variable dependiente que en este caso sería Attrition. Esta variable es binaria y toma los valores YES y NO. En lugar de limitarnos a una etiqueta, queremos obtener la probabilidad de salida que estima el modelo. Compararemos varios clasificadores para ver cuál funciona mejor con estos datos. Esta probabilidad no mide el desgaste emocional ni el estado de salud de una persona.
RandomForestClassifier {0: {'train_time': 0.4280989170074463, 'pred_time': 0.05773425102233887, 'acc_train': 1.0, 'acc_test': 0.9271255060728745, 'f_train': 1.0, 'f_test': 0.923076923076923}}
AdaBoostClassifier {0: {'train_time': 0.36793017387390137, 'pred_time': 0.08242297172546387, 'acc_train': 0.9259634888438134, 'acc_test': 0.9109311740890689, 'f_train': 0.9255102040816326, 'f_test': 0.9083333333333333}}
GaussianNB {0: {'train_time': 0.008366107940673828, 'pred_time': 0.025140047073364258, 'acc_train': 0.8078093306288032, 'acc_test': 0.771255060728745, 'f_train': 0.8265446224256293, 'f_test': 0.7911275415896488}}
Basándonos en el resultado del accuracy_test, vamos a continuar trabajando con Random Forest Classifier, que además de haber tenido mejor rendimiento, consta con las características de Feature Importances y predict_proba
Utilizando Feature Importances podemos apreciar cuales son las variables que según el modelo son las que más influyen en su predicción.
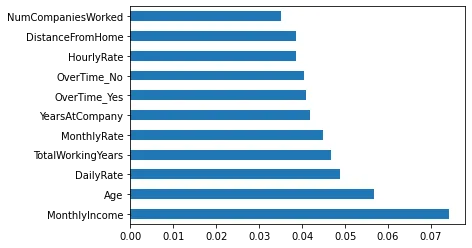
Feature Importances by Random Forest Classifier
Ampliación del dataset:
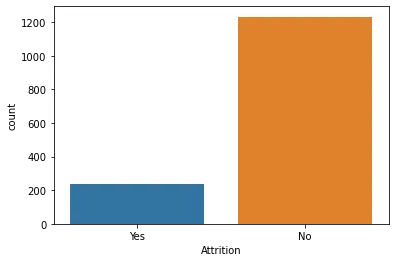
Yes 16%, No 84%
El conjunto está desbalanceado: el 16 % de las 1.470 filas corresponde a salidas de empleados. Utilizamos SMOTE para generar ejemplos sintéticos de la clase minoritaria. El sobremuestreo debe aplicarse solo al conjunto de entrenamiento; equilibrar las clases no garantiza por sí solo que el modelo sea más preciso o esté libre de sesgos.
Forma de X antes de SMOTE: (1470, 51)
Shape of X after SMOTE: (2466, 51)
Saldo de clases positivas y negativas (%):
No 50.0
Yes 50.0
Después de entrenar el modelo Random Forest Classifier con el dataset ampliado, vamos a ver cuales son sus predicciones en probabilidades para cada columna de nuestro dataset.
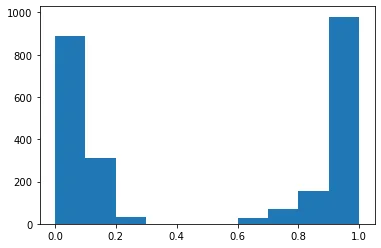
Probabilidad estimada de salida, de 0 a 1
0 0.72
1 0.03
2 0.93
3 0.20
4 0.08
...
2461 0.99
2462 1.00
2463 0.99
2464 0.99
2465 0.95
Las probabilidades estimadas permiten comparar cómo responde el modelo al modificar las variables de cada perfil. Esto es un análisis de sensibilidad del modelo: no demuestra que cambiar el salario o las condiciones de trabajo cause una reducción real de las salidas.
Exploración de posibles cambios en las condiciones laborales
En esta parte estamos tomando en cuenta las variables en las cuales la empresa puede intervenir directamente, como salario, sobretiempos, etc. Las que son personales no, porque ya requeriría de consentimientos de terceros o gestiones más complejas.
En el primer experimento modificamos los salarios de entrada en un 10, 20, 30, 40, 50, 60, 70, 80 y 90 % para observar cómo cambian las probabilidades estimadas por el modelo.
Los siguientes histogramas muestran cómo cambian las predicciones al aumentar el salario en los datos de entrada.
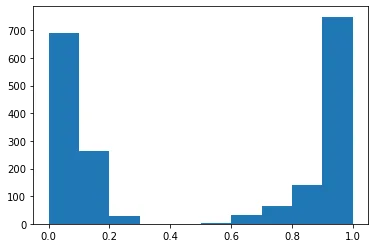
Incremento de 10% de Monthly Income
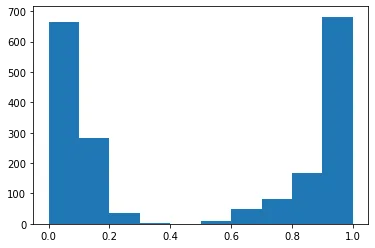
Incremento de 20% de Monthly Income
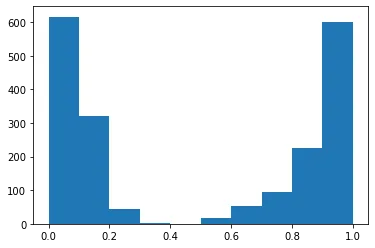
Incremento de 30% de Monthly Income
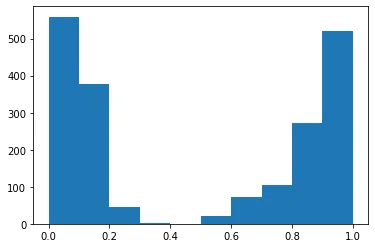
Incremento de 40% de Monthly Income
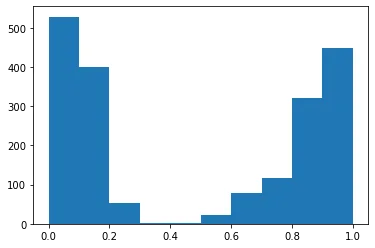
Incremento de 50% de Monthly Income
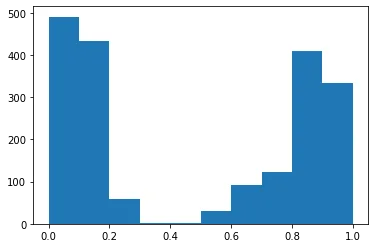
Incremento de 60% de Monthly Income
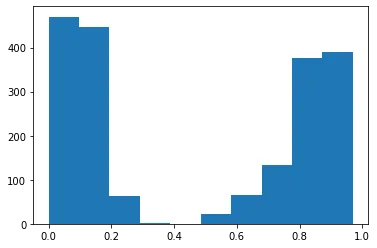
Incremento de 70% de Monthly Income
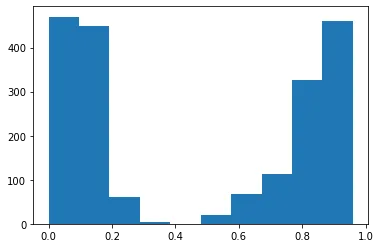
Incremento de 80% de Monthly Income
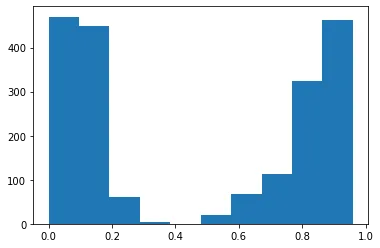
Incremento de 90% de Monthly Income
En este experimento aumenta ligeramente el número de perfiles clasificados como permanencia, incluso con incrementos salariales grandes. Esto describe la respuesta del modelo, no el efecto económico de una política salarial real.
Por eso planteamos un segundo experimento con dos perfiles individuales que tienen una probabilidad de salida elevada. Modificaremos algunas variables de cada perfil para observar cómo responde el modelo.
Como primer candidato hemos tomado un row con Attrition alto y le hemos puesto candidate_1
candidate_1['Attrition']0.76
Para observar cómo cambia la probabilidad estimada de salida, modificamos MonthlyIncome y OverTime. En este caso hemos aumentado su salario mensual un 10% y le hemos quitado que tenga que hacer sobretiempos.
candidate_1['MonthlyIncome'] = candidate_1['MonthlyIncome'] * 1.1
2230.8candidate_1[‘OverTime_No’] = 1
candidate_1['OverTime_Yes'] = 0
Cambiando estos valores y pasandolo como input por el Random Forest Classifier, podemos ver la nueva probabilidad de Attrition que nos da.
prob_candidate_1 = clf.predict_proba(candidate_1)[:,1]0.47
La probabilidad estimada baja de 0,76 a 0,47. Es un cambio en la predicción del modelo; no indica que la persona haya pasado a un estado de salud o bienestar determinado.
Realizaremos un segundo ejemplo, esta vez con un empleado que no esté haciendo horas extra.
Ejemplo con el candidato 2
candidate_2['Attrition'] 0.76
Para este segundo ejemplo, hemos elegido MonthlyIncome y StockOptionLevel. En este caso hemos aumentado su salario mensual un 10% y le hemos dado una opción de participación de nivel 2 dentro de la empresa, para que se sienta partícipe.
candidate_2['MonthlyIncome'] = candidate_2['MonthlyIncome'] * 1.1
3256.00candidate_2['StockOptionLevel'] = 2
Cambiando estos valores y pasandolo como input por el Random Forest Classifier, podemos ver la nueva probabilidad de Attrition que nos da.
prob_candidate_2 = clf.predict_proba(candidate_2)[:,1]0.49
En este segundo ejemplo, la probabilidad estimada baja de 0,76 a 0,49 tras modificar los datos de entrada.
Conclusiones
Este ejercicio nos llevó a explorar las probabilidades de salida, además de las etiquetas sí/no. Aun así, ninguna de estas salidas mide el estado emocional de una persona ni demuestra qué intervención mejoraría su situación.
Por eso hemos elegido abordar el proyecto de una forma más proactiva y que pueda ayudar a cambiar la situación de las personas antes de que sea tarde y también ayudar a tomar estas decisiones de forma informada.
El proyecto muestra cómo un clasificador puede ayudar a explorar patrones de rotación y la sensibilidad de sus predicciones a diferentes variables. No valida que los cambios simulados reduzcan la fuga de talento en una empresa real. Para estudiar ese efecto harían falta datos adecuados y una evaluación de las intervenciones, además de escuchar a las personas implicadas.
Los siguientes pasos serían mejorar la evaluación del modelo, comprobar la calibración de sus probabilidades y estudiar si los resultados se mantienen con datos nuevos y representativos.
Aquí en repositorio del proyecto.
Gracias.Saturdays.AI
Repositorio
En el siguiente repositorio se encuentra el código usado para desarrollar esa aplicación: https://github.com/SaturdaysAI/Projects/tree/master/Donostia/Donostia2021/HUMANDS-master
¡Más Inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 31 dic 2021.
← Más historias de la comunidad