Análisis de Depresión en Redes Sociales: Una aplicación en Bioestadística
Un análisis exploratorio de Facemood sobre uso de redes sociales, estado de ánimo y síntomas autoinformados, con técnicas estadísticas y de machine learning.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
Donostia. Primera Edición. 2020
Introducción
¿Te has preguntado alguna vez si tanto usar las redes sociales podría afectar a tu estado de ánimo? Hay quien relaciona un mal uso de las redes sociales a problemas psicológicos como la depresión, pero ¿qué hay de cierto en esta idea? ¿Existe evidencia científica que nos alerte sobre peligros reales de las redes sociales, o se trata de temores infundados?
Durante la primera edición del programa Saturdays AI en Euskadi, el grupo Facemood nos propusimos explorar la relación entre el uso de redes sociales y síntomas asociados a la depresión. Para ello utilizamos herramientas estadísticas y de Machine Learning que nos ayudaron a entender la relación entre estas variables.
La depresión constituye un problema importante de salud pública, ya que es un gran factor de riesgo para el suicidio, que reclama cientos de miles de vidas cada año.
Conocer mejor los factores asociados a la depresión puede contribuir a diseñar políticas públicas y apoyar los esfuerzos para salvar vidas.
¿Quiénes somos?
Como si se tratara de un partido de fútbol sala, os presentamos nuestro quinteto inicial:
- ¡Hola, internauta! Soy Sergio Navarro y trabajo en ingeniería de software. Soy desarrollador full stack en una pequeña startup de Álava y paso mi tiempo entre líneas de código, bases de datos y preguntas de Stack Overflow que puedan ayudarme a resolver ese bug que no me deja dormir.
Como punto de partida, nos basamos en el trabajo realizado por un grupo de investigadores neerlandeses y estadounidenses titulado: 'Las redes sociales y los síntomas de la depresión: una perspectiva de la red' (DOI:10.1037/xge0000528; disponible también en acceso abierto). El estudio examinó las relaciones temporales entre síntomas depresivos y el uso pasivo de redes sociales, como hacer scrolling en el feed de noticias o fotografías. Se trata de asociaciones observadas, no de una demostración experimental de causalidad.
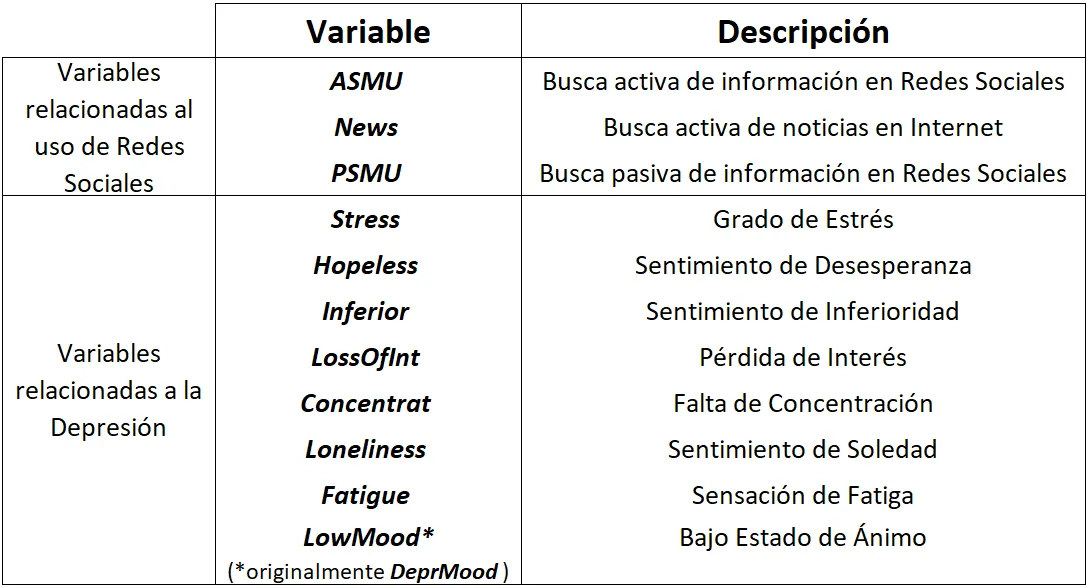
Para la obtención de los datos, cada uno de los participantes en el estudio recibía en su teléfono móvil un cuestionario en el que debía responder de 0 a 100 como se sentía en referencia a cada uno de los posibles síntomas de depresión: falta de energía (Fatigue), estado de ánimo bajo (LowMood), soledad (Loneliness), problemas de concentración (Concentration), pérdida de interés (Loss of Interest), sentimiento de inferioridad (Inferiority), desesperanza (Hopeless), y estrés (Stress). También tuvieron que responder de 0 a 100 a tres preguntas relacionadas con el uso de las Redes Sociales: uso pasivo (PSMU), activo (ASMU), y consulta de noticias (News: acceder a información de carácter político o de interés público). Los participantes rellenaron este cuestionario siete veces al día durante 14 días.
A continuación, una breve descripción de las 11 variables del estudio:
Para llevar a cabo este proyecto, hemos planificado una estrategia de análisis según el esquema de abajo, en el que hemos utilizado distintas metodologías y herramientas:
1. EDA (Exploratory Data Analysis)
2. Cluster Analysis
3. ANOVA de Medidas Repetidas
4. Análisis de Regresión
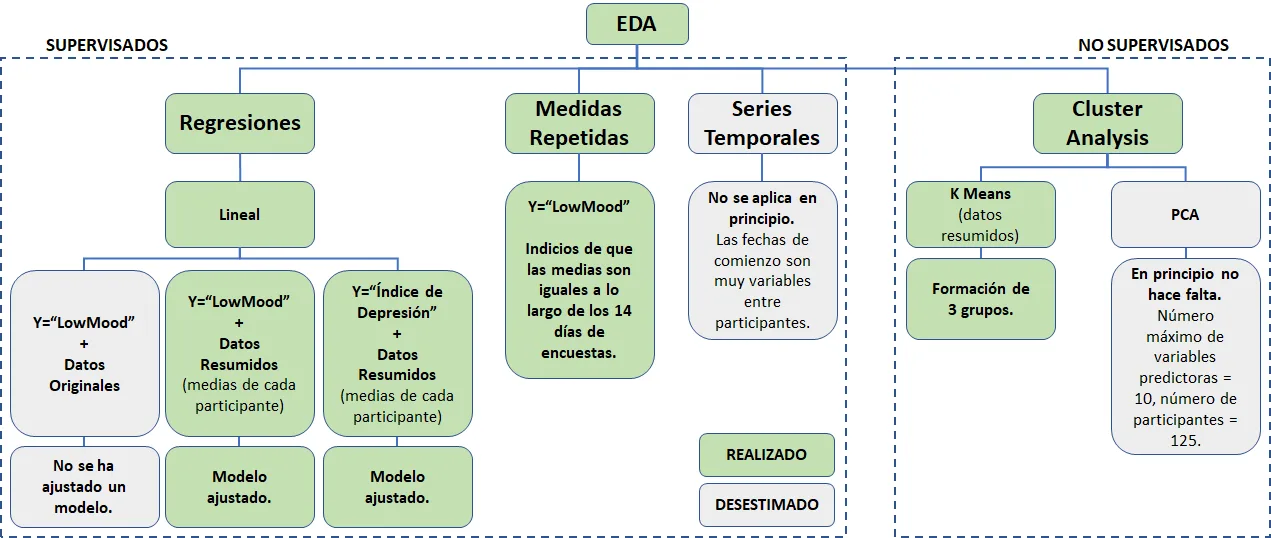
Figura 1. Estrategia de Análisis.
1. EDA (Exploratory Data Analysis)
El conjunto procede de una publicación científica y cuenta con documentación del estudio original. Esto ayuda a comprender su origen, pero no garantiza por sí solo una mayor calidad que la de un conjunto de datos obtenido en una plataforma de datos open source como Kaggle. En todos los casos conviene analizar la calidad, los patrones y las limitaciones de los datos antes de aplicar técnicas de Machine Learning.
La primera fase consistió en identificar aquellas mediciones que consideramos válidas. Lógicamente muchos de los participantes olvidaron llevar a cabo algunas de las mismas (realizar 7 mediciones al día durante 14 días no es tarea fácil ?), o no supieron responder a algunos de los síntomas (cuantificar tu estado de ánimo de 0 a 100 tampoco lo es…). Todas estas mediciones fueron eliminadas.
En una segunda fase, nos fijamos en si las mediciones restantes eran coherentes: no poseen el mismo valor en todos los síntomas, no son respuestas recurrentes, fueron realizadas en el plazo de tiempo definido, etc.
De esta forma, ¡ya estamos listos para pasar a la acción!
2. Cluster Analysis
La siguiente fase consistió en llevar a cabo un Cluster Analysis, una de las técnicas de Machine Learning para identificar grupos en el conjunto de datos. Utilizamos los métodos Elbow y Silhouette para obtener el número de clusters óptimo y el algoritmo K-means, técnica de unsupervised learning para hacer clustering.
Identificación del número óptimo de clusters
Método Elbow: en este se calcula la distorsión promedio de los clusters, es decir, la distancia promedio del centroide a todos los puntos del cluster. Esta se obtiene con el algoritmo de K-means en función del número de clusters. Para resolver este ejercicio, hemos creado la función plot_elbow, que recibe un conjunto de datos y un título de gráfico. Fijamos los valores de los parámetros max_k en 10 y probamos los valores del 1 al 9, representando el resultado en una gráfica.
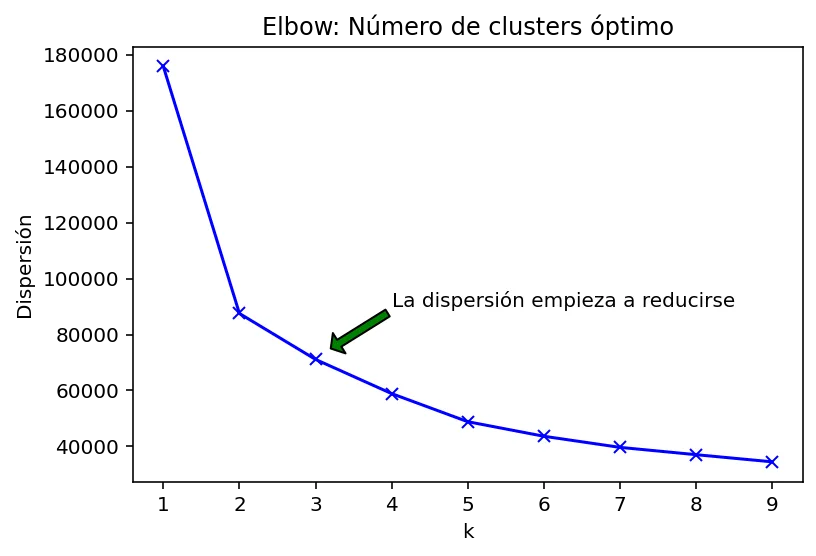
Figura 2. Gráfica que representa el método Elbow.
El equipo interpretó que tres grupos ofrecían un compromiso razonable a partir de la curva del codo. Esta elección se contrastó con el coeficiente de silueta.
Método Silhouette: para cada observación, a es la distancia media a las demás observaciones de su propio grupo; b es la menor distancia media a las observaciones de otro grupo. El coeficiente se calcula como (b − a) / max(a, b) y toma valores entre −1 y 1.
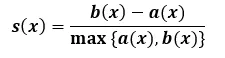
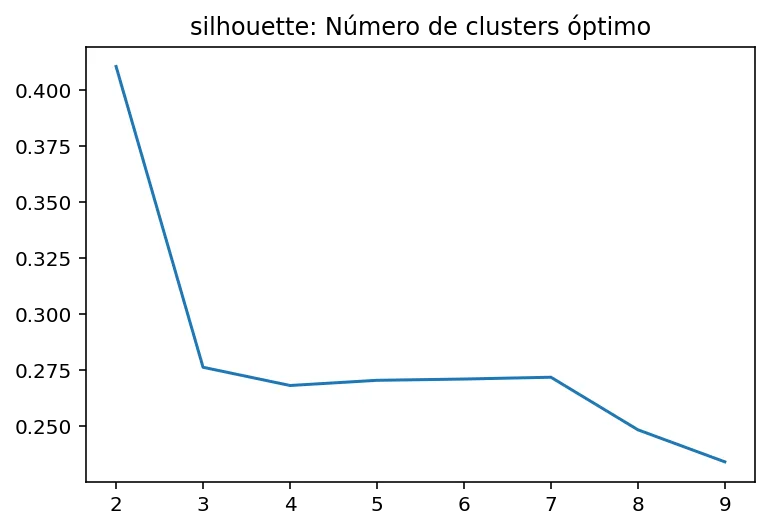
Figura 3. Gráfica que representa el método Silhouette.
Con este método comprobamos que el 3 puede ser un buen valor para probar nuestro cluster analysis.
Implementación del algoritmo k-means y visualización de los grupos en un gráfico 3D
El algoritmo recibe un conjunto de datos para entrenarlo y un número de clusters para dividirlo. Mediante el método predict se asigna cada observación del conjunto de datos a un grupo conjunto de datos, y finalmente se representa cada dato con un color distinto en función del cluster al que ha sido asignado. Podemos apreciar el resultado en la Figura 4 y la distribución de participantes en la Figura 5.
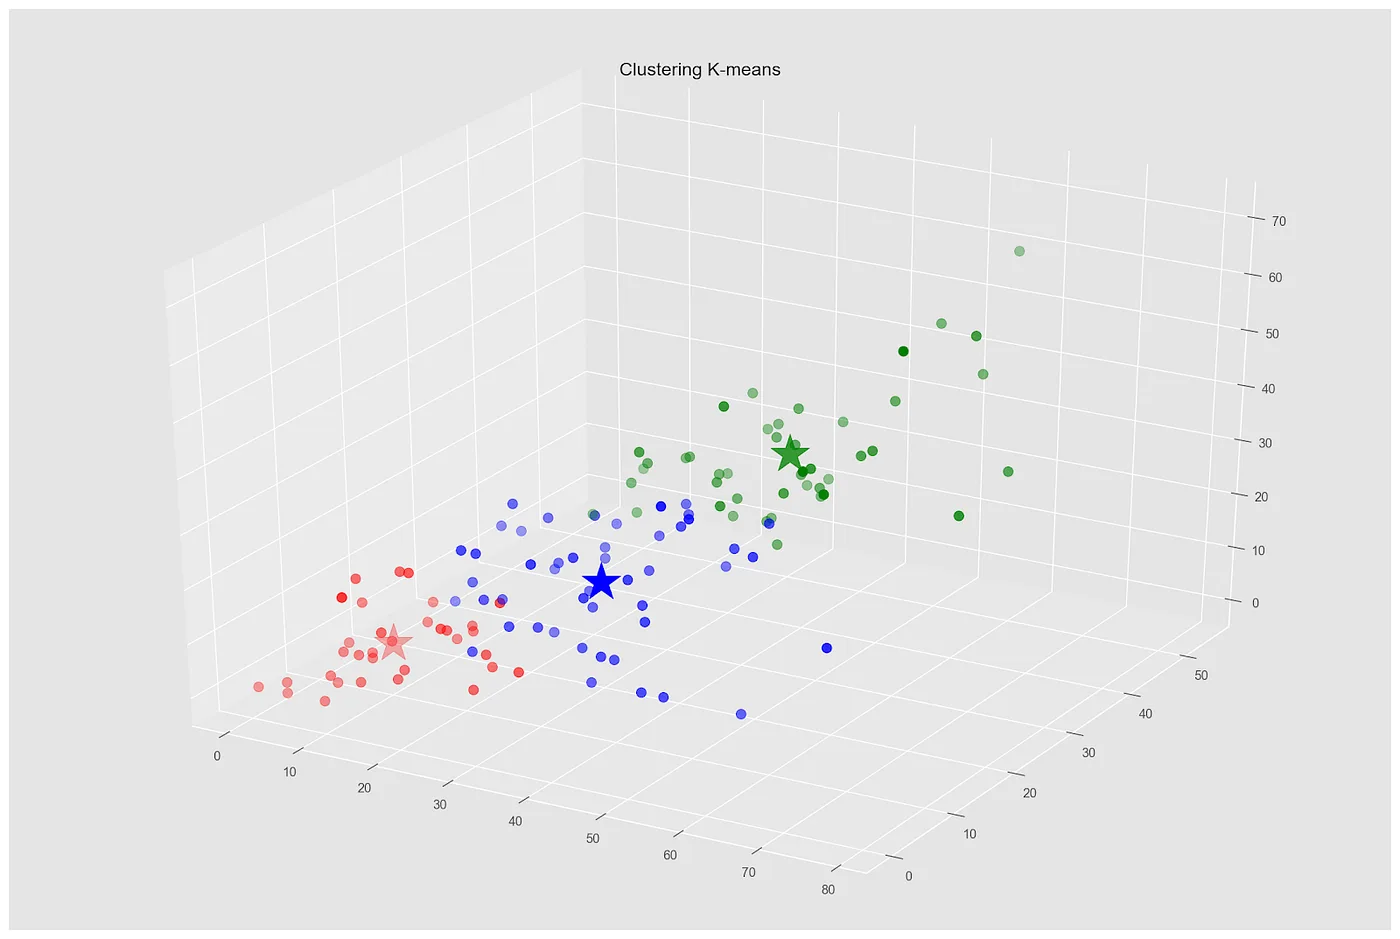
Figura 4. Visualización de los grupos en un gráfico 3D.
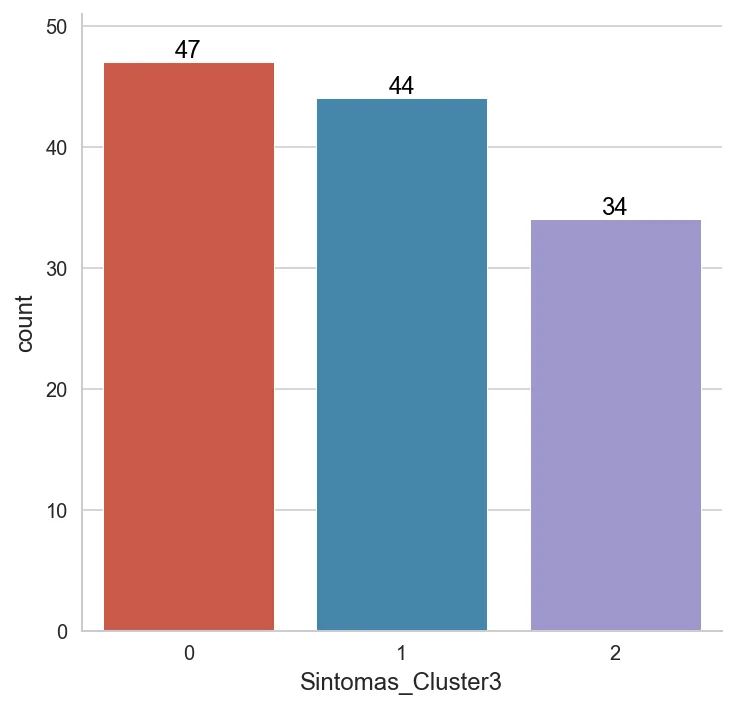
Figura 5. Distribución de los participantes por cluster.
Finalmente, para concluir con el Cluster Analysis, hemos elaborado una serie de gráficos (histogramas solapados), para identificar de un vistazo las diferencias en cada variable entre los miembros de cada cluster.
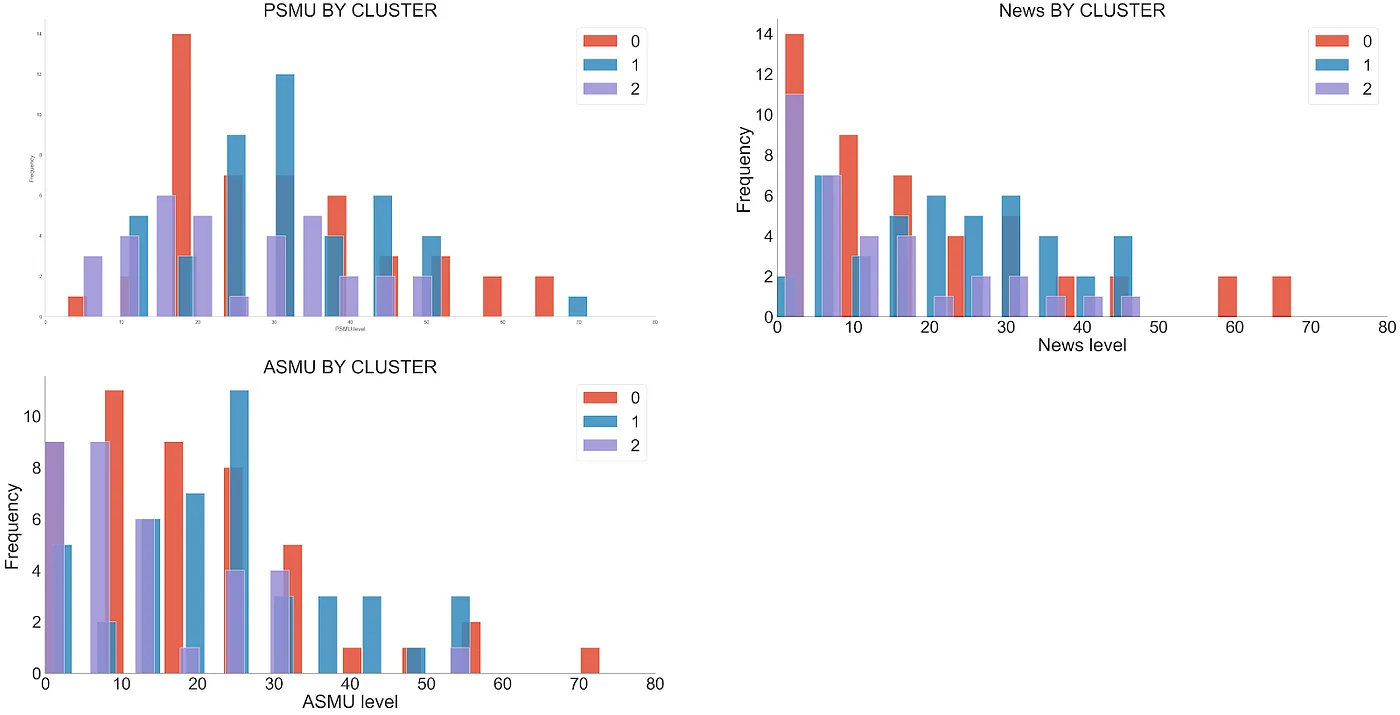
Figura 6. Variables de redes sociales por cluster.
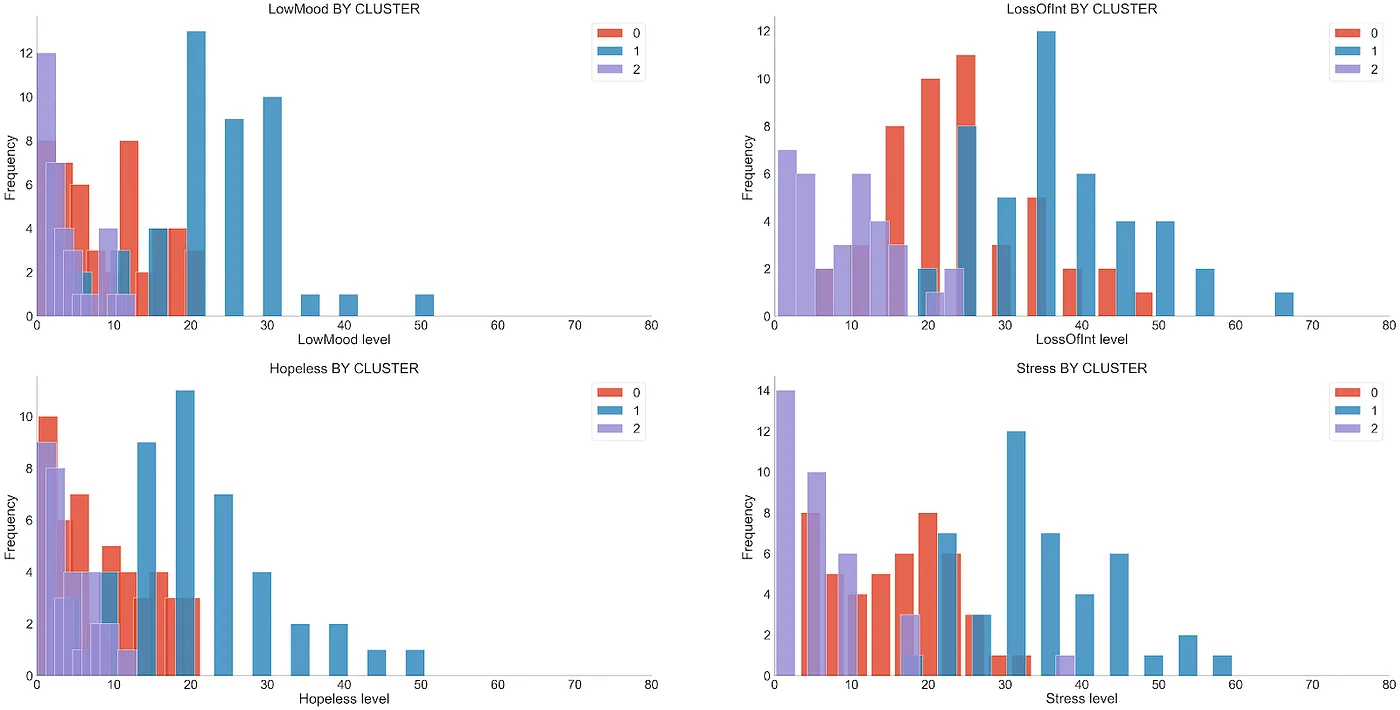
Figura 7. Variables relacionadas a la depresión, por cluster.
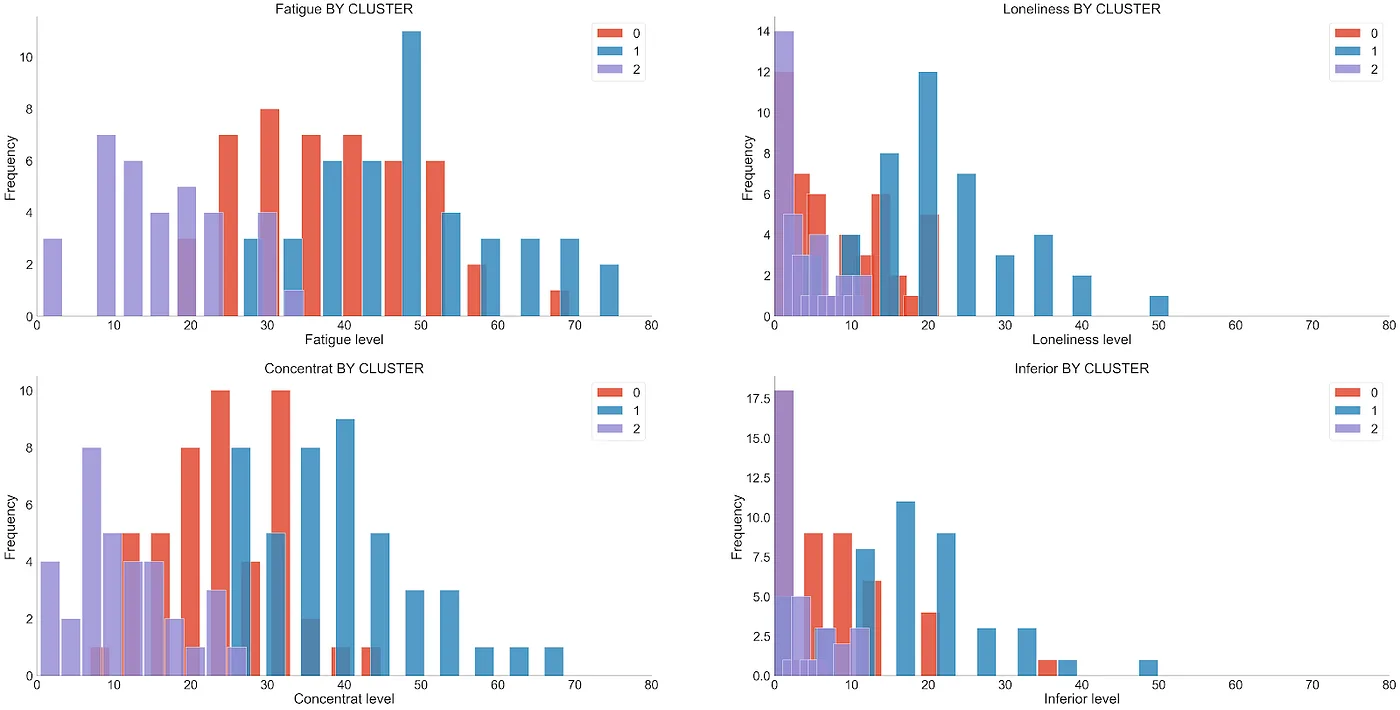
Figura 8. Variables relacionadas a la depresión, por cluster.
Se observa que los 3 clusters son diferentes en lo que concierne a los síntomas relacionados con la depresión, siendo el Cluster 1 el que contiene las mayores puntuaciones medias en los ocho síntomas autoinformados. Esto describe diferencias en las respuestas del cuestionario, no un diagnóstico de depresión.
Sin embargo, como podemos observar en la Figura 6 (Variables de RR.SS. por Cluster), en el caso de las variables relacionadas con RR.SS. no encontramos grandes diferencias entre clusters.
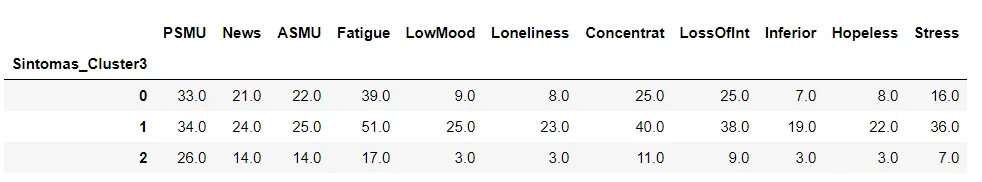
Figura 9. Tabla de medias por cluster.
3. ANOVA de Medidas Repetidas
Hay dos aspectos de este conjunto de datos que nos llamaron especialmente la atención. Por un lado, el hecho de haber tomado mediciones durante dos semanas nos ofrece la posibilidad de explorar si dichas mediciones varían con el tiempo. Mediante un gráfico de líneas o lineplot podemos observar cómo varía, de media, cada síntoma medido.
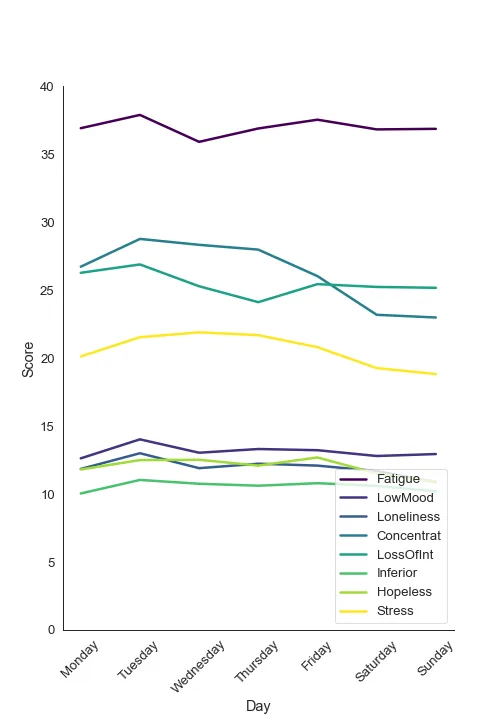
Figura 10. Medias de cada variable agrupadas por día de la semana.
Aunque parece haber cierta variación a lo largo del tiempo en alguna de las variables, no podemos estar seguros a simple vista de si cabría esperar que los datos varíen así por puro azar o porque no hemos usado un instrumento de medida muy bueno.
Por otro lado, sabemos que se realizaron un gran número de mediciones a cada participante. Como explicamos arriba, se hizo un seguimiento de sintomatología relacionada con la depresión durante 14 días a 125 sujetos. Además, cada día se pidió a los participantes que rellenaran la escala cada 2h desde las 10:00 a las 22:00. Por tanto, con siete mediciones diarias durante dos semanas en 125 sujetos, tenemos un total de 12.250 observaciones en el conjunto de datos.
¡Pero cuidado! Estas observaciones no son independientes entre sí. No podemos utilizar un modelo estadístico que tome cada una de esas observaciones como si proviniera de distintas personas, porque la variabilidad que obtenemos al medir repetidamente a un mismo individuo será distinta a la variabilidad obtenida al medir a distintos individuos (al menos si la medición es mínimamente fiable).
Existe un modelo estadístico que sí nos permite analizar la influencia del tiempo en nuestros datos, pero respetando el hecho de que no todas las observaciones son independientes, sino que tenemos grupos de 98 observaciones a lo largo del tiempo para 125 sujetos. Este modelo se llama Análisis de la Varianza (o ANOVA) de Medidas Repetidas.
Como el tamaño de nuestra muestra no es excesivamente grande (125 participantes) y contamos con 8 variables de síntomas relacionados con la depresión, decidimos no incorporar al modelo estadístico todas las variables y estimar un modelo simplificado para la variable ‘estado de ánimo bajo’ (LowMood). Por tanto, se trataría de un ANOVA de medidas repetidas con dos factores: (i) tiempo, donde se incluyen las puntuaciones medias de cada día en esta variable; y (ii) cluster, donde se recoge la pertenencia de cada sujeto a los clusters calculados anteriormente. La hipótesis nula de este modelo establece que todas las medias del LowMood son iguales a lo largo de los 14 días de encuestas.
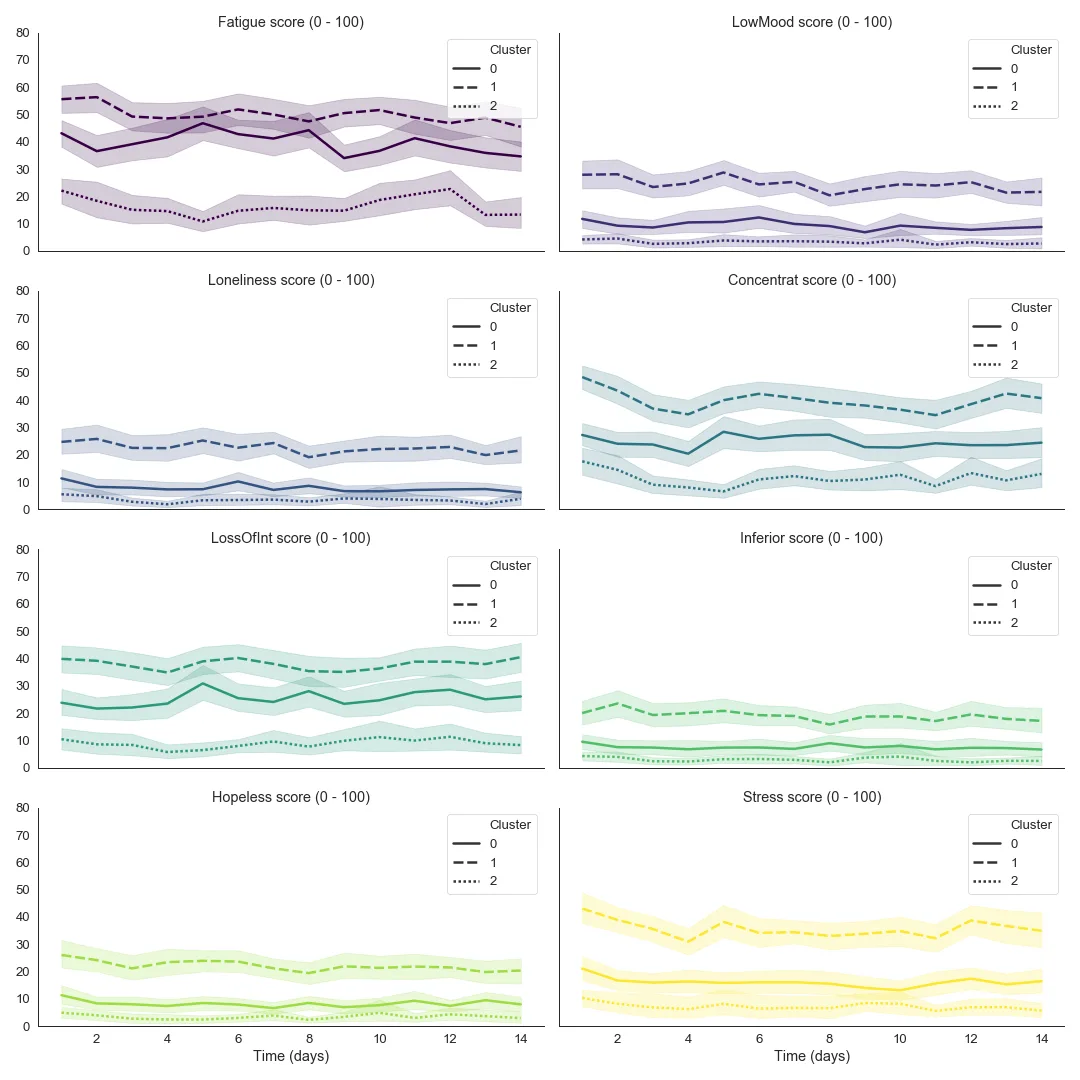
Figura 11. Promedio de cada variable del cuestionario por día y cluster.
Como podemos ver en la Figura 11 (variable LowMood), la variabilidad de los datos a lo largo del tiempo es mínima y, de hecho, aunque el resultado del test estadístico es estadísticamente significativo (F(13,26) = 2.261, p = 0.018), el tamaño de efecto es prácticamente despreciable (η2 = 0.02).
Por tanto, el modelo estadístico de ANOVA de Medidas Repetidas nos ha informado que, a pesar de tener un conjunto de datos con información detallada a lo largo del tiempo, las puntuaciones de los síntomas variaron poco durante el periodo observado.
4. Análisis de Regresión
El primer paso que dimos para ajustar las regresiones lineales fue calcular las medias de todas las mediciones por participante y variable. Esto nos permitió “eliminar” el aspecto temporal de las “medidas repetidas” del estudio.
A continuación, construimos gráficas de dispersión entre todas las variables del estudio, y calculamos los coeficientes de correlación lineal de Pearson (r) para las combinaciones de variables, con el objetivo de detectar asociaciones fuertes y posibles problemas de multicolinealidad.r > 90%).
Observamos que algunas variables estaban muy correlacionadas linealmente, como se puede observar en la gráfica de abajo:
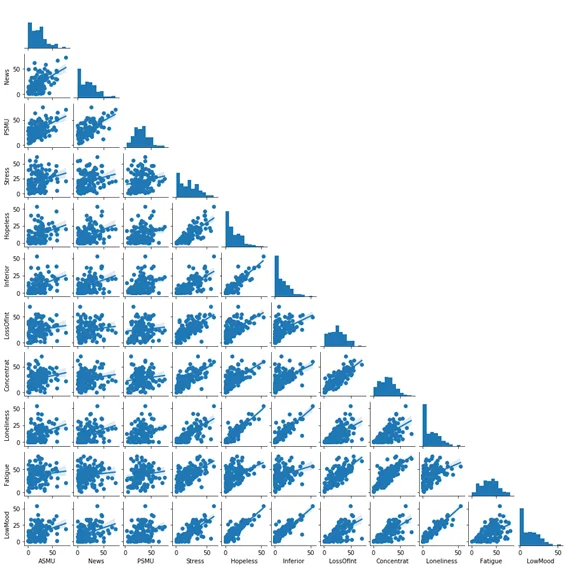
Figura 12. Diagrama de matriz de las gráficas de dispersión de las 11 variables del estudio.
Para ajustar un modelo inicial, tuvimos que definir una variable “respuesta” o “Y”. Elegimos “LowMood”, por tratarse en principio de una de las variables más importantes del estudio.
En el mapa de calor de correlaciones lineales de Pearson, se observa multicolinealidad entre “Loneliness y Hopeless”, y “Inferior y Hopeless”, por lo que decidimos no utilizar en un primer momento “Hopeless”.
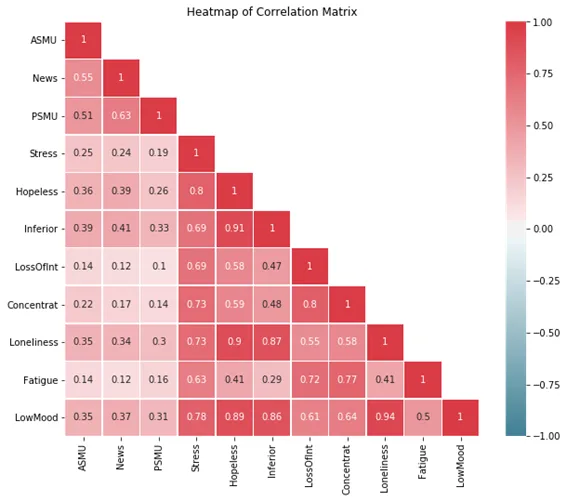
Figura 13. Mapa de calor de los coeficientes de correlación de Pearson
de las 11 variables del estudio.
Para el ajuste del Modelo de Regresión, utilizamos el método “backward”: a partir del modelo saturado con todas las variables independientes disponibles, el método iba eliminando, una a una, dichas variables cuyo p-value > alpha, siendo alpha = probabilidad del “error tipo 1”.
Para ello creamos una función llamada “calculateRegression”, que utiliza un 80% de los datos para los ajustes, y reserva un 20% de los datos para los testeos.
Además, la función calcula el “RootMeanSquareError” (RMSE) y el “Coeficiente de Determinación” (R2) para cada modelo ajustado.
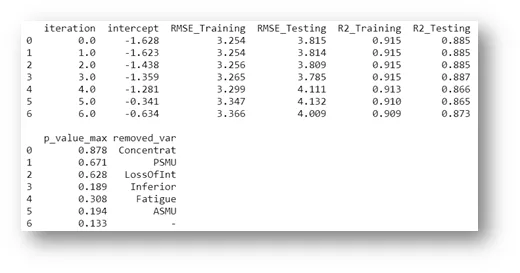
Figura 14. Resultado del procedimiento de eliminación hacia atrás (backward) de variables con poca capacidad explicativa.
El Modelo Final ajustado involucra 3 variables, siendo “News” una de ellas.
LowMood = -0,85 + 0,78 Loneliness + 0,18 Stress + 0,04 News
Es importante resaltar que el coeficiente de determinación (R2) del modelo ajustado es “alto” (93,1%).
Para comprobar algunos supuestos del modelo, realizamos un “análisis de residuos”, también recogido en una función llamada “residualAnalysis”. Esta función realiza el “test de normalidad” (Kolmogorov-Smirnov) de los residuos estandarizados e imprime 3 gráficas: Gráfica de Dispersión entre “Predicción” y “Residuos Estandarizados”, Histograma de los Residuos Estandarizados, y “Normal Q-Q Plot” de los Residuos Estandarizados.
El equipo consideró satisfactorio el análisis de residuos. Esto apoya ciertas comprobaciones del ajuste, pero no constituye una validación definitiva ni clínica del modelo.
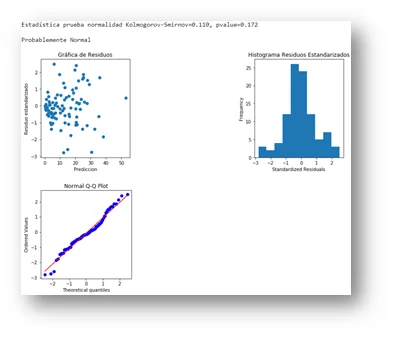
Figura 15. Output de la función “residualAnalysis”.
Es importante observar que el peso de “News” (0,04) es muy inferior a los pesos de “Loneliness” (0,78) y “Stress” (0,18), y que, si hubiésemos definido un “alpha” más estricto, “News” no se mantendría en el modelo final.
Para comparar otro resultado, construimos un “índice exploratorio de síntomas”, para ser utilizado como variable respuesta de un segundo modelo. La idea era comparar los 2 modelos, de cara a corroborar las conclusiones anteriores.
El índice, que denominamos “DeprRate”, fue calculado como el promedio simple entre “LowMood”, “LostOfInt” y “Hopeless”. Es una variable construida para este análisis, no una escala clínica validada.
Seguimos los mismos pasos expuestos anteriormente. El modelo final contiene ahora 5 variables y no involucra ninguna variable relacionada al uso de Redes Sociales.
DeprRate = -0,025 + 0,31 Loneliness + 0,25 Inferior + 0,19 Concentrat + 0,15 Stress + 0,06 Fatigue
El segundo modelo obtuvo un R² del 90,8 % y un análisis de residuos que el equipo consideró satisfactorio. Son resultados del ajuste a estos datos, sin validación clínica o externa.
Es interesante constatar que “Loneliness” de nuevo aparece como la variable de mayor peso para “DeprRate”, y que “Stress” sigue en este segundo modelo, con un peso parecido.
Nota: las dos funciones anteriores están definidas en regresion_functions.py. Este archivo también incluye otras funciones utilizadas en el análisis, como:
- printMatrixDiagram: función que genera gráficas de dispersión (2 a 2), involucrando todos los indicadores del estudio. Útil para ver de forma gráfica, en un único vistazo, los indicadores que están más correlacionados entre ellos.
- printPearsonCorrelations: genera un mapa de calor de las correlaciones de Pearson entre todos los indicadores del estudio. Útil para ver, en un único vistazo, los indicadores que están más correlacionados entre ellos y si hay multicolinealidad.
- eliminateOutliers: elimina los residuos estandarizados considerados “altos” (menores que -3 y mayores que +3), de cara a realizar posteriormente nuevos ajustes sin estos datos que muchas veces distorsionan los resultados. La función imprime los datos eliminados, posibilitando un control de lo que se está eliminando.
- repeatRegression: vuelve a ajustar el modelo de regresión lineal final ajustado en “calculateRegression”, ahora para los datos libres de “outliers”. Además, vuelve a calcular el “RootMeanSquareError” (RMSE) y el “Coeficiente de Determinación” (R2).
Conclusiones Finales
Con relación al Cluster Analysis, se observa que los 3 clusters formados son diferentes en lo que concierne a los “síntomas de depresión”, siendo el Cluster 1 el que contiene las mayores medias en relación a los 8 síntomas del estudio. Sin embargo, lo mismo no pasa con las variables de Redes Sociales, ya que los histogramas solapados por cluster no muestran grandes diferencias para las variables PSMU, News y ASMU.
Por otro lado, el ANOVA de Medidas Repetidas encontró un efecto temporal estadísticamente significativo, pero pequeño (η² = 0,02), durante los 14 días. La conclusión original de “ausencia de diferencias significativas” no coincidía con el valor p = 0,018 indicado anteriormente.
Los Modelos de Regresión ajustados indican que el uso de las Redes Sociales tiene un peso mucho menor que las demás variables utilizadas en el estudio para explicar un posible cuadro de depresión.
La Soledad, el sentimiento de Inferioridad, la pérdida de Concentración y el Estrés tienen un peso notablemente mayor para este conjunto de datos.
Esta constatación coincide con los resultados del Cluster Analysis presentados anteriormente.
Todas las conclusiones presentadas aquí son referentes única y exclusivamente al conjunto de datos utilizado en este proyecto. Para hacer inferencias más concluyentes, habría que ampliar el estudio utilizando un muestreo mayor, entre otras cosas.
Pasos Futuros
En este conjunto de datos, las variables de uso de redes sociales aportaron menos al ajuste de los síntomas que la soledad, el sentimiento de inferioridad, la concentración, el estrés y la fatiga. Estas asociaciones no permiten diagnosticar depresión ni afirmar qué factores la causan.
Como posible línea de investigación, el equipo propuso explorar el procesamiento del lenguaje natural. Cualquier herramienta dirigida a personas requeriría una evaluación independiente, consentimiento y protección de datos; estos resultados no validan la detección de depresión en publicaciones de redes sociales.
Agradecimientos
Agradecemos a los mentores y organizadores de Saturdays.AI Donostia, especialmente a Beñat Galdós y Joxemari Gallastegi, por su profesionalidad, dedicación y entusiasmo.
Presentación del proyecto: DemoDay
Repositorio
En el siguiente repositorio se encuentra el código usado para desarrollar esta aplicación: https://github.com/SaturdaysAI/Projects/tree/master/Donostia/Donostia2020/AISaturdays-depresion-rrss
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 16 mar 2022.
← Más historias de la comunidad