PANGEA: IA conversacional para viajeros
Pangea explora un asistente de preguntas y respuestas para viajeros, combinando búsquedas web con modelos BERT en español e inglés.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
La Paz. Deep Learning. 2021
Hay numerosos servicios digitales para viajeros, pero encontrar una respuesta concreta puede llevar tiempo. De esa necesidad nace Pangea, un servicio web de IA conversacional pensado para responder preguntas sobre destinos turísticos.
Un viajero puede tener preguntas sobre la seguridad de su destino, sus costumbres, platos típicos, música o lugares de interés. Consultar distintas fuentes para resolverlas lleva tiempo; el proyecto busca facilitar esa búsqueda.
Para analizar textos y responder preguntas utilizamos procesamiento del lenguaje natural (NLP, por sus siglas en inglés) , una rama de la Inteligencia artificial (IA) que entrena a una computadora para comprender, procesar y generar lenguaje (conversacional).
Descripción del problema
El problema es el tiempo que se necesita para encontrar respuestas sobre un destino: comida, alojamiento, actividades, transporte, centros de salud, cultura, música o situación política, entre otros temas.
Objetivo
Desarrollar mediante Inteligencia Artificial un servicio web conversacional de pregunta-respuesta para viajeros aplicando NLP mediante la aplicación de un modelo de deep learning.
Técnicas implementadas
Se presentan las técnicas complementarias a la resolución del problema, ya que todo modelo de Deep Learning requiere ser alimentado por datos.
Búsqueda de datos
La Inteligencia Artificial conversacional Pangea responde preguntas utilizando textos web como contexto. Para localizar páginas relacionadas con cada consulta, utilizamos la biblioteca de Python Google Search, el cual emplea al motor de búsqueda Google como fuente de información para brindar las URLs de los sitios webs requeridos.
Captura de datos
Una vez obtenidas las URL, aplicamos Web Scraping para obtener el contenido literal de dichos sitios, es decir, los distintos párrafos y textos del sitio. Esta técnica recopila información web mediante código. Para ello utilizamos la biblioteca Beautiful Soup , disponible en PyPI.
Selección y evaluación del modelo
Modelo Bert: es un codificador bidireccional de transformers, que aprende a interpretar el lenguaje.
Cuando al modelo Bert se le añade capas adicionales y es entrenado con un propósito o tarea especializada, se obtiene un modelo Bert que resuelve una tarea en específico.
Utilizamos modelos ya ajustados para responder preguntas con datos de SQuAD, el conjunto de preguntas y respuestas de Stanford.
Obtuvimos ambos modelos a través de Hugging Face Transformers. Cada uno recibe una pregunta y un contexto para procesarlo y analizarlo con el fin de devolver las respuestas que mejor se ajusten a la pregunta.
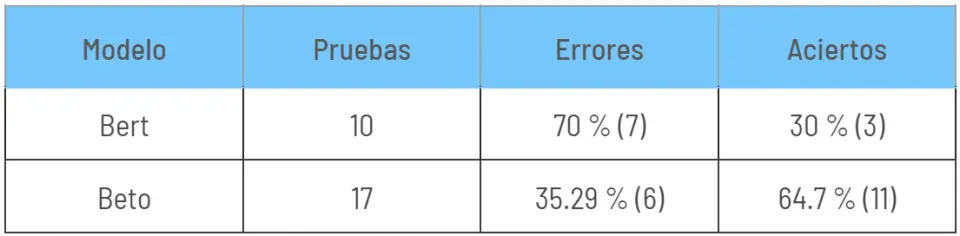
La elección del mejor modelo fue dado en base a los resultados:
- Bert en inglés: bert-large-uncased-whole-word-masking-finetuned-squad
- Bert en español (Beto): distill-bert-base-spanish-wwm-cased-finetuned-spa-squad2-es
Tabla 1. Evaluación de Modelos
Seleccionamos un ejemplo para comparar las respuestas de ambos modelos a la misma pregunta, formulada en su respectivo idioma (Fig. 1).
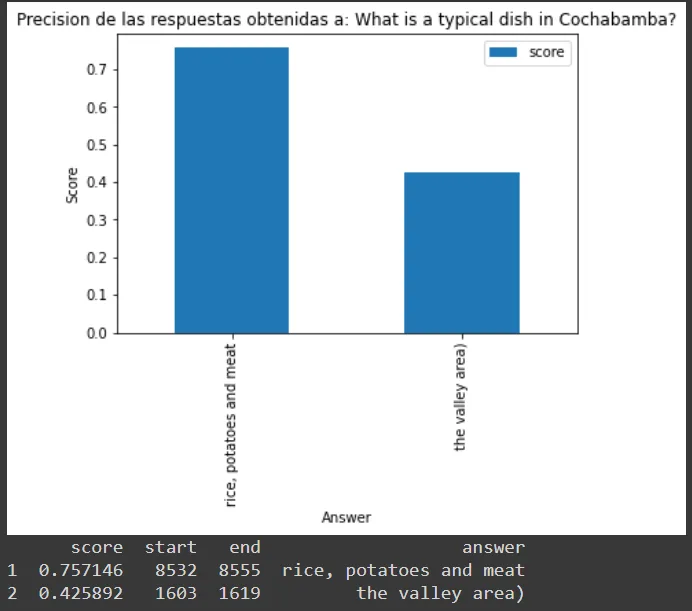
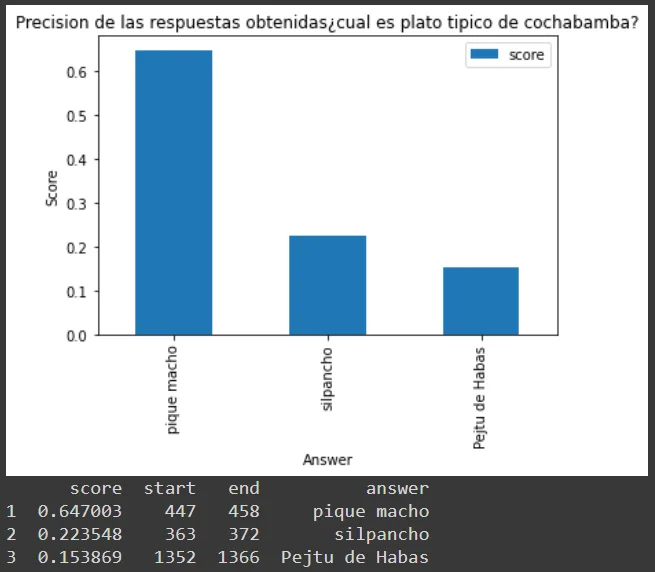
Figura 1. Gráfico de barras — Representación de respuestas Modelo Bert y Beto a la misma pregunta.
Flujo de Trabajo del Sistema
El usuario introduce una pregunta y el sistema busca con Google Search hasta cinco URL relacionadas. Después extrae los párrafos de esas páginas y los proporciona al modelo como contexto. El modelo procesa ese contexto junto con la pregunta y devuelve una respuesta; se guardan la respuesta y la URL de origen, y ambas se muestran en formato de mensaje de chat, figura 2.
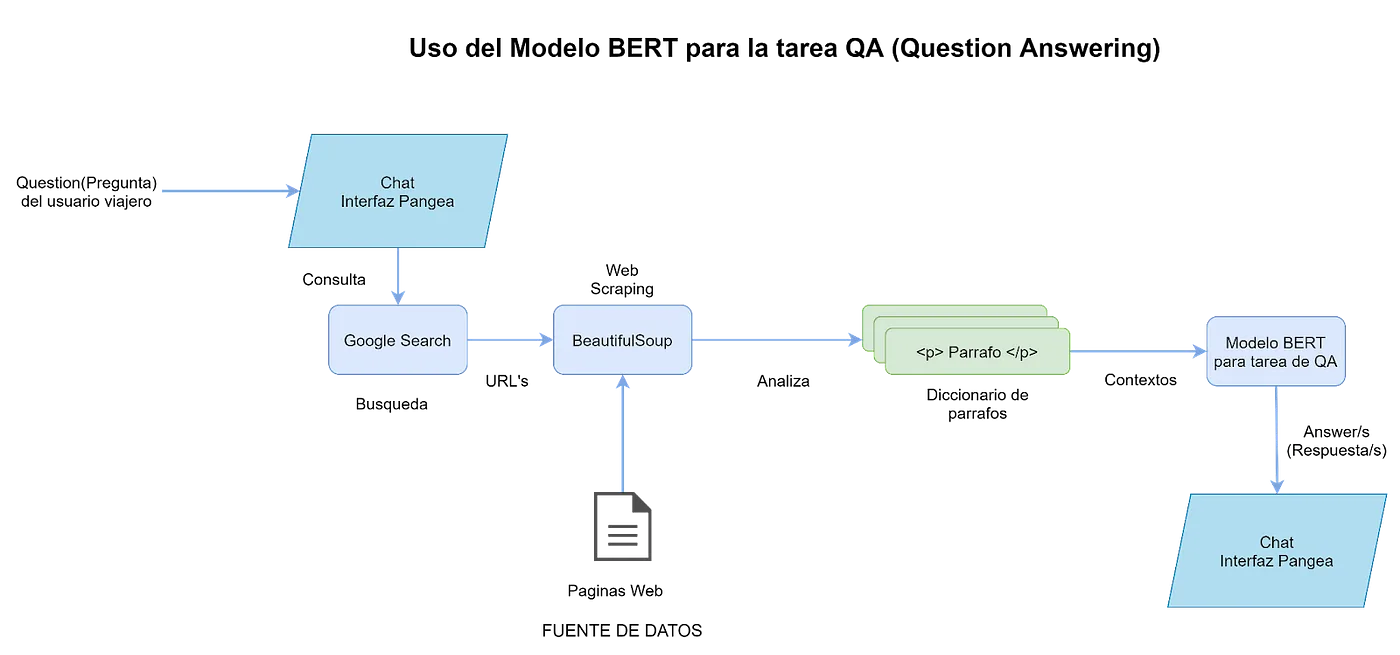
Figura 2 . Elaboración propia
Análisis de resultados (Bert vs Beto)
Pangea devuelve respuestas junto con las URL de origen. En las pruebas realizadas, el modelo Beto obtuvo un mayor porcentaje de respuestas correctas. Esta comparación corresponde únicamente a la pequeña muestra de preguntas utilizada.
Conclusión y recomendaciones
Las conclusiones obtenidas tras el desarrollo y resolución del objetivo general son:
- En una prueba de 17 preguntas, el modelo en español obtuvo un 64,7 % de respuestas correctas, frente a aproximadamente un 30 % del modelo en inglés. Las preguntas trataban sobre Bolivia. El equipo considera que la disponibilidad de información local en español pudo influir en la diferencia; la prueba no permite concluir que un modelo sea mejor en general.
- La técnica del Web Scraping aportó correctamente el contenido web necesario para que el modelo BERT pudiese responder las preguntas adecuadamente.
- Dado que el servicio (Pangea) se desplegó por un momento se logró registrar el uso de 2.5 GB de memoria RAM con una demora de aproximadamente 30 segundos mientras el modelo responde a la pregunta.
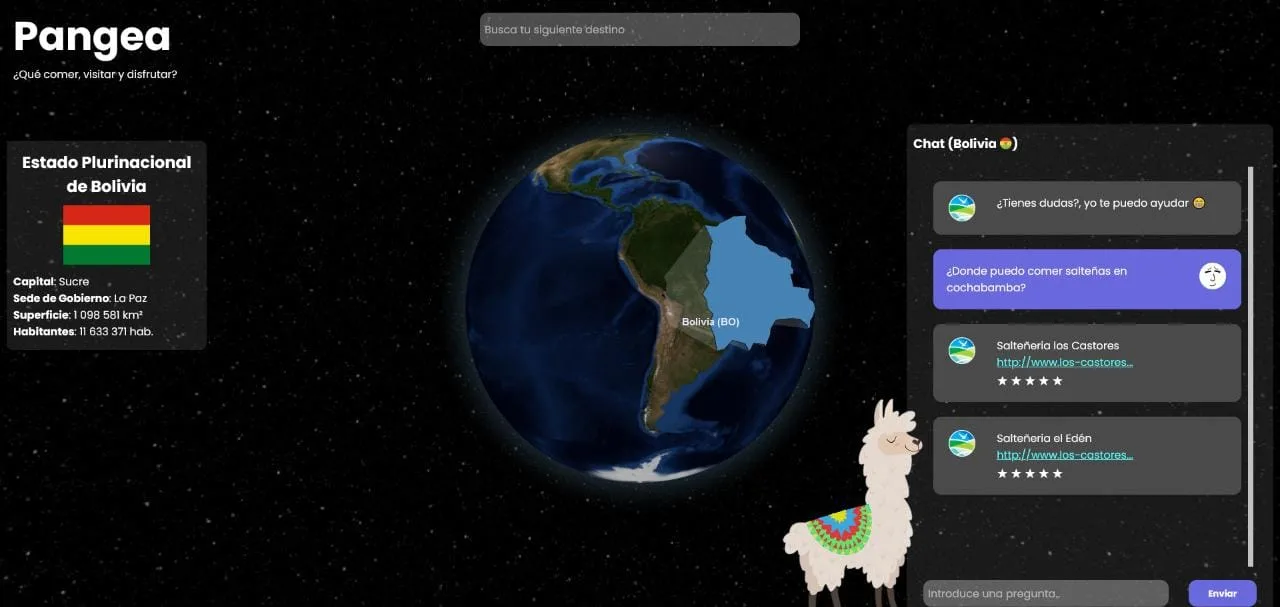
- El Servicio Web que se ofreció por unos instantes logró capturar la curiosidad y asombro de los usuarios por su diseño minimalista e interesante forma de interactuar.
Por otra parte las recomendaciones al respecto son:
- El modelo BERT empleado fue afinado (fine-tuning ) con el dataset SQUAD el cual tiene un formato pregunta-respuesta de dominio parcialmente general, por lo que se tiene mayores expectativas con un afinado específico para el área de turismo.
- Una selección más cuidadosa de las fuentes podría mejorar la calidad de las respuestas. Google localiza páginas, pero no garantiza que su contenido sea correcto o esté actualizado.
- Explorar modelos adicionales para responder en otros idiomas.
Autores del proyecto
- Ana Paola Céspedes Sejas
- Mauricio Serginho Matias Conde
«Equipo ElementAxiom»
Referencias
Google search, https://pypi.org/project/googlesearch-python/
Beautiful Soup, https://pypi.org/project/beautifulsoup4/
Modelo Bert en español, https://huggingface.co/mrm8488/distill-bert-base-spanish-wwm-cased-finetuned-spa-squad2-es
Modelo Bert en inglés, https://huggingface.co/bert-large-uncased-whole-word-masking-finetuned-squadSaturdays.AI
Saturdays.AI
Autoría
Ana Paola Céspedes Sejas
Presentación del proyecto: DemoDay
¡Más Inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Explora los cursos disponibles
Conoce la comunidad de Saturdays.AI
Saturdays.AI
Saturdays.AI es una comunidad abierta donde aprendemos inteligencia artificial, colaboramos y creamos proyectos con impacto social.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 2 ene 2022.
← Más historias de la comunidad