Machine learning aplicado a la industria textil
La Paz. 2021 El proyecto comenzó con esta pregunta: ¿Será posible mejorar la toma de decisiones en la industria textil con Machine Learning? Después de decidir que queríamos responder a la incógnita decidimos la industria y…
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
La Paz. 2021
El proyecto comenzó con una pregunta: ¿podemos mejorar la toma de decisiones en la industria textil con machine learning? Elegimos este sector por su importancia para Bolivia y por las dificultades que señalaba el equipo, entre ellas la competencia de productos importados y el comercio informal. Nuestro objetivo fue explorar la predicción de la productividad con un conjunto de datos disponible públicamente.
- Mercadería Ilegal que ingresa al País
- Ropa usada
- Prendas chinas
Porque vimos estos problemas y creemos que Bolivia puede mejorar su competitividad escogimos al sector de la industria textil para aplicarle Machine Learning.
DESARROLLO
Encontramos el dataset en Kaggle, este tenía las siguientes variables (están traducidas al español al lado):
fecha – Fecha ()
smv – valor promedio por trabajo
day – Dia (Lun-Dom)
wip – trabajos en cola
quarter – 5 periodos / mes
over time – sobrehora
department – departamento
incentive – incentivo
teamno – # de equipo
idle time – tiempos ociosos
no of workers – # de trabajadores
idleman – # de trabajadores ociosos
no of style change – # de cambios
actual productivity – productividad actual
targeted_productivity – productividad esperada
Tras explorar las variables del conjunto de Kaggle, detectamos valores ausentes en SMV. Examinamos su distribución y decidimos sustituir esos valores por la media para preparar los datos para el modelado.
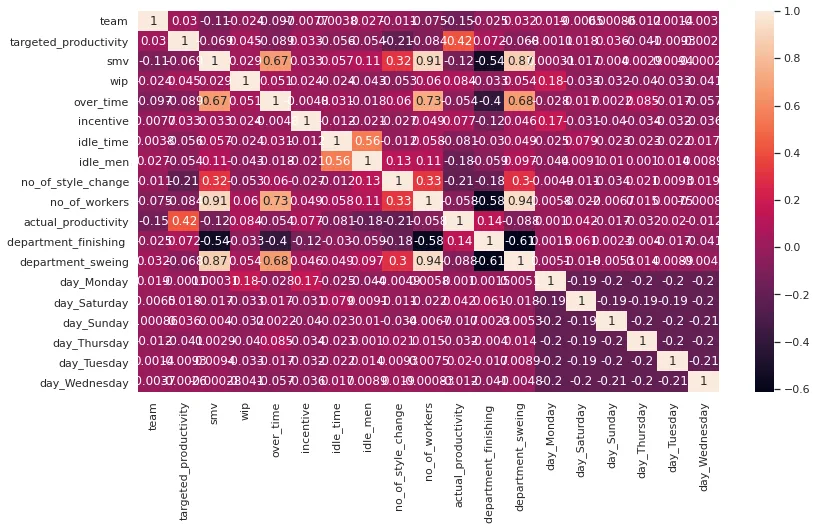
Comenzamos planteando un problema de regresión, pero los resultados iniciales no fueron satisfactorios. Decidimos reformular la variable objetivo como categorías y probar modelos de clasificación. Normalizamos los datos y examinamos la matriz de correlación que se muestra a continuación.
Después probamos distintos modelos de clasificación. AdaBoost obtuvo el mejor resultado predictivo en nuestra evaluación.
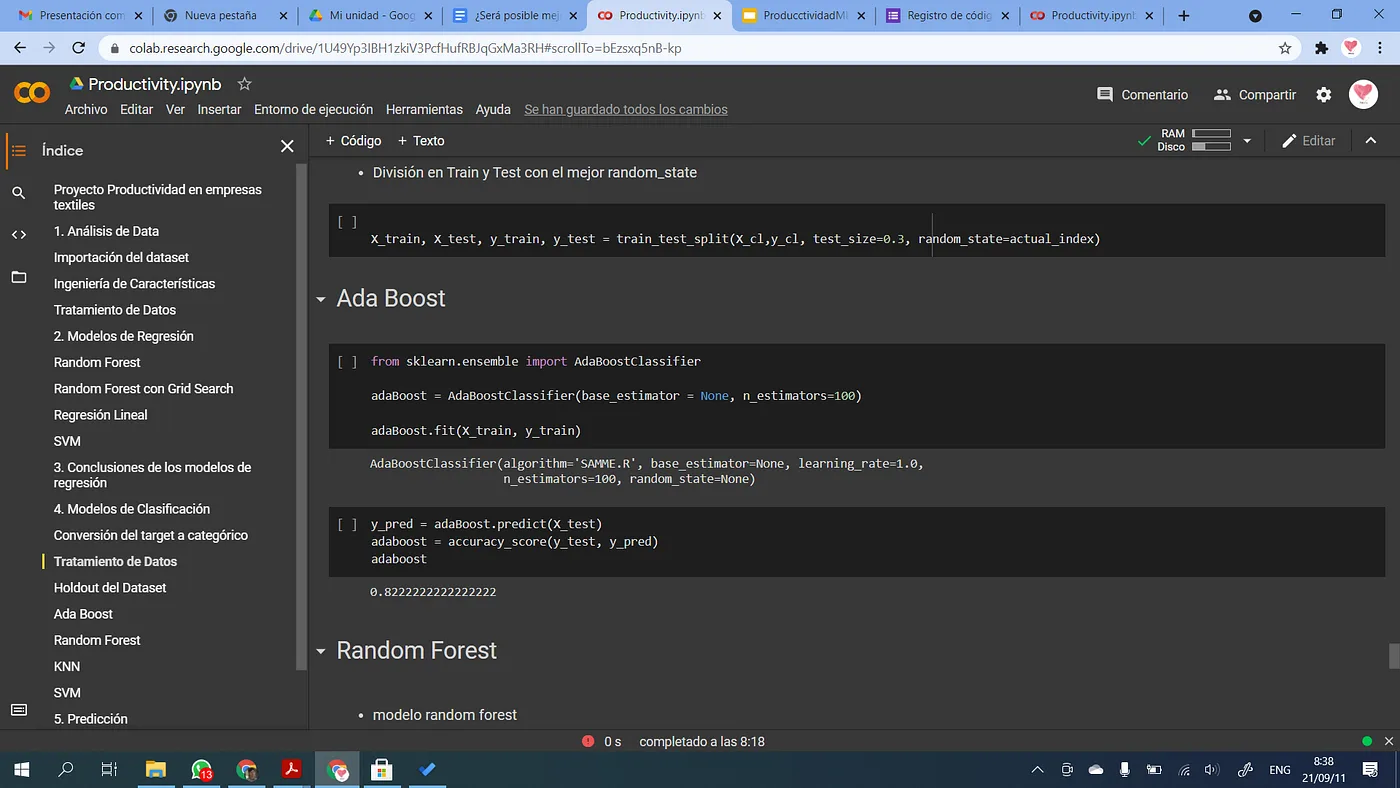
Logramos un 0.82 de accuracy lo cual fue simplemente increible despues de ver como otros métodos no llegaban ni al 0.50, decidimos probar con varios modelos adicionales como Random Forest, pero la precisión era menor (no por mucho)
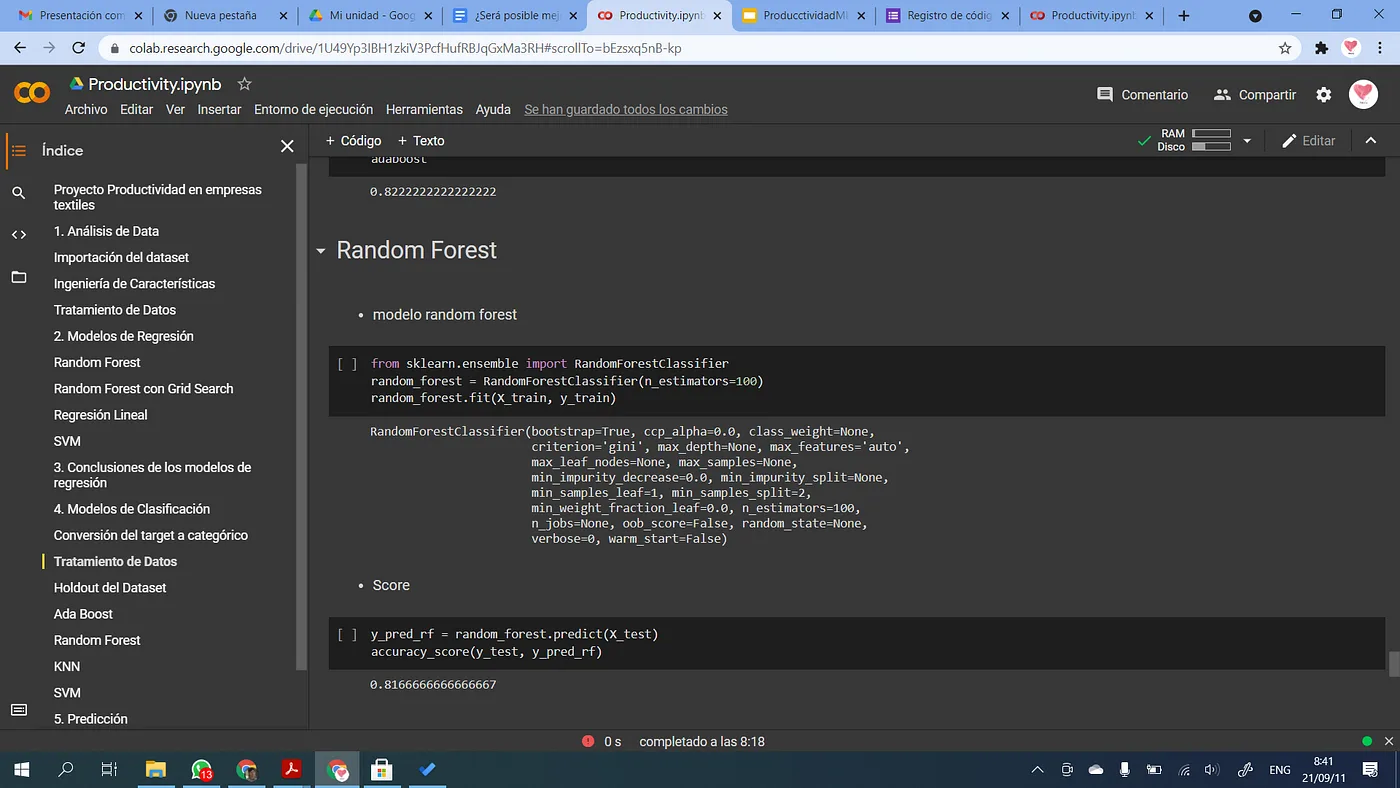
Al final nos quedamos con Adaboost y logramos un trabajo excelente.
CONCLUSIONES
- Con los modelos de regresión de acuerdo al rendimiento (scores de 0.5) calculado, no se acomodan al dataset propuesto, se realizó un tratamiento al target para volver un problema de clasificación.
- Los modelos de clasificación aplicados al dataset dieron resultados favorables en especial Adaboost con un score de 0.82
- El proceso nos permitió aprender a reformular un problema de regresión como uno de clasificación. Las métricas de ambas tareas no son directamente comparables.
Saturdays.AI
Autoría
Jhonpoolcastro Jcs
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 2 ene 2022.
← Más historias de la comunidad