Identificar violencia en la música con Inteligencia Artificial. ¿Oímos o escuchamos música?
Un proyecto de NLP que analiza letras de canciones para explorar la detección de contenido violento, con una muestra inicial de 500 canciones y etiquetas del equipo.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
Latinoamérica en línea. Primera Edición. 2020
¿Te has parado a pensar qué escuchan tus hijos?
¿Alguna vez has pensado cómo influye la música en nuestra sociedad y viceversa?
Actualmente estamos rodeados de una gran cantidad de música que, aunque tiene ciertos filtros y criterios para su publicación, en ocasiones llega a oídos de cierta población que resulta afectada por el mensaje que se transmite. Hoy en día ya no es necesario contar con una disquera para promocionar una canción, ya que el acceso a las redes sociales permite que cualquier persona con un celular y acceso a internet se grabe y publique su canción llegando a miles de personas en el mundo, entre ellos menores de edad, como tus hijos.
Para que una canción llegue a ser escuchada existen varios canales de distribución como televisión, radio y las redes sociales, y si no se cuenta con un filtro adecuado, todo tipo de canciones con diferente contenido puede estar llegando a los oídos de menores de edad.
Nuestra propuesta busca identificar contenido violento en las letras de canciones. Nos basamos en el artículo “La violencia contra las mujeres en la música: Una aproximación metodológica”[1], que analiza la violencia contra las mujeres en la música y señala:
“en los casos más negativos se proyecta estereotipos que sitúan al hombre y a la mujer en posiciones sociales distintas, incluso llegando a justificar y potenciar la violencia contra las mujeres“.
Es por ello que este proyecto tiene como ambición contribuir al cumplimento de uno de los diecisiete Objetivos de Desarrollo Sostenible, en particular el objetivo 5 sobre igualdad de género. Queremos ayudar a quienes escuchan música en plataformas digitales a reflexionar sobre los mensajes de las canciones.
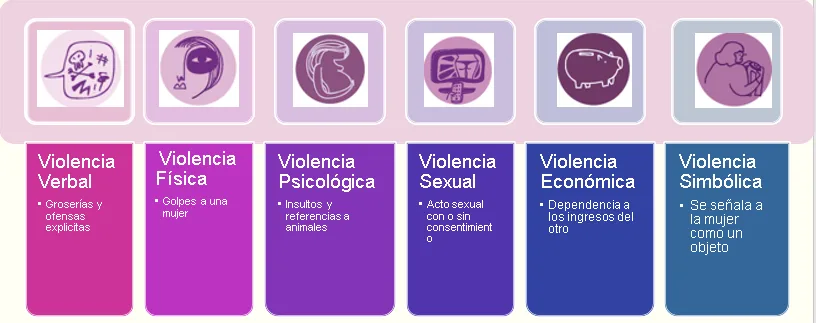
Al inicio del proyecto imaginamos una aplicación que, al introducir una canción, indicara posibles tipos de violencia en su letra mediante procesamiento del lenguaje natural (NLP). Propusimos las siguientes etiquetas:
Tipos de violencia según artículo “La violencia contra las mujeres en la música: Una aproximación metodológica”, algunos iconos fueron obtenidos del artículo “De qué hablamos cuando hablamos de violencia contra la mujer”, de .infojusnoticias.gov.ar
Revisión de la idoneidad para menores
La etiqueta «sin violencia» no garantiza que una canción sea adecuada para menores: una persona adulta debe revisar también el mensaje y el contexto.
Extracción de datos
Para ello, se empezó a analizar una muestra de 500 canciones, las cuales se seleccionaron de listas de popularidad de música latina, ya que el proyecto se plantea para la población hispanoparlante de América Latina, por lo que el flujo de trabajo quedó de la siguiente manera:
Se buscó en los rankings de Billboard y de Scanner Sound, la lista de canciones más tocadas con un web scraper, con lo que se obtuvo artista y título.
Con la API de Musixmatch obtuvimos el género musical y la indicación de lenguaje explícito. En aquel momento, el acceso utilizado solo nos facilitaba el 40 % de la letra.
De Google se obtuvo la letra de las canciones el cual se nutre de dos proveedores: Musixmatch y LyricFind, con lo que, finalmente, se obtuvieron los siguientes campos:
- Artista
- Género
- Título
- Si es explícita o no (lenguaje inapropiado)
Luego, se realizó la extracción de las letras de las canciones mediante API’s que ofrecen los sitios más populares de música (Musixmatch y el Billboard) mediante sus herramientas para desarrolladores.
Una vez que se obtuvieron las letras de las canciones se procedió al etiquetado manual, el cual se realizó de acuerdo a los tipos de violencia anteriormente expuestos. El equipo desarrollador de este proyecto, etiquetó las categorías de entrenamiento, con lo que se obtuvo una siguiente fuente de datos, su representación se puede ver a continuación:
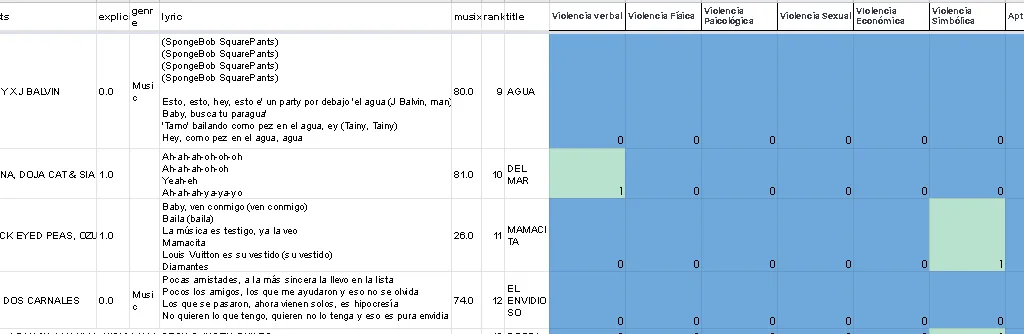
Ejemplo de conjunto de datos obtenido en un primer etiquetado
Resulta importante destacar que, debido a que el etiquetado de cada categoría está sujeto a los criterios de cada integrante del equipo, el conjunto de datos podría tener un sesgo. Vale la pena mencionar, que esta etapa del proyecto es una prueba de concepto que nos servirá para validar la factibilidad de realizar un etiquetado automático de acuerdo al objetivo planteado. Además, al observar que el número de positivos en cada categoría no era suficiente para que el algoritmo pudiese tener un buen aprendizaje, se decidió agregar una categoría adicional, llamada ‘clase’, la cual indica si tiene contenido violento. Este cambio dentro del alcance se abordará más adelante.
EDA
Después realizamos un análisis exploratorio de datos (EDA) con pandas, matplotlib, seaborn y Plotly. Estudiamos la distribución de las clases antes del preprocesamiento y preparamos un corpus para el análisis del lenguaje.
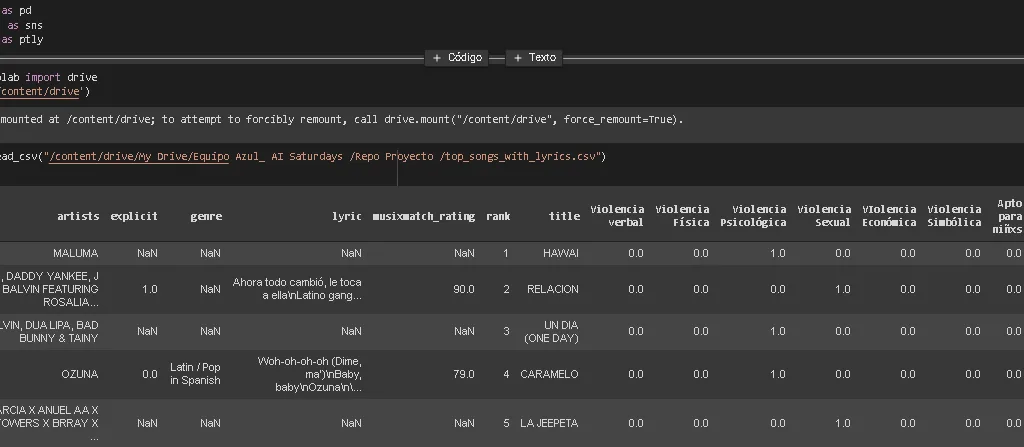
El primer análisis exploratorio de datos (EDA) nos permitió observar lo siguiente:
Análisis/distribución de tipos de violencia
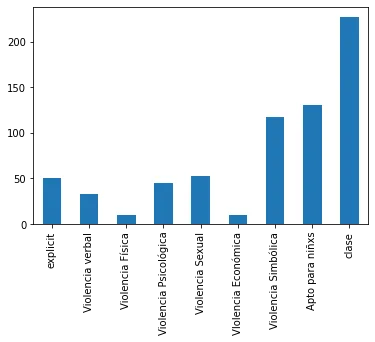
Gráfica de Barras que muestra el número de incidencias en cada clase del ‘data set’
En esta gráfica de barras podemos observar la distribución de los tipos de violencia que contiene la música seleccionada, en este caso, la mayor predominancia son géneros musicales de reggaeton, regional mexicano y pop en español debido a que se obtuvieron las canciones más escuchadas del momento, sin embargo, esta información no se utilizará para el algoritmo ya que podría crear un sesgo importante, como se puede observar en el histograma de acuerdo a los géneros. Vale la pena mencionar que este análisis se hizo antes de normalizar los datos para tener un panorama de cómo están distribuidos los datos.
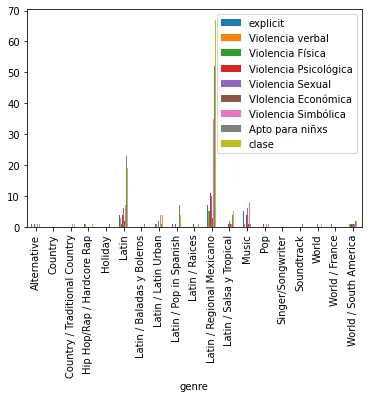
Gráfica de barras que muestra cómo se distribuyen los tipos de violencia por género musical.
Se realizó un mapa de calor para descubrir cómo se relacionan los tipos de violencia dentro de las canciones que se consideraron.
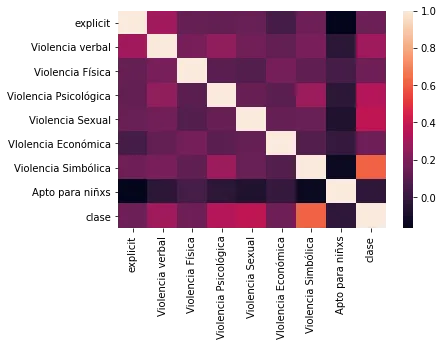
Después del análisis de los tipos violencia, consideramos que separar la cantidad de canciones en las siete categorías seleccionadas no sería suficiente para hacer una buena clasificación ya que tenemos relativamente pocos positivos en cada categoría. Con base en esta observación, para una primera fase, se realizará la separación solo en 2 categorías: “violento” y “no violento”. Algo muy importante de destacar es, que aunque una canción no contenga violencia, no quiere decir que sea apto para infantes, debido a que podría tocar temas no aptos para ciertas edades.
Análisis con mapas de palabras con y sin la etiqueta de violencia
En una segunda aproximación, durante el preprocesamiento de los datos se obtuvieron mapas de palabras, como un segundo EDA, con el fin de identificar las palabras más frecuentes en contenido violento y no violento y reconocer algunas “stopwords” que debemos considerar o, en dado caso, palabras que deban lematizarse.
El preprocesamiento de los datos, en este caso, se realizó de la siguiente manera:
Normalización datos/letras de canciones (acentos, mayúsculas, signos de puntuación y eliminación de palabras como ‘oh’, ‘yeah’, ‘ma’, etc.)
Tokenizado de palabras
Remoción de ‘stopwords’
Lematización (en una siguiente etapa se considera ver si ‘stemming’ podría ayudar a obtener mejores resultados)
Vectorización de las canciones (en esta etapa del proyecto se emplea Bag of Words).
Tras el preprocesamiento volvimos a generar nubes de palabras. En ambas clases predominaban «haber», «querer», «hacer» y «tener», así que las añadimos a nuestra lista de palabras vacías y repetimos el análisis. Esta decisión depende de la tarea: eliminar palabras frecuentes también puede hacer que se pierda contexto.
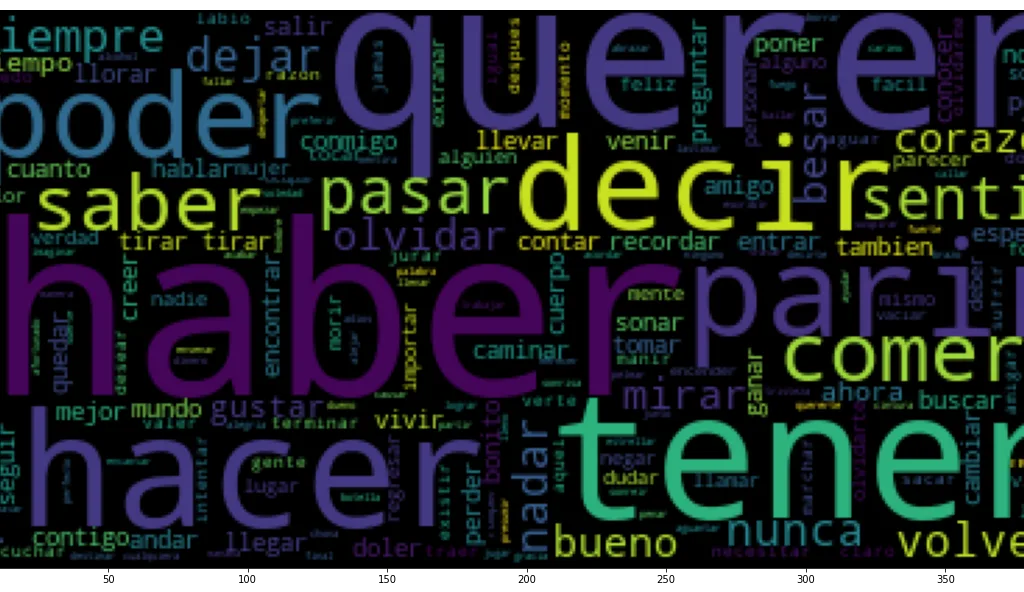
mapa de palabras «sin violencia» antes de quitar stop words muy comunes
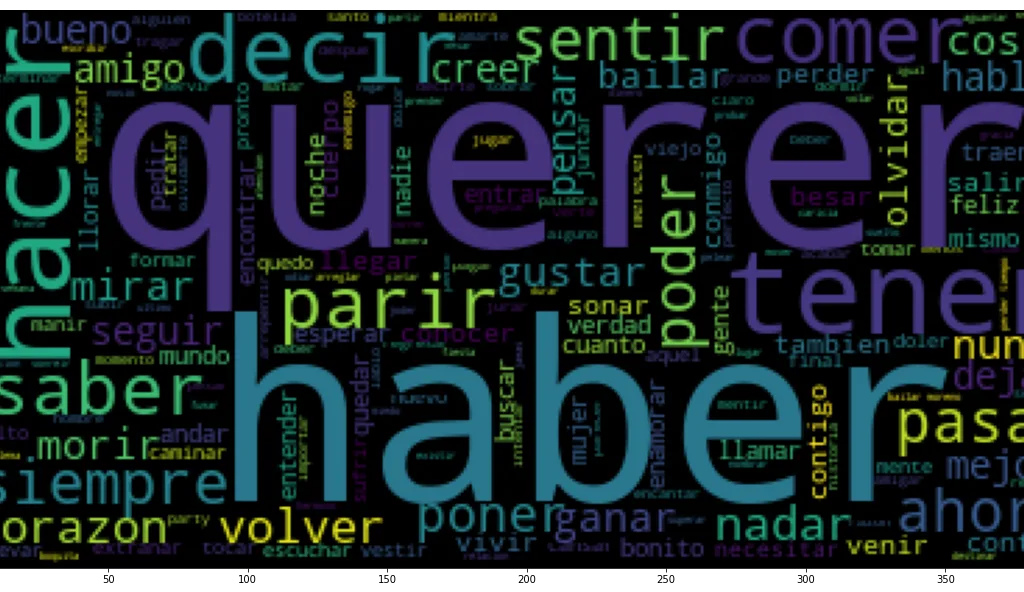
mapa de palabras «con violencia» antes de quitar stop words muy comunes
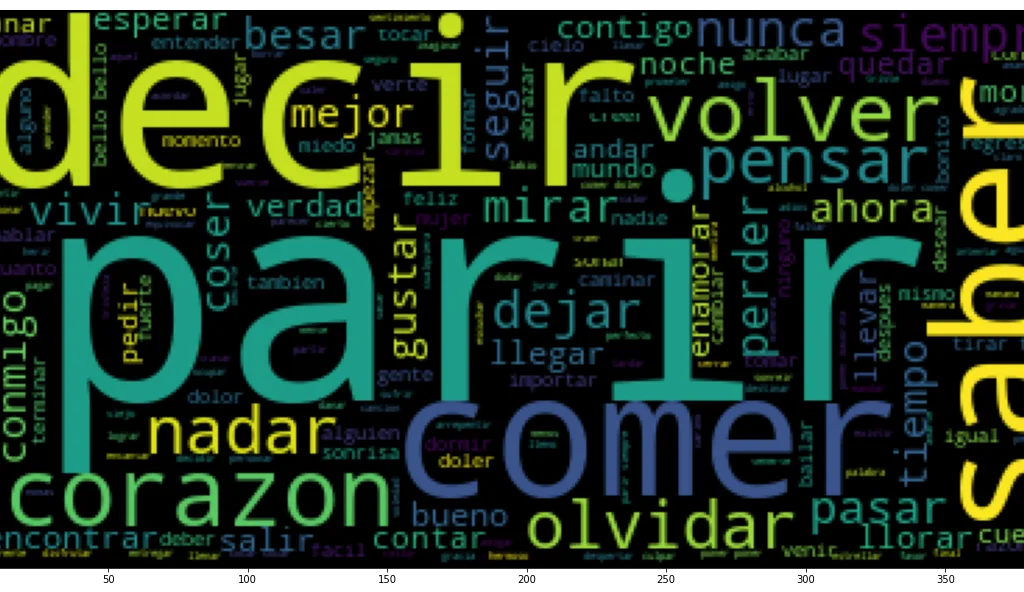
mapa de palabras «sin violencia» después de quitar stop words muy comunes
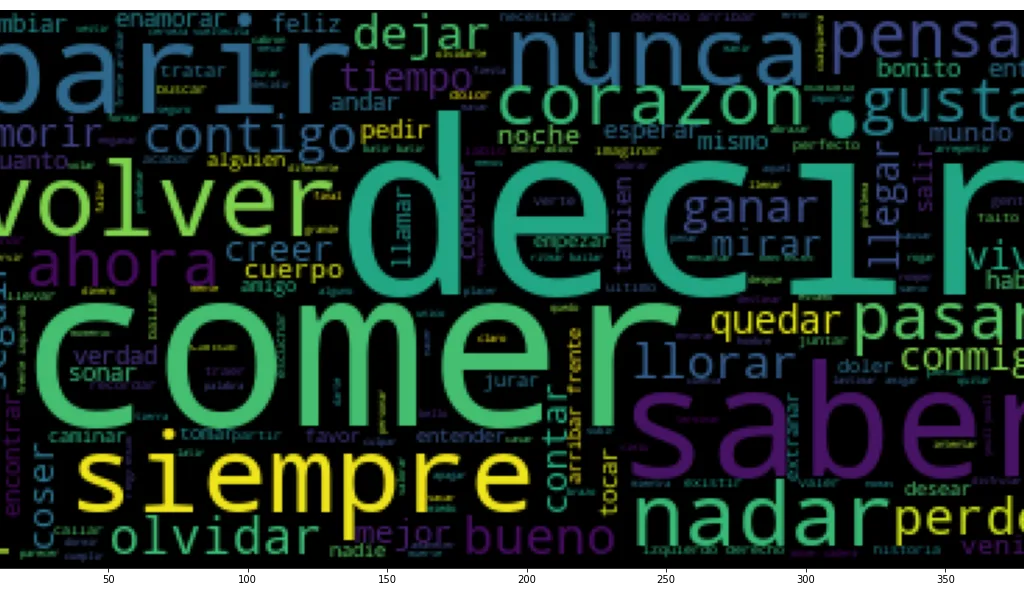
mapa de palabras «con violencia» después de quitar stop words muy comunes
Como se puede observar, ambas clasificaciones siguen teniendo algunas palabras en común como “decir” y “saber”. Sin embargo, se pueden observar diferentes palabras en el mapa de las canciones ‘con violencia’, como “olvidar”, “morir”, “perder”, “dejar”, etc.
Una vez preparado el corpus y aplicada la representación de bolsa de palabras, trabajamos con las etiquetas «con violencia» y «sin violencia», según el criterio de anotación del equipo.
Entrenamiento y selección del modelo
Se probó con diferentes algoritmos, después de aplicar la representación ‘bag of words’ y usando la técnica de lematización con las herramientas de nltk, para los modelos se ocuparon las librerías de sklearn como Naive Bayes, Random Forest, Decision Tree, SVM y SGD.
Para cada modelo revisamos el informe de clasificación, la exactitud (accuracy), la puntuación F1 y la matriz de confusión.
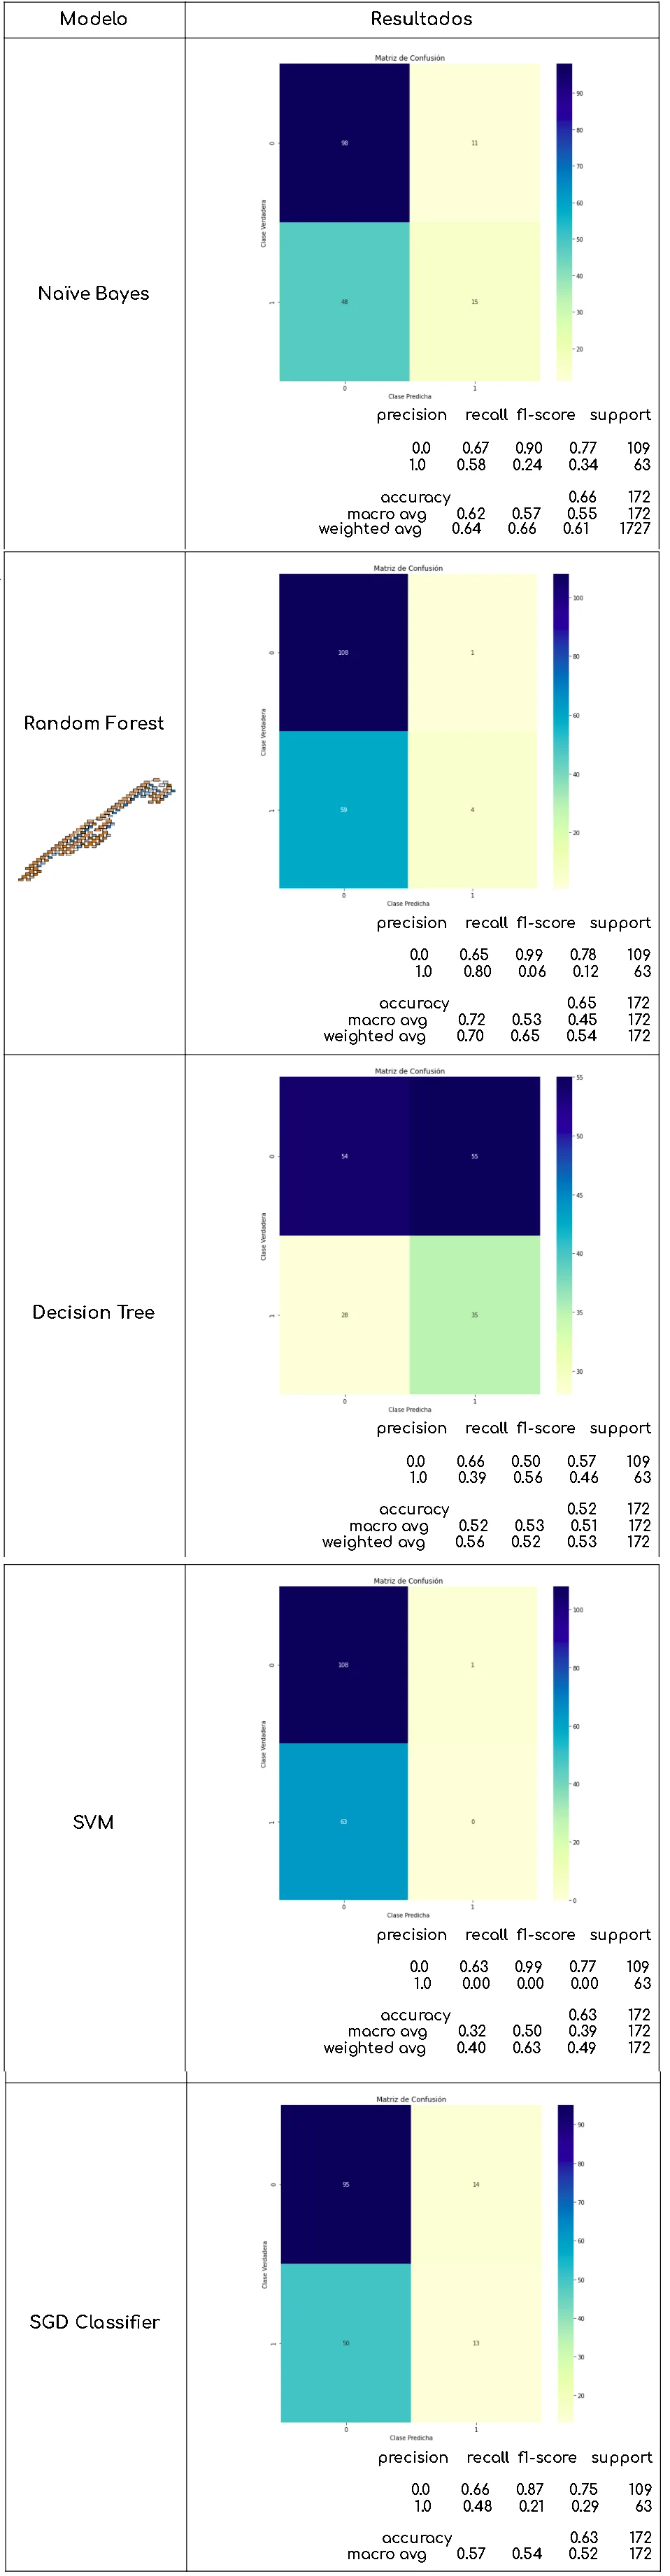
Resultados obtenidos de los clasificadores, matriz de confusión y métricas obtenidas con las librerías sklearn y seaborn
También utilizamos curvas ROC para comparar visualmente el comportamiento de los modelos a distintos umbrales.
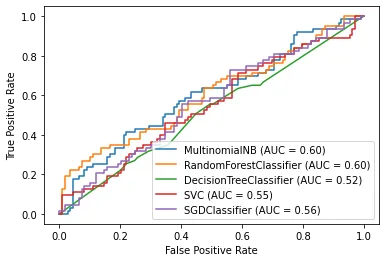
Curvas ROC de los modelos obtenidas con las librerías sklearn y matplotlib
Curvas ROC de los modelos
Como se observa en la gráfica de curvas ROC, los modelos que tuvieron mejor desempeño fueron ‘Random Forest’ y ‘Naïve Bayes’, que tienen resultados muy similares. Sin embargo, si observamos las matrices de confusión y el ‘F1 Score’ podemos concluir que con los datos que se tienen, ‘Naïve Bayes’ es el modelo que mejor comportamiento tiene en esta etapa del proyecto. Ya que para nosotros es mejor tener una etiqueta de violencia aunque no la tenga, a que una canción con violencia sea erróneamente clasificada y llegue a menores de edad. Es decir, en términos técnicos es mejor para nosotros tener un error tipo I (falsos positivos), a un error tipo II (Falsos negativos).
Escalabilidad del proyecto
Con los datos disponibles entrenamos una clasificación binaria: «con violencia» o «sin violencia». No teníamos suficientes ejemplos por categoría para abordar los tipos de violencia por separado. Con más datos etiquetados, podríamos explorar tres o cuatro categorías y evaluar si se distinguen de forma fiable.
De obtener buenos resultados, se podría crear una API para uso en aplicaciones móviles o como plug in, con el fin de facilitar el reconocimiento de una canción y saber si dicha canción tiene o no contenido violento.
El conocer de antemano si una canción tiene o no contenido violento, será de ayuda para empoderar a los usuarios y reflexionar sobre el impacto que tiene lo que se escucha en la cultura popular sobre nuestras vidas y la cultura de la población.
El proyecto también planteó explorar su utilidad para estudiar la «violencia mediática», un concepto relacionado con las reformas conocidas como Ley Olimpia en México. La noticia citada, publicada en noviembre de 2020 [2], resume las siguientes conductas; el clasificador no permite determinar por sí solo si una canción infringe la ley:
Todo acto que a través de cualquier medio de comunicación:
-Promueva estereotipos sexistas.
-Haga apología de la violencia contra mujeres y niñas.
-Produzca o permita la producción y difusión de discursos de odio sexista.
-Promueva la discriminación de género o desigualdad entre mujeres y hombres.
-Cause daño a las mujeres y niñas de tipo psicológico, sexual, físico, económico, patrimonial o feminicida.
Ejemplo de API con el logo del equipo desarrollador
Glosario:
NLP: procesamiento del lenguaje natural (Natural Language Processing), el área de la IA que estudia cómo las computadoras procesan el lenguaje humano.
Corpus (pl. corpora): Un corpus lingüístico es un conjunto amplio y estructurado de ejemplos reales de uso de la lengua. Estos ejemplos pueden ser textos (los más comunes), o muestras orales (generalmente transcritas). [3]
Lematización: Relaciona una palabra flexionada con su lema, la forma que suele aparecer como entrada en un diccionario.
Palabra de parada: Palabras muy comunes y poco informativas desde el punto de vista léxico, tales como conjunciones (y, o, ni, qué), preposiciones (a, en, para, por, entre otras) y verbos muy comunes (ser, ir, y otros más).[4]
Referencias:
- Gómez Escarda, María; Pérez Redondo, Rubén J. (2016). “La violencia contra las mujeres en la música: Una aproximación metodológica”. Universidad Rey Juan Carlos, España.
- Robles De la Rosa, Leticia (Noviembre 2020). Aprueban ‘Ley Olimpia’ para todo el país; establecen delito en el Código Penal Federal. Excélsior. https://m.excelsior.com.mx/nacional/aprueban-ley-olimpia-para-todo-el-pais-establecen-delito-en-el-codigo-penal-federal/1415366
- Werner, Welte; Meno Blanco, Francisco (1985). Lingüística Moderna: Terminología y Bibliografía. Madrid: Gredos.
- Urdaneta Fernández, Lino Alberto (4 Mayo 2019). Reducir el número de palabras de un texto: lematización y radicalización (stemming) con Python. Medium. https://medium.com/qu4nt/reducir-el-n%C3%BAmero-de-palabras-de-un-texto-lematizaci%C3%B3n-y-radicalizaci%C3%B3n-stemming-con-python-965bfd0c69fa
Integrantes
- Álvarez Leandro
- Cuadros Alejandra
- Morales Leobardo
- Ramírez Héctor
- Samaniego Luis
Presentación del proyecto: DemoDay
Repositorio
En el siguiente repositorio se encuentra el código usado para desarrollar esta aplicación:https://github.com/SaturdaysAI/Projects/tree/master/LATAM_remote/NLP_Violencia-en-musica–master
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 16 mar 2022.
← Más historias de la comunidad