Clasificación de idiomas originarios de Bolivia con Machine Learning
Un proyecto de La Paz que utiliza procesamiento del lenguaje natural para distinguir frases en quechua y español, con sus resultados y limitaciones.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
La Paz. 2021
Usamos técnicas de Machine Learning para la clasificación de idiomas.
Bolivia busca preservar sus lenguas indígenas, pero sigue siendo difícil encontrar recursos para aprenderlas. Por eso propusimos una herramienta de clasificación de idiomas con aprendizaje automático: una base para tareas como la traducción, el análisis de sentimientos o la conversión entre voz y texto. El modelo utiliza procesamiento del lenguaje natural (NLP) y obtuvo una exactitud superior al 99 % en la evaluación del proyecto.
Desde 2006 Bolivia es líder en la defensa y reivindicación de los pueblos y las culturas indígenas en su territorio y en el mundo.
“Hoy en día, las 36 lenguas originarias en Bolivia son idiomas oficiales. En Bolivia se tiene que hablar y enseñar inicialmente un idioma originario» [1].
¿Se traduce todo este trabajo en mejores oportunidades para aprender y utilizar las lenguas originarias de Bolivia?
Descripción del problema
Aunque en Bolivia se trabaja para preservar las lenguas indígenas, sigue siendo difícil acceder a recursos para aprenderlas. La tecnología puede ayudar: identificar el idioma de un texto es un primer paso para desarrollar herramientas de traducción y de conversión entre texto y voz.
Sin embargo, actualmente se puede usar la tecnología como un aliado para solucionar este problema y la detección de idiomas es un punto inicial y primordial para crear herramientas de traducción automática de texto, de conversión de texto a voz, voz a texto, voz a voz, entre muchas otras aplicaciones.
Objetivo
Crear una herramienta con Machine Learning capaz de identificar y clasificar idiomas originarios de Bolivia, para agilizar tareas relacionadas como la traducción, recuperación de la información, etc.
Límites y alcances
LÍMITES: Debido a la dificultad de conseguir un conjunto de datos suficientemente grande de los idiomas más hablados en Bolivia (quechua, guaraní, aymara), solo nos centramos en el idioma quechua.
ALCANCES: La herramienta de identificación, en una primera etapa, será capaz de clasificar el idioma de frases ya sea como quechua o español.
Metodología
Para la clasificación de idiomas mediante Machine Learning se utilizó una metodología iterativa incremental, que conlleva las siguientes fases:
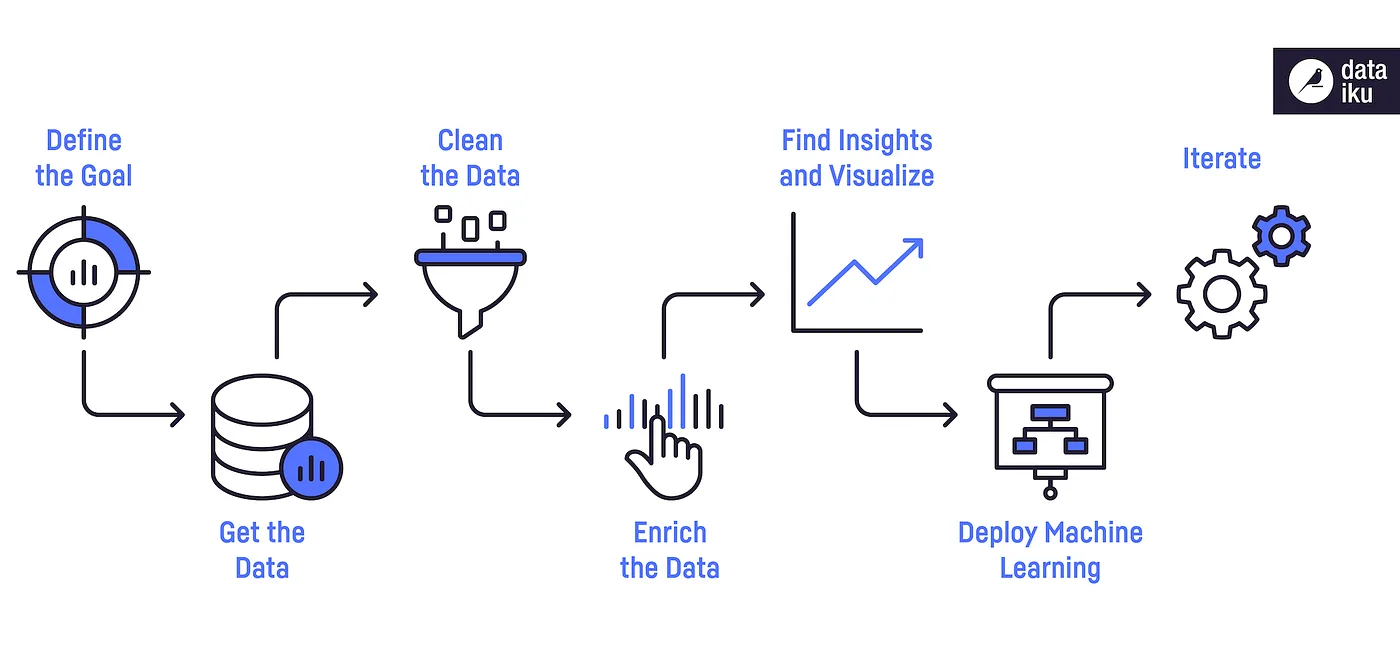
Figura 1. Metodología (Dataiku)
Captura de datos
Posterior a la creación del dataset nos dimos cuenta que éste estaba desbalanceado porque el número de frases en quechua duplicaban el de español, por esa razón decidimos balancear los datos agregando frases de español obtenidos de un dataset de Kaggle.
Figura 2. Captura de datos (Imagen extraída de un sitio web)
Pre-procesamiento
En esta etapa se realizaron diversas formas de pre-procesamiento, desde la ingeniería de características (feature engineering) hasta la vectorización. Las cuales se describen a continuación.
Limpieza de caracteres irrelevantes
Las frases en español de Kaggle tenían caracteres de otros idiomas e irrelevantes para la clasificación, es por ello que antes de unir con el dataset que se tenía se pasó a realizar una limpieza de todos esos caracteres de las frases de Kaggle. Una vez unido el dataset aún se tenían caracteres que no aportaban información como: dígitos, signos de puntuación, etc. y por tanto se realizó una limpieza de estos caracteres.
Técnicas implementadas
Al examinar el conjunto de datos detectamos un registro mal tabulado y lo marcamos como nulo. Como el conjunto inicial solo contenía el texto de cada frase y su etiqueta, en esa fase no aplicamos reducción de dimensionalidad.
Análisis de los features
Cada idioma tiene sus propias reglas gramaticales y el idioma Quechua no es ajeno a eso, por ende se investigó las reglas de este idioma y se pudo notar ciertas características interesantes que lo diferencian de otros idiomas, por mencionar algunas:
- El alfabeto quechua cuenta con 28 consonantes (algunas consonantes son diferentes al de español como: ch’, chh, qh, p’) y 3 vocales (a, i, u)
- Las consonantes del quechua se clasifican según el modo de articulación, algunas de estas son:
- Oclusivas (p, t, k, q)
- Aspiradas (ph, th, chh, kh, qh)
- Glotalizadas (p’, t’, ch’, k’, q’)
- Semiconsonantes (w, y)
3. Para diferenciar el género de una persona se usan las palabras: warmi y qhari
4. La interrogación en el quechua se realiza agregando a la palabra el sufijo -chu.
Estas y muchas más características de la gramática Quechua, así como la gramática del Español fueron tomadas en cuenta para realizar las gráficas, las cuales nos permiten corroborar estas diferencias entre las reglas gramaticales en el dataset.
Uno de los gráficos que realizamos fue la frecuencia de las vocales por idioma en el dataset (Figura 3). La frecuencia de las vocales fueron calculadas según el número de caracteres de cada frase.
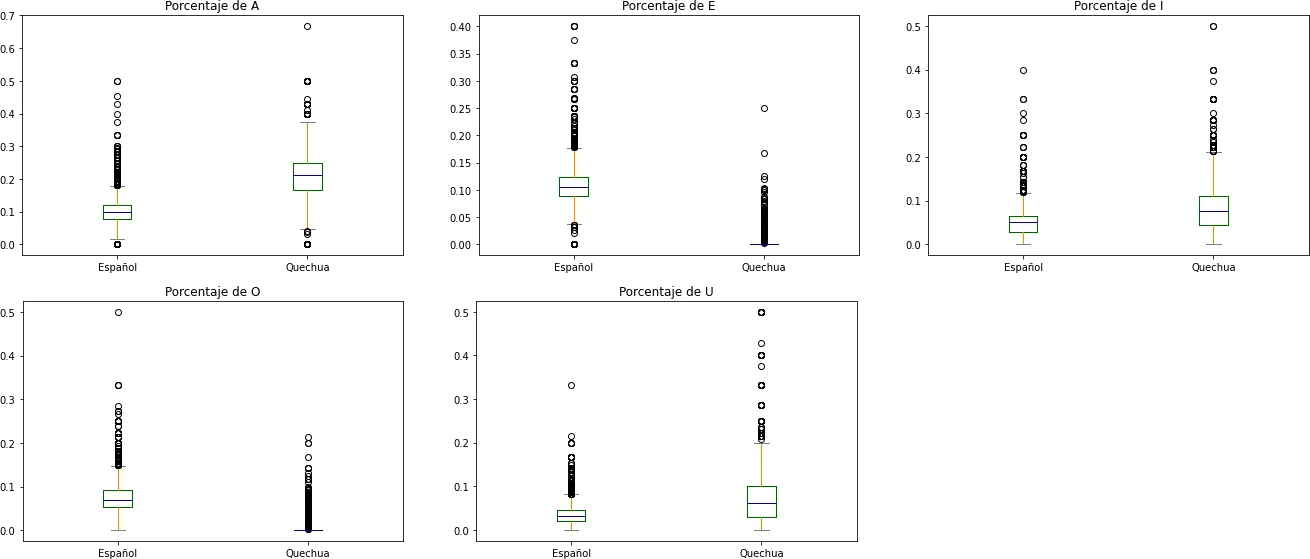
Figura 3. Frecuencia de vocales (Elaboración propia)
Otras gráficas que realizamos fueron la frecuencia de las consonantes como: K, H, M, R (Figura 4) y caracteres especiales como: á, é, í, ó, ú, ä, ü, ‘ (Figura 4), según el idioma.
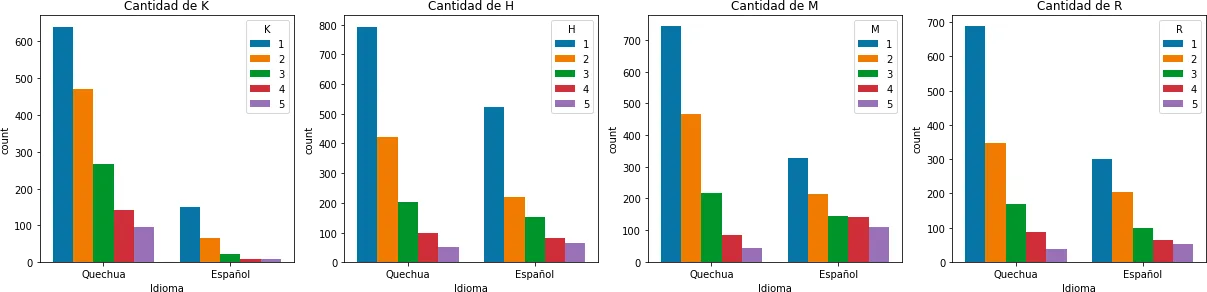
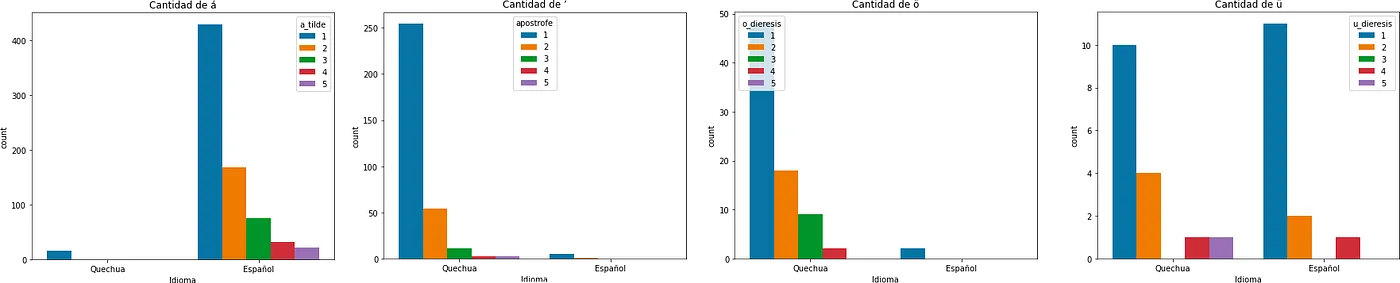
Figura 4. Histograma de caracteres (Elaboración propia)
Estas gráficas nos permitieron aclarar algunas dudas sobre las diferencias gramaticales entre el idioma Español y Quechua, y representaron un punto clave para realizar el pre-procesamiento de los datos.
Por las diferencias de algunas letras y caracteres utilizados para cada idioma, además de ciertos sufijos o prefijos propios, numeración y demás características, decidimos vectorizar las frases según el modelo n-gram de caracteres. Para capturar características importantes en ambos idiomas delimitamos el modelo n-gram de 1 a 5, esto por temas de rendimiento y también porque consideramos que este número nos permite abstraer aquellas características gramaticales que citamos anteriormente.
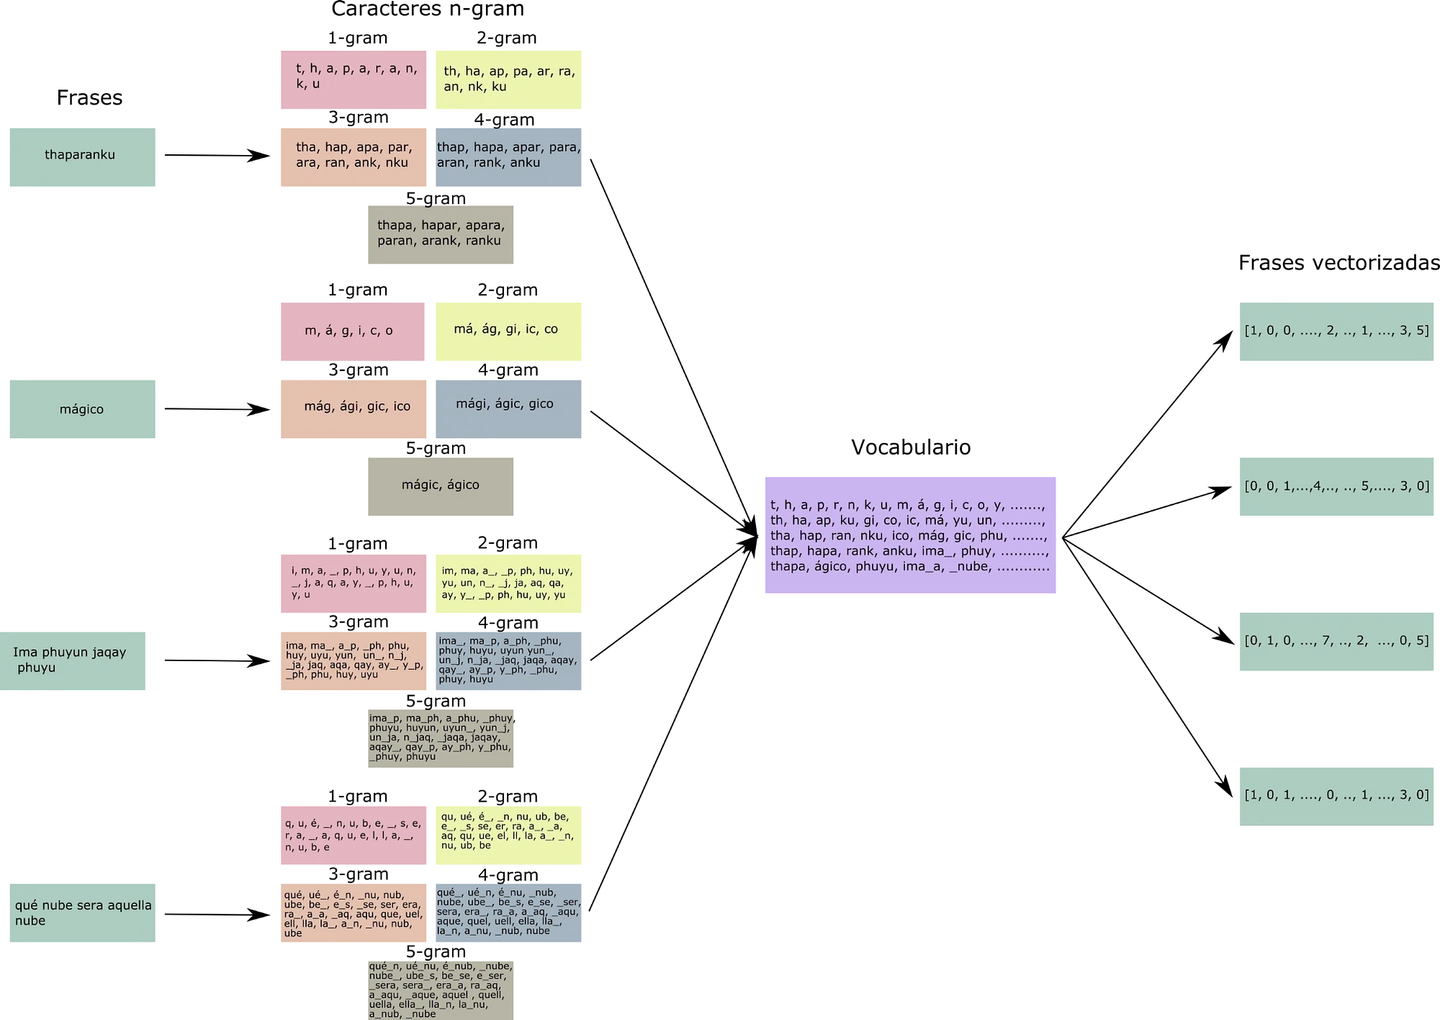
Figura 5: Pre-procesamiento y vectorización de los features (Elaboración propia)
Además de vectorizar las frases según la frecuencia de caracteres únicos que tiene cada frase se aplicó la frecuencia TF-IDF, medida estadística que evalúa cuán relevante es un término para un documento en una colección. En este caso cada término es representado por cada carácter y el documento es representado por la frase del idioma en el dataset (colección de frases).
Selección y evaluación de modelos
Con los datos listos se procedió a construir los modelos de predicción. Se utilizaron modelos de clasificación debido a que tenemos un problema de clasificación binaria, sólo se tienen dos posibles etiquetas, “Quechua” y “Español”.
Por lo tanto, se utilizaron los siguientes algoritmos de aprendizaje supervisado:
- Naive Bayes
- Support vector Machine
- Logistic regression
Para encontrar la mejor combinación de hiperparámetros se utilizo GridSearch de la biblioteca Sklearn.
Las matrices de confusión para los 3 modelos son:
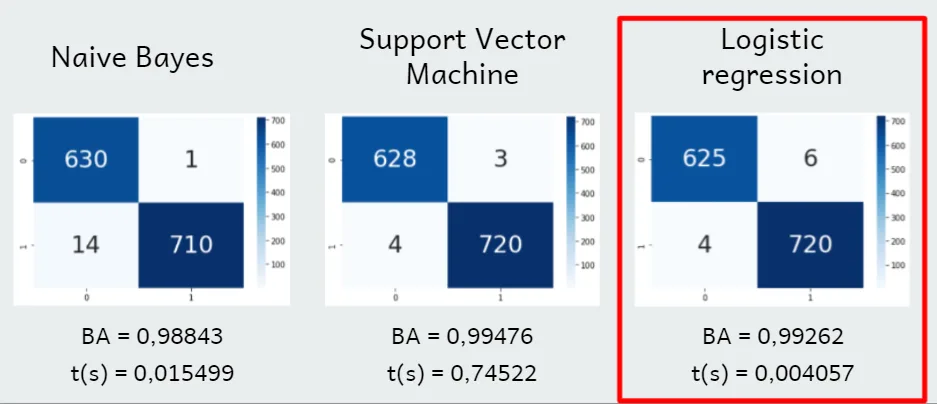
Figura 6. Matrices de confusión, balanced accuracy y tiempo de ejecución de los 3 modelos (Elaboración propia)
Clasificación de nuevos datos
Una vez seleccionado nuestro mejor modelo, es necesario probarlo con algunas frases nunca antes vistas, por ello probamos frases que solo contienen palabras de un idioma, frases que contienen palabras de ambos idiomas que es usual en el habla coloquial de los quechua hablantes y por último una frase sin sentido. Nuestro modelo seleccionado se comporta bien con los dos primeros tipos de frases, sin embargo, al ingresar frases sin sentido que no pertenece ni al español o al quechua, estas frases son clasificadas directamente como quechua, esto se debe a que como manejamos un modelo binario el texto ingresado sea cual sea debe etiquetarlos con una etiqueta u otra.
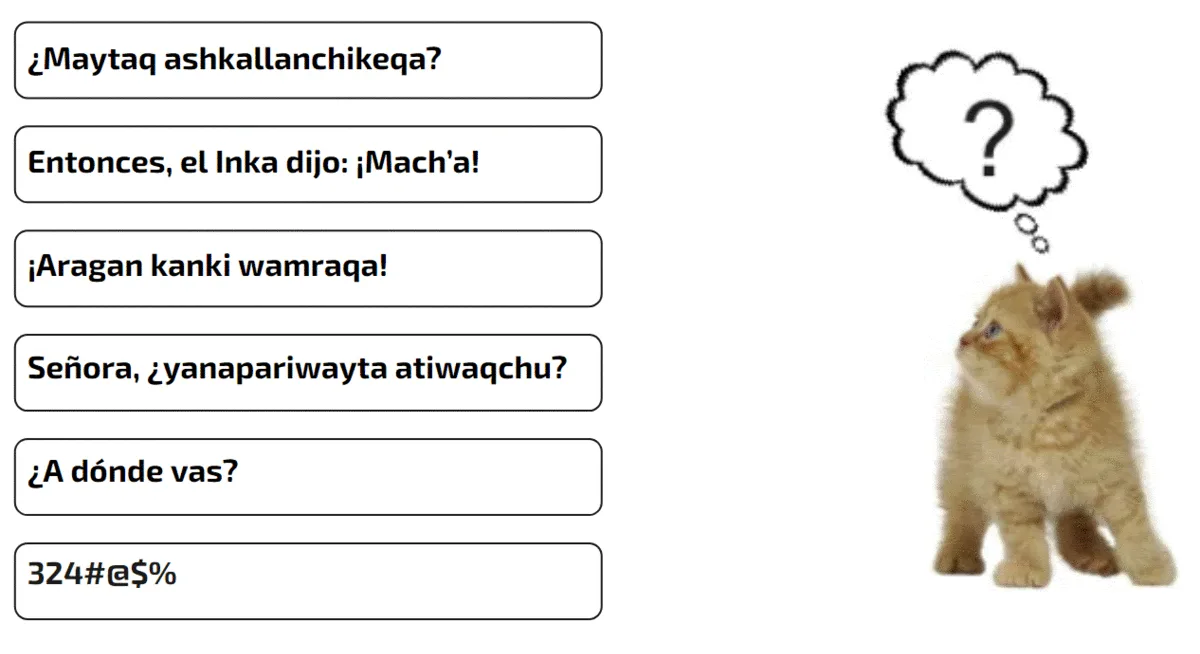
Figura 7. Resultados del modelos (Elaboración propia)
Conclusión
En la evaluación del proyecto, el modelo basado en máquinas de vectores de soporte (SVM) obtuvo el mejor resultado predictivo, con una exactitud balanceada superior al 99 %.
Específicamente, el modelo funciona bien para clasificar Español y Quechua dada la alta precisión, y puntajes f1 para estos dos idiomas.
Aunque SVM obtuvo la mejor exactitud, la regresión logística ofreció un buen equilibrio entre exactitud y tiempo de ejecución: superó también el 99 % y fue más rápida, algo relevante para aplicaciones en tiempo real.
Se logró abstraer algunas características del idioma quechua, por lo que es posible realizar el mismo análisis con otros idiomas originarios de Bolivia
Trabajos futuros
Si bien este problema aparenta ser sencillo es un paso necesario para:
- Traducción automática
- Detección del idioma para asistentes conversacionales
- Análisis de sentimientos, etc.
El codigo fuente de este proyecto se puede encontrar en: GitHub
Referencias
ONU – Bolivia, a la vanguardia en la protección y promoción de las lenguas indígenas
Autoría
EVELYN CUSI LOPEZ
Repositorio
En el siguiente repositorio se encuentra el código usado para desarrollar esa aplicación: https://github.com/SaturdaysAI/Projects/tree/master/Lapaz/clasificacion-idiomas-machine-learning-main
¡Más Inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 19 nov 2021.
← Más historias de la comunidad