Detección de Fraude por Tarjeta de Crédito con Machine Learning
Comparamos algoritmos para detectar fraude con tarjetas de crédito en datos simulados, desde la preparación de variables hasta la evaluación con ROC AUC.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
En este artículo mostramos cómo explorar la detección de fraude con tarjetas de crédito mediante algoritmos de aprendizaje automático.
El fraude cibernético hace referencia a aquellas estafas que utilizan la red, para realizar transacciones ilícitas (Condusef, s.f). Dentro de este tipo de fraudes, el fraude con tarjetas de crédito está a la orden del día por la popularidad de las compras en línea. Bastan algunos datos de los usuarios para que un pirata informático pueda cometer el ilícito. El fraude con tarjeta de crédito, implica el uso no autorizado de la información de la tarjeta de crédito de una persona con el propósito de cargar compras en la cuenta de la víctima o extraer fondos de su cuenta (Cornell Law School, s.f). En otras palabras, es un tipo de robo de identidad.
En este escenario, la detección de fraude con Machine Learning para transacciones con tarjeta de crédito es de suma importancia. Actualmente se pierden grandes cantidades de dinero por este tipo de fraude, lo que representa un gran problema para las entidades financieras y para sus usuarios.
Frente a este tipo de situaciones, las empresas suelen reemplazar tarjetas, emprender investigaciones sobre los casos y ofrecer soporte telefónico a los clientes, lo que implica un gasto importante. Incluso con estas atenciones, se puede originar una mala reputación e imagen de la empresa, lo que eventualmente se refleja en una pérdida de clientes y de ingresos.
¿Cómo evitar o minimizar los costos por transacciones fraudulentas?
La inteligencia artificial provee de algoritmos de aprendizaje automático capaces de identificar patrones en las transacciones y detectar si determinada transacción es fraudulenta o no.
Descripción del proyecto
El objetivo general del proyecto es desarrollar un método de detección de fraude utilizando algoritmos de Machine Learning capaz de clasificar efectivamente entre transacciones legítimas y fraudulentas.
Imagen obtenida de IEEE Innovation at Work
Obtención de datos
Como no disponíamos de transacciones reales que pudiéramos compartir respetando su confidencialidad, utilizamos un simulador de operaciones legítimas y fraudulentas.
Las características esenciales que resumen una transacción son: ID de transacción, fecha y hora de transacción, ID del cliente, ID del terminal, monto de la transacción y una etiqueta que muestra si la transacción es fraudulenta o no.
La simulación consta de cinco pasos:
1. Generación de perfiles de clientes: cada cliente es diferente en sus hábitos de gasto. Esto se simulará definiendo algunas propiedades para el cliente como su ubicación geográfica, su frecuencia de gasto y sus montos de gasto.
2. Generación de perfiles de terminal: aquí, la única propiedad que se tomará en cuenta es la ubicación geográfica.
3. Asociación de perfiles de clientes y terminales: se asume que los clientes solo realizan transacciones en terminales que se encuentran dentro de un radio r, de sus ubicaciones geográficas.
4. Generación de transacciones: el simulador recorrerá el conjunto de perfiles de clientes y generará transacciones según sus propiedades.
5. Generación de escenarios de fraude: se etiquetan las transacciones como legítimas o fraudulentas, utilizando los siguientes escenarios de fraude.
a. Escenario 1: cualquier transacción cuyo monto sea superior a 220 se etiqueta como fraudulenta. (Escenario no inspirado en la realidad, se elige el valor según la distribución que sigue la variable montos).
b. Escenario 2: cada día se seleccionan al azar dos terminales. Todas sus transacciones durante los 28 días siguientes se etiquetan como fraudulentas, simulando terminales comprometidos.
c. Escenario 3: cada día se seleccionan al azar tres clientes. Durante los 14 días siguientes, un tercio de sus transacciones multiplica su importe por cinco y se etiqueta como fraudulento, simulando fraude sin tarjeta presente.
Así, se tiene el siguiente conjunto de datos:
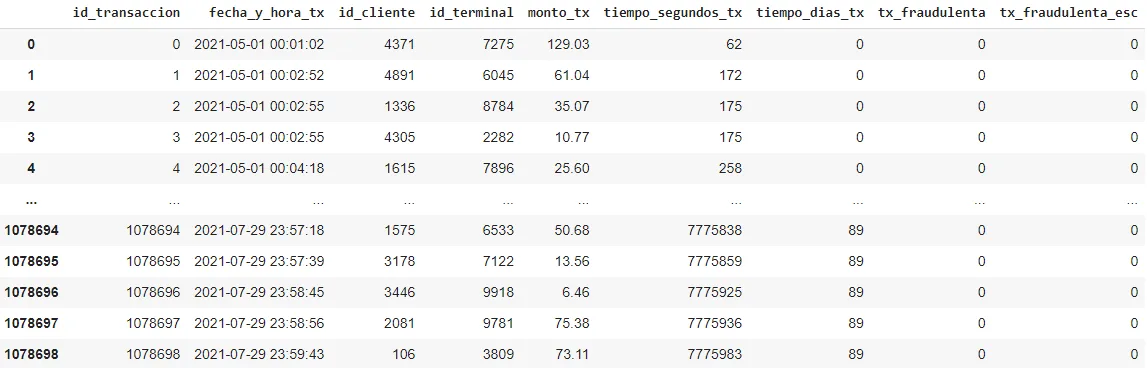
El simulador generó 1.078.699 transacciones, de las cuales 8.590 (aproximadamente el 0,796%) se etiquetaron como fraudulentas. Esto equivale a unas 12.000 transacciones diarias durante el periodo simulado.
El dataset presenta un desequilibrio, menos del 1% de transacciones son fraudulentas.
Los montos de transacción tienen una media de 53.69, con una desviación estándar de 42.13 y un monto máximo de 1 248.85.
La primera transacción se realizó el 01–05–2021 a las 00:01:02 horas y la última transacción se registró el 29–07–2021 a las 23:59:43 horas.
Preparación de datos
Los algoritmos utilizados necesitan una representación numérica de las variables. Esto no significa que todos los campos tengan un orden significativo: los identificadores, por ejemplo, son etiquetas.
El importe es una variable numérica, mientras que la etiqueta de fraude es el objetivo que queremos predecir. La fecha y hora y los identificadores de clientes y terminales permiten construir nuevas variables explicativas; no incluimos la etiqueta objetivo como entrada del modelo.
La primera transformación consiste en generar dos nuevas características binarias, a partir de la fecha y hora, que caractericen períodos potencialmente relevantes.
1. Si una transacción ocurre durante un día laborable (0) o fin de semana (1).
2. Si la transacción ocurre de día o de noche; definimos la noche como el intervalo de 00:00 a 06:00.
Para cada cliente calculamos el número de transacciones y su importe medio en ventanas de 1, 7 y 30 días. Así obtenemos seis variables adicionales.
Finalmente, la última transformación se realiza con el ID de terminal. El objetivo es extraer el número de transacciones en el terminal en cada frecuencia y una puntuación de riesgo, que evalúe la exposición de un terminal a transacciones fraudulentas. (El puntaje de riesgo se define como el número promedio de transacciones fraudulentas en un terminal durante un período de tiempo).
Entrenamiento del modelo
Una vez que se tiene el dataset listo, se particiona el dataset en datos de entrenamiento (60 %) para el desarrollo y datos de prueba (40 %) para validación del modelo.
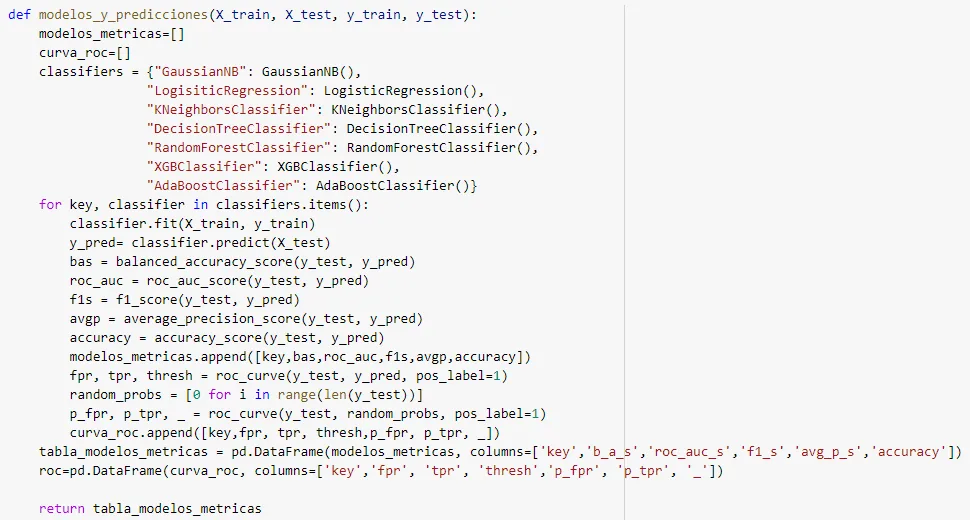
Al tratarse de clasificación binaria, probamos Naive Bayes, regresión logística, KNN, árboles de decisión, Random Forest, XGBoost y AdaBoost.
Evaluación y validación del modelo
Después de entrenar los algoritmos, se evalúan los resultados con distintas métricas y se obtiene la siguiente información:
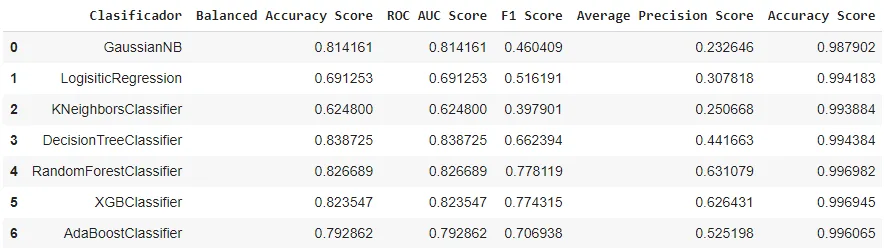
En nuestras pruebas utilizamos ROC AUC para comparar la capacidad de discriminación de los modelos. El árbol de decisión obtuvo aproximadamente 0,83. Esta métrica no equivale a un 83% de exactitud ni evita por sí sola el sobreajuste.
La curva ROC representa la tasa de verdaderos positivos frente a la de falsos positivos a distintos umbrales. El área bajo esa curva, AUC, resume la capacidad de discriminación. El gráfico siguiente compara los algoritmos:
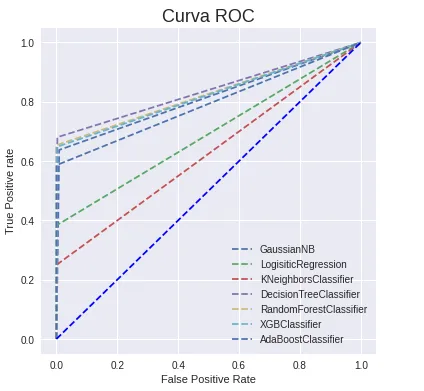
El árbol de decisión obtuvo un ROC AUC de 0,836. Dado el fuerte desequilibrio de clases, conviene complementar esta cifra con precisión, sensibilidad y el coste de los errores.
Los resultados del modelo se pueden expresar mediante una matriz de confusión:
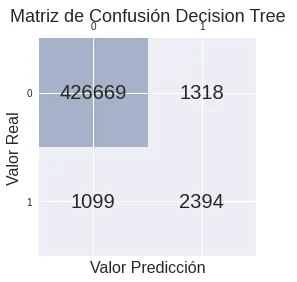
Se puede observar que el modelo ha identificado:
- 426 669 casos de verdaderos negativos, para transacciones NO fraudulentas y que el modelo predijo como NO fraudulentas.
- 2 394 casos de verdaderos positivos, para transacciones fraudulentas y que el modelo predijo como fraudulentas.
- 1 099 casos de falsos negativos, para transacciones fraudulentas y que el modelo predijo como NO fraudulentas.
- 1 318 casos de falsos positivos, para transacciones NO fraudulentas y que el modelo predijo como fraudulentas.
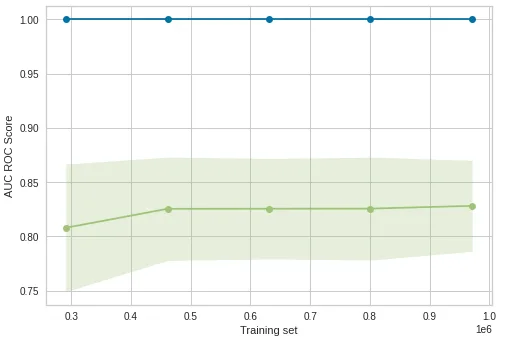
Una curva de aprendizaje muestra la relación entre el puntaje de entrenamiento y el puntaje de prueba con validación cruzada para un estimador con un número variable de muestras de entrenamiento.
La curva presenta una puntuación de entrenamiento cercana a 1,00 y un ROC AUC de evaluación próximo a 0,83. La diferencia entre ambos invita a examinar el sobreajuste.
Conclusiones
- Entre los modelos y pruebas de este proyecto, el árbol de decisión obtuvo el mejor ROC AUC, cercano a 0,83.
- Por la cantidad de datos de las transacciones, en la fase de entrenamiento es fundamental contar con poder computacional para experimentar con diferentes algoritmos y evaluar sus resultados en un tiempo razonable.
- El método es un prototipo evaluado con datos simulados. Aplicarlo en una entidad financiera requeriría validación con datos reales representativos, más escenarios de fraude y evaluación de falsos positivos, falsos negativos y cambios en los patrones de uso.
Referencias
Barrios, J. (2019). La matriz de confusión y sus métricas. Recuperado de: https://bit.ly/3C3ibLE
Condusef (s.f). Tipos de fraude. Recuperado de: https://bit.ly/3kbcmpz
Cornell Law School (s.f). Fraude con Tarjeta de Crédito. Recuperado de: https://bit.ly/3lgOCQ2
Gebejes, A. y Khokhlova, A. (2021). Teoría de la curva de aprendizaje. Data of Learning. VALAMIS. Recuperado de: https://bit.ly/3lhipbp
Le Borgne, Y. & Bontempi, G. (2021). Aprendizaje automático para la detección de fraudes con tarjetas de crédito: manual práctico. Université Libre de Bruxelles. Recuperado de: https://bit.ly/3k7tbBH
McKinney, T. (s.f). Fraud Detection in Python. Recuperado de: https://bit.ly/3lb40xi
Autoría
Martin Mercado
Más Inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 19 nov 2021.
← Más historias de la comunidad