Focus On Driving: Redes Neuronales aplicadas a la Seguridad Vial
Focus on Driving compara cinco modelos de visión artificial para reconocer distracciones al volante y comparte los resultados y límites del experimento.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
Donostia. Segunda Edición. 2021
Introducción
Según los datos de la Dirección General de Tráfico (DGT) citados en el proyecto de 2021, la distracción en la conducción figuraba como factor concurrente en 1 de cada 3 accidentes mortales (33%), por delante de la velocidad (29%) y del alcohol (26%).
Tras un minuto y medio de hablar por el móvil (incluso con manos libres), el conductor no percibe el 40% de las señales, su velocidad media baja un 12%, el ritmo cardíaco se acelera bruscamente durante la llamada y se tarda más en reaccionar.
La peligrosidad por un uso inadecuado del móvil puede llegar a ser equiparable a la conducción con exceso de alcohol.
Más de 1 de cada 3 españoles reconoce haber hablado por teléfono, leído o escrito mensajes durante la conducción en los últimos años.
Un conductor que habla mientras conduce:
Pierde la capacidad de mantener una velocidad constante.
No guarda la distancia de seguridad suficiente con el vehículo que circula delante.
El tiempo de reacción aumenta considerablemente: entre medio a dos segundos, dependiendo de los reflejos de cada conductor.
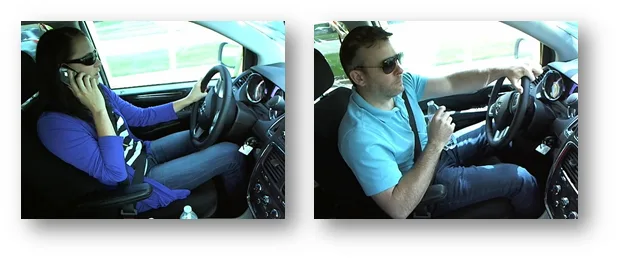
Figura 1. Imágenes de distracciones comunes al conducir.
Esto hace que la detección de estas distracciones sea esencial para mejorar la seguridad vial. Nuestro objetivo era explorar cómo avisar al conductor; la eficacia del prototipo para evitar accidentes no se evaluó. Una herramienta validada podría contribuir a reducir el riesgo.
En este proyecto nos centramos en identificar algunas distracciones habituales, como usar el móvil, mirarse al espejo o beber mientras se conduce.
Objetivo
El objetivo de este proyecto es ajustar un modelo de Machine Learning capaz de identificar y clasificar las diferentes distracciones durante la conducción.
Para ello, trabajaremos con una técnica de Deep Learning conocida como “Redes Neuronales Convolucionales” (CNN o “Convolutional Neural Network”).
Probaremos algunas arquitecturas de redes neuronales, todas ellas mejoradas con redes pre-entrenadas para la clasificación de imágenes (transfer learning).
Conjunto de Imágenes
El conjunto de imágenes que hemos utilizado en el marco de este proyecto proviene de un concurso lanzado en la plataforma Kaggle en 2016 (pulsa aquí para verlo).
Todas las imágenes han sido obtenidas por medio de una cámara instalada dentro del coche, siempre con un conductor dentro y en diversas situaciones cotidianas.
Las fotos han sido tomadas en un ambiente controlado: un camión arrastraba el coche por las calles, de tal manera que los conductores no tuviesen que conducir de verdad.
Para el entrenamiento de los modelos, hemos contado con un total de 22.424 imágenes, clasificadas en 10 categorías:
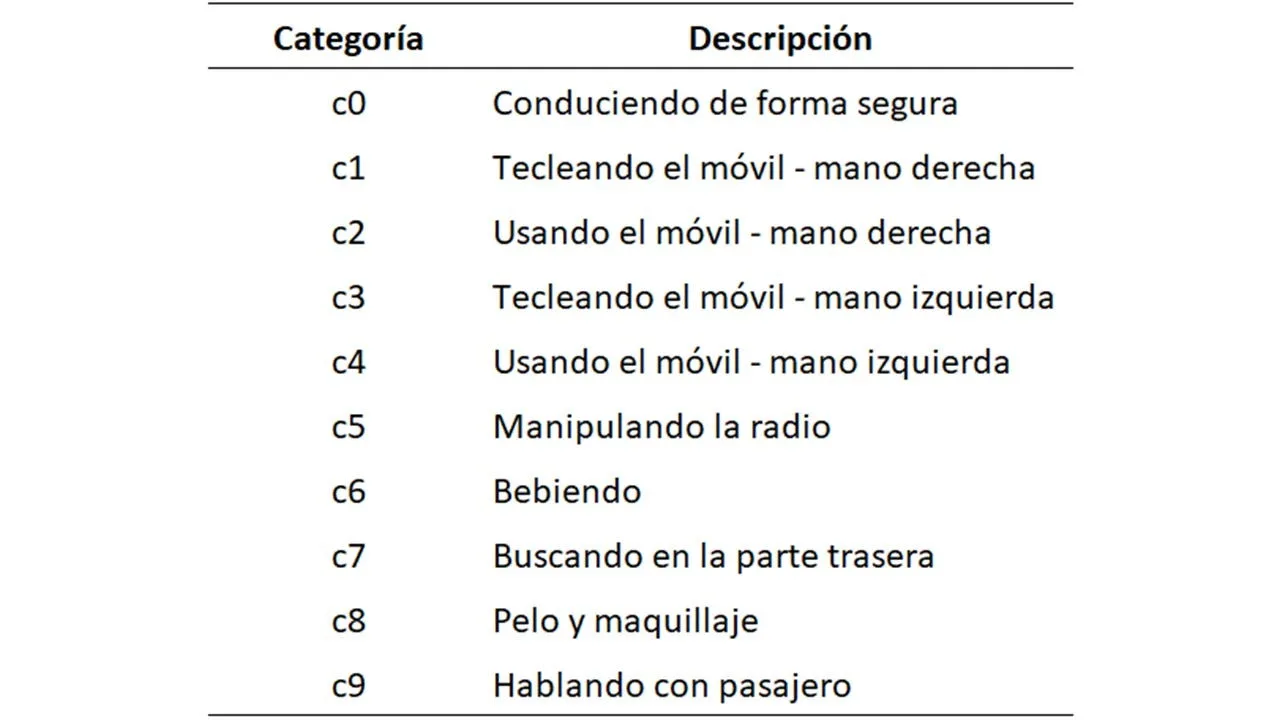
Figura 2. Descripción de las 10 categorías del experimento.
Exploratory Data Analysis
Durante el Exploratory Data Analysis, comprobamos que todas las imágenes tenían las mismas dimensiones: (480, 640, 3).
En la muestra aleatoria que revisamos, las imágenes parecían bien clasificadas en las diez categorías del experimento. Esta comprobación puntual no garantiza la ausencia de errores en todo el conjunto de Kaggle.
Además, las imágenes estaban razonablemente equilibradas entre las diez categorías, lo que simplificó la exploración inicial y nos permitió avanzar al entrenamiento de las CNN.
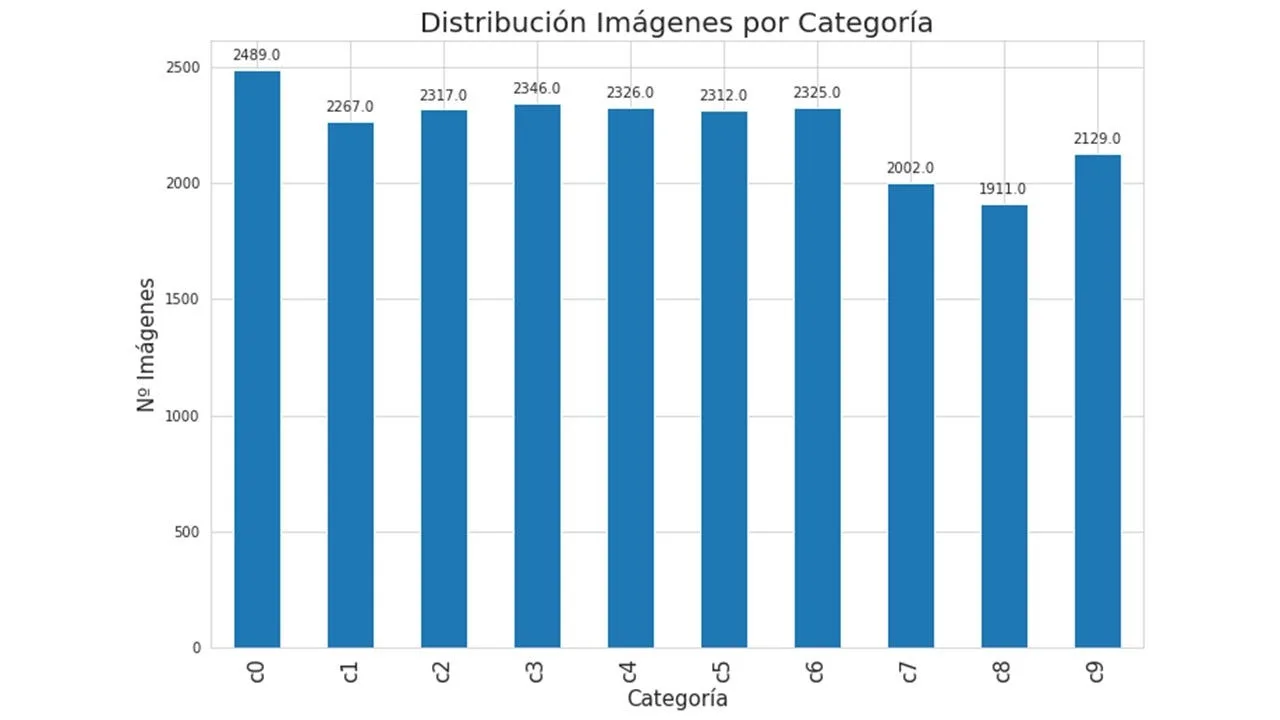
Figura 3. Distribución del número de imágenes entre las 10 categorías del experimento.
En la plataforma también había Kaggle 79.725 imágenes para pruebas, sin etiquetas públicas.
Es importante mencionar que las imágenes de entrenamiento y testeo estaban divididas en Kaggle de tal manera que un mismo conductor no podría aparecer en los 2 grupos (entrenamiento y testeo).
En general, las 10 categorías podrían ser consideradas “excluyentes”, a excepción de las categorías “c0” (conduciendo de forma segura) y “c9” (hablando con pasajero), que se parecen más entre ellas y podrían ser consideradas “no excluyentes”, ya que, en algunas situaciones, tienen en común las 2 manos colocadas en el volante.
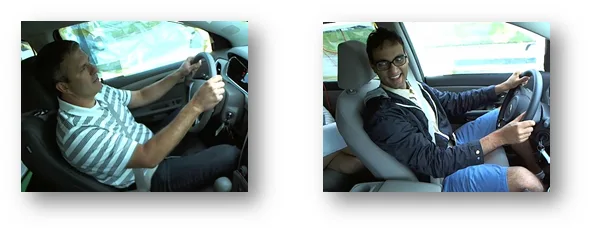
Figura 4. Imágenes de 2 conductores, la primera de la categoría “c0”, y la segunda, de la categoría “c9”.
Implementación
En líneas generales, hemos seguido los siguientes pasos para el ajuste de las Redes Neuronales Convolucionales presentadas en este proyecto:
- Bajar y pre-procesar las imágenes de los conductores.
- Construir y entrenar un modelo para clasificar las imágenes de los conductores.
- Chequear el ajuste del modelo y mejorarlo usando diferentes técnicas.
Transfer Learning
Normalmente, no hace falta entrenar una Red Neuronal Convolucional empezando de cero.
Entrenar redes convolucionales con grandes conjuntos de datos, como ImageNet, puede requerir mucho tiempo y varias GPU. El coste depende del modelo y del hardware.
En cambio, una práctica cada vez más habitual es el uso de redes pre-entrenadas como un extractor de características fijas, o como una red inicial para ajustes más finos.
La red pre-entrenada VGG nos interesaba por su sencillez y por los resultados de trabajos anteriores. Utilizamos su base convolucional como punto de partida para añadir nuestro propio clasificador.
Así, VGG actúa como extractor de características y entrenamos un clasificador propio en la parte final de la red (top model).
En este proyecto, utilizaremos la red pre-entrenada “VGG16”, como punto de partida. Para el ajuste más fino, utilizaremos 3 capas finales, propuestas en este enlace (“Aprendizaje práctico por transferencia con Keras y el modelo VGG16”).
A partir del resultado de este primer ajuste, construiremos nuevos modelos, con más capas. También utilizaremos el recurso de Aumento de datos, e incluso nos atreveremos a cambiar la “VGG16” por la “VGG19”, red neuronal pre-entrenada más compleja, ya que cuenta con 3 capas más que la “VGG16”.
Amazon Web Services
Los ajustes de este primer modelo y de todos los demás presentados en este artículo han sido realizados en SageMaker de Amazon Web Services. Para ello, hemos contado con el crédito de 1.000$ que Amazon nos concedió por formar parte de la familia Saturdays.AI.
Hemos elegido el centro computacional ubicado en ‘EE.UU. Este (Ohio)us-east-2’, ya que este centro disponía de máquinas con GPU. La máquina elegida para abrir la instancia de nuestro notebook en SageMaker ha sido: ‘ml.p3.2xlarge’.
Parámetros y Evaluación de los Modelos
Un resumen de los parámetros de los modelos ajustados será presentado a continuación en modo de tabla.
De todas formas, no está de más comentar que, en todos los modelos, hemos fijado Batch = 32 y Epochs = 25, para que hubiese una base de comparabilidad entre los ajustes de los modelos.
Para hacer la evaluación de los modelos ajustados, además de las gráficas de accuracy y de loss generadas por el algoritmo, hemos clasificado 1.002 imágenes, que a partir de ahora llamaremos ‘Test Data’.
Esta imágenes han sido elegidas aleatoriamente de las 79.725 imágenes no clasificadas para testeo, con el objetivo de tener una medida de accuracy en un conjunto de imágenes totalmente ajeno a los datos utilizados para los entrenamientos (‘Test Data’ Accuracy).
También hemos preparado un código en Google Colab (“model_test.ipynb”), para poder visualizar el resultado del modelo en cada imagen, como se puede ver en el GIF de abajo.
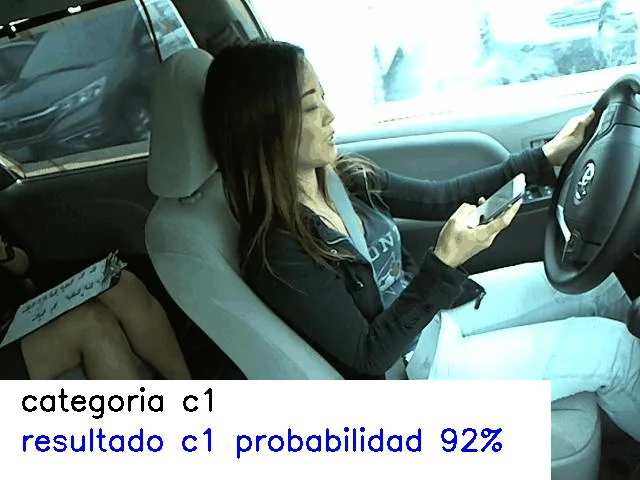
Figura 5. Output de “model_test.ipynb”.
Modelo 1: VGG16 + 3 Capas
Como comentado anteriormente, para el primer modelo (“base”) hemos utilizado la red pre-entrenada “VGG16”, y para el ajuste más fino, hemos utilizado 3 capas finales.
El resultado del ajuste de este modelo podría ser considerado satisfactorio, teniendo en cuenta que este ha sido el primer intento de modelización del proyecto:
- ‘Test Data’ Accuracy: 80,44%
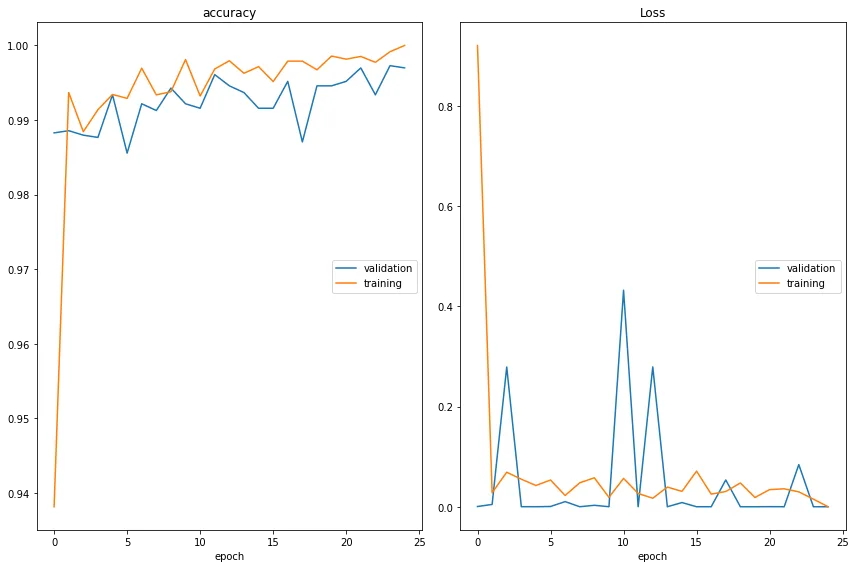
Figura 6. Gráficas de exactitud (accuracy) y pérdida del Modelo 1.
Modelo 2: VGG16 + 3 Capas + Aumento de datos
Para mejorar el modelo anterior, nos hemos planteado utilizar el recurso de “Aumento de datos”.
En principio, no sabíamos a que se referían algunos de los diversos parámetros disponibles para hacer el Aumento de datos, ni qué significaban sus rangos.
Para solventarlo, hicimos una serie de pruebas, para poder decidir qué parámetros de Aumento de datos queríamos emplear en nuestro conjunto de imágenes y sus respectivos rangos.
Al tratarse de un experimento controlado, el conjunto de imágenes utilizado requería un Aumento de datos moderado y controlado, teniendo en cuenta que cambios exagerados aplicados a las imágenes originales podrían ser contraproducentes.
Por ejemplo, hemos decidido no hacer “rotaciones”, ya que corríamos el riesgo de generar imágenes “antinaturales”.
Los parámetros de Aumento de datos que hemos utilizado han sido: “zoom”, “width”, “height” y “brightness”. A continuación, algunos ejemplos.
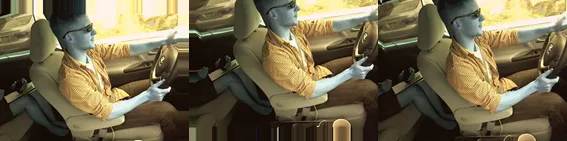
Figura 7. Zoom_range = [0.95, 1.05]
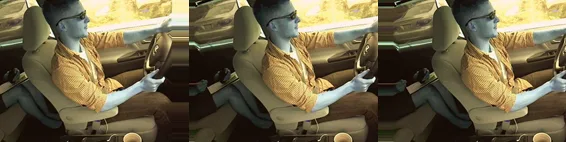
Figura 8. Width_shift_range = 0.1
Nota: las imágenes tienen ese tono debido al preprocesamiento de RGB.
El resultado del ajuste de este modelo ha mejorado considerablemente con relación al anterior (Modelo 1), por lo que hemos decidido continuar utilizando Aumento de datos en los siguientes modelos ajustados en el marco de este proyecto.
- ‘Test Data’ Accuracy: 83,73%
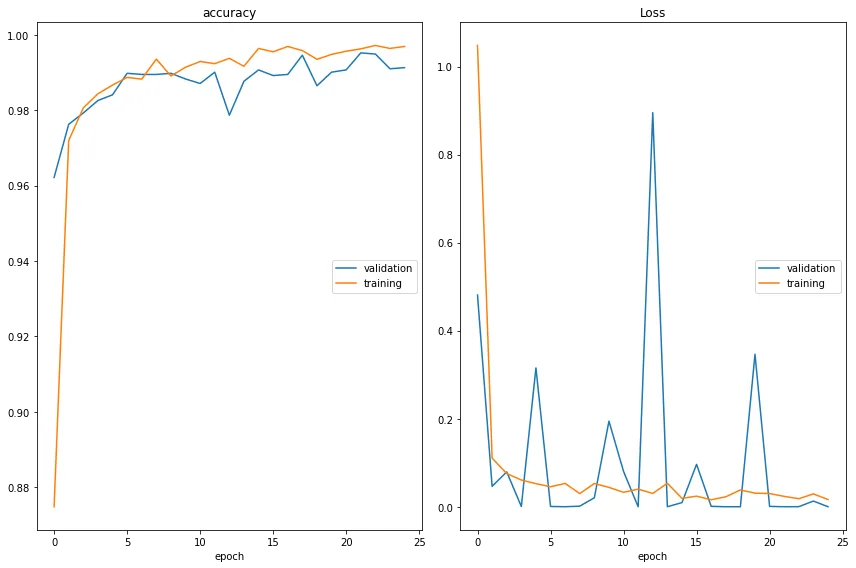
Figura 9. Gráficas de exactitud (accuracy) y pérdida del Modelo 2.
Modelo 3: VGG16 + 5 Capas + Aumento de datos
Para mejorar el modelo anterior, añadimos 2 capas a la red neuronal final (top model), manteniendo los mismos parámetros de Aumento de datos del modelo anterior.
Se observa una mejora importante en el accuracy del modelo en ‘Test Data’:
- ‘Test Data’ Accuracy: 88,12%
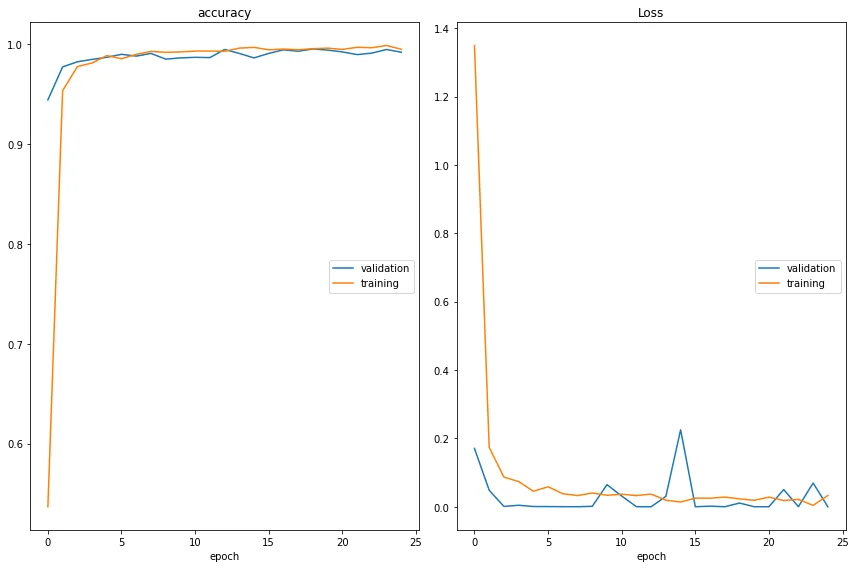
Figura 10. Gráficas de exactitud (accuracy) y pérdida del Modelo 3.
Modelo 4: VGG19 + 5 Capas + Aumento de datos
Tras mejorar los resultados, decidimos probar un cambio de red preentrenada, para seguir explorando nuevos caminos hacia la mejora.
Hemos utilizado la red “VGG19”, que contiene 3 capas más que la red “VGG16”.
En este caso, los resultados de accuracy no han mejorado respecto al Modelo 3:
- ‘Test Data’ Accuracy: 84,53%
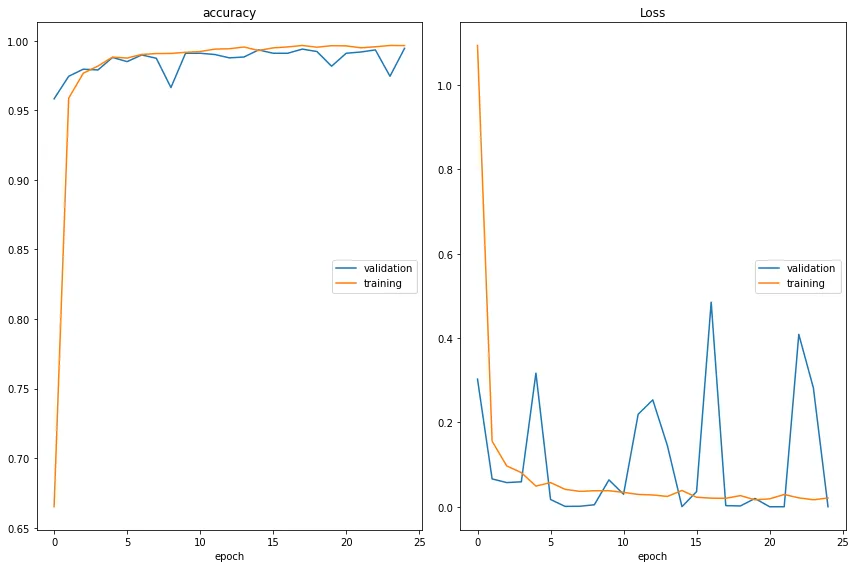
Figura 11. Gráficas de exactitud (accuracy) y pérdida del Modelo 4.
Por lo que hemos decidido volver a utilizar la red “VGG16” para el ajuste del siguiente modelo.
Modelo 5: VGG16 + 9 Capas + Aumento de datos
Para seguir explorando otras posibles mejoras en lo que concierne al accuracy del modelo, hemos decidido aumentar considerablemente el número de capas, de 5 a 9, manteniendo el Aumento de datos anterior.
En este caso, tampoco hemos mejorado el accuracy respecto al Modelo 3, aunque el resultado haya sido bastante aceptable:
- ‘Test Data’ Accuracy: 86,63%
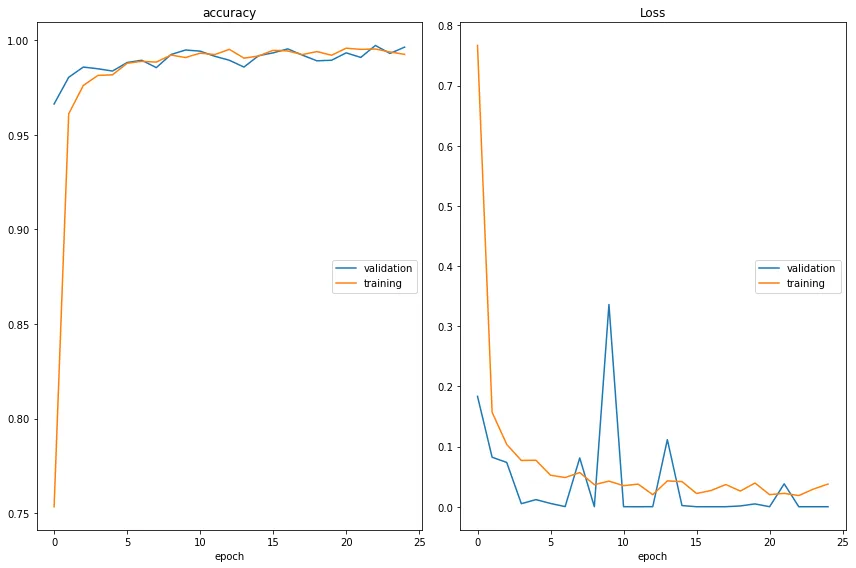
Figura 12. Gráficas de exactitud (accuracy) y pérdida del Modelo 5.
Tabla Resumen
La tabla a continuación detalla los 5 modelos ajustados y la línea de razonamiento seguida para ir ajustándolos, paso a paso.
En azul, los cambios implementados a partir del primer modelo (“base”), y los mejores resultados de accuracy (> 85%).
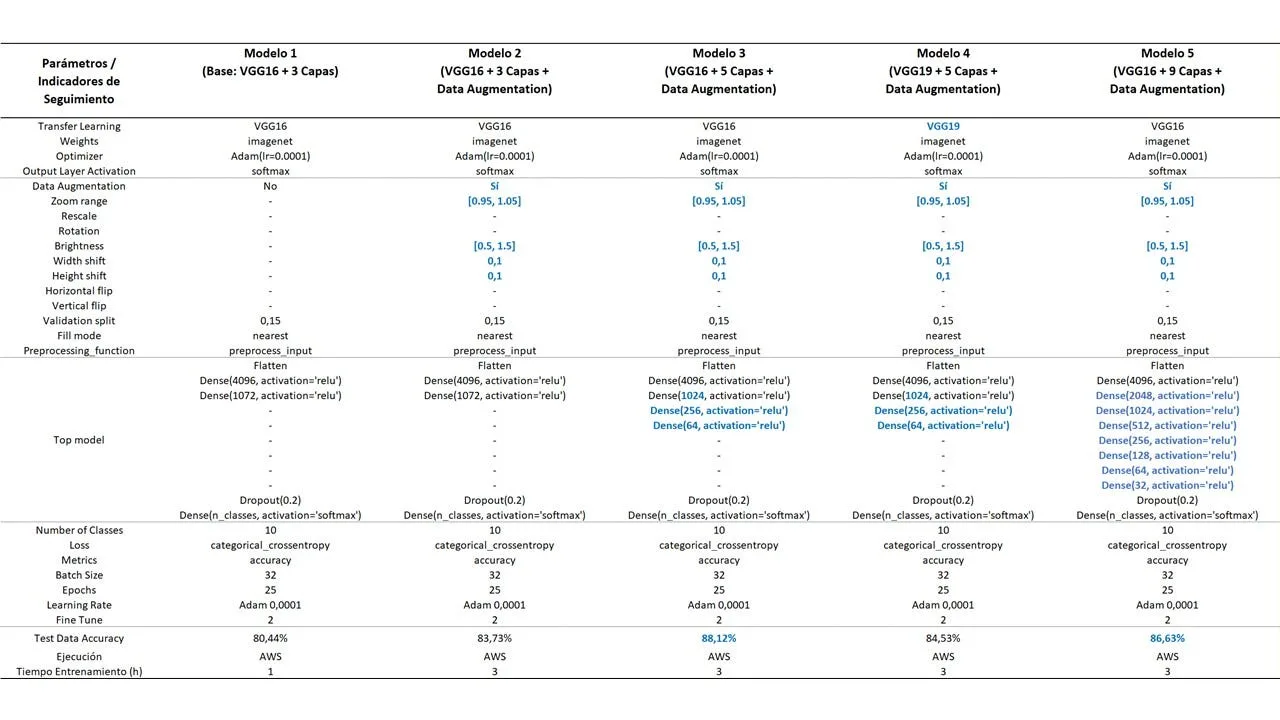
Figura 13. Parámetros y resultados de los 5 modelos ajustados.
Matriz de Confusión: Modelo 3
Los porcentajes de acierto por categoría del Modelo 3 son en general bastante satisfactorios.
Esto se refleja en la Matriz de Confusión del modelo.
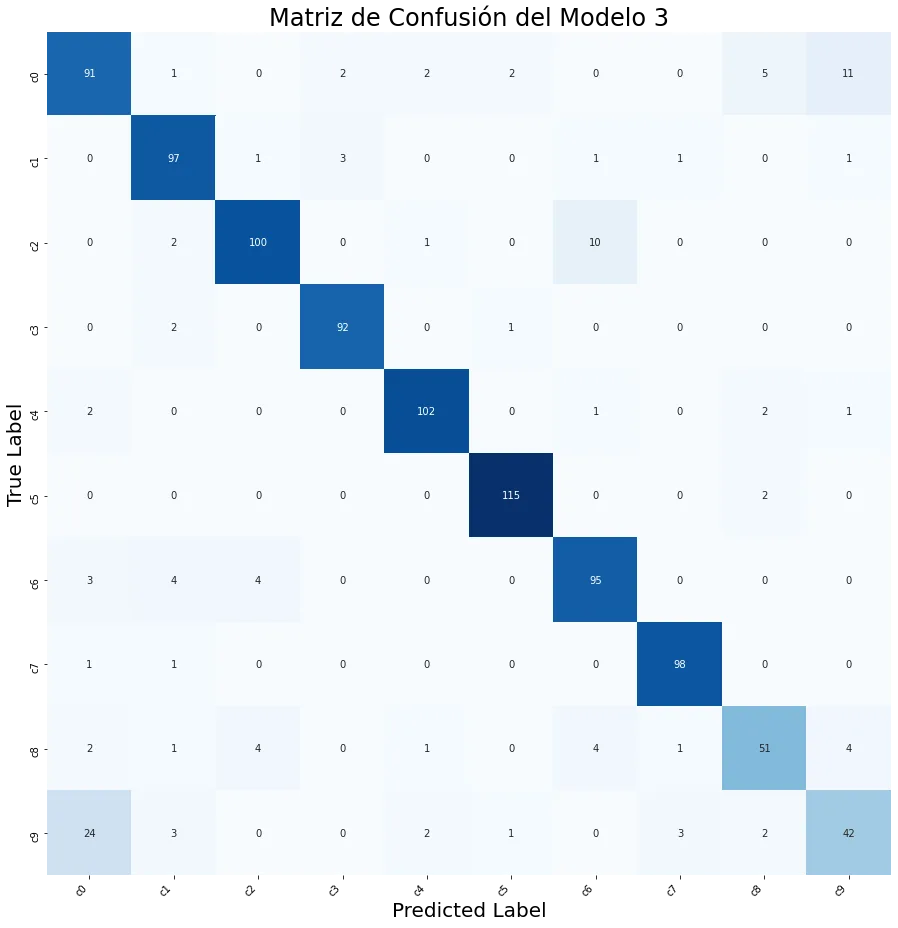
Figura 14. Matriz de Confusión del Modelo 3.
Se destacan las siguientes categorías por su alto porcentaje de acierto (>95%): “c3” (tecleando el móvil -mano izquierda), “c5” (manipulando la radio) y “c7” (buscando en la parte trasera).
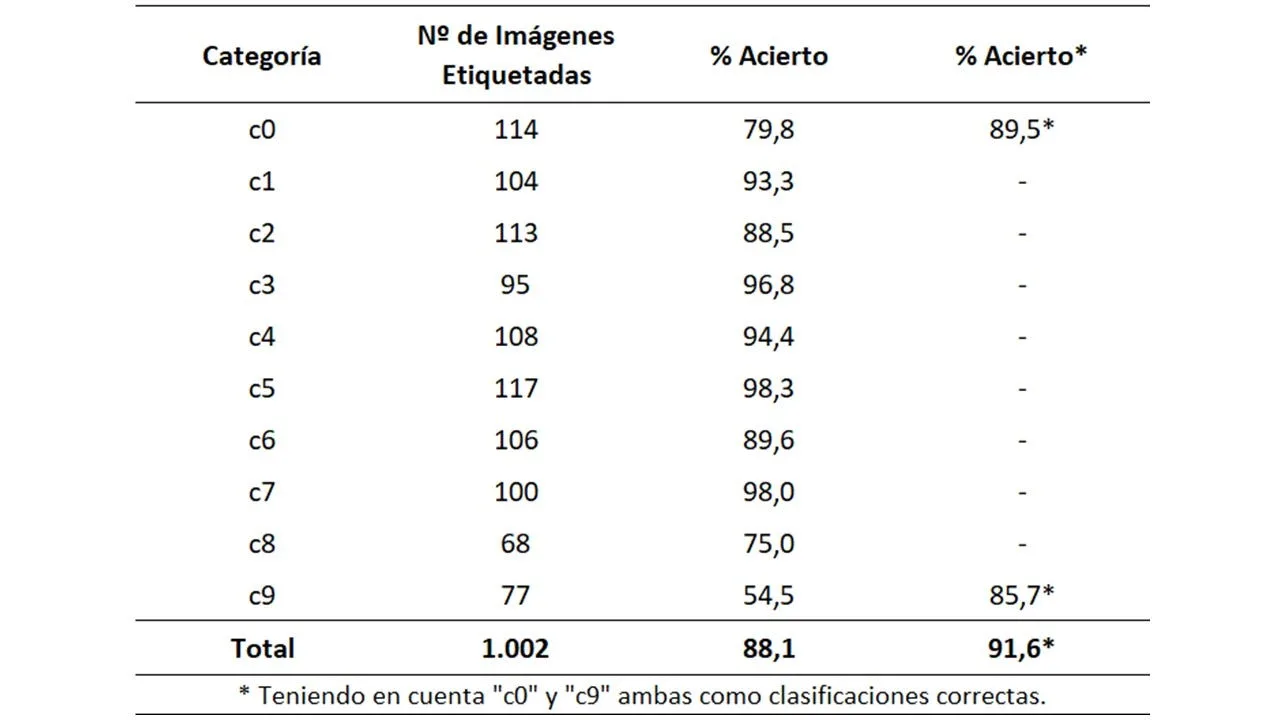
Figura 15. Porcentajes de acierto por categoría.
El porcentaje de acierto cae especialmente en la categoría “c9” (hablando con pasajero). Esto pasa debido a que las categorías “c0” y “c9” podrían ser consideradas las “menos excluyentes”, según comentado anteriormente.
Si aceptáramos tanto c0 como c9 para las imágenes etiquetadas c9, su porcentaje de acierto pasaría del 54,5 % al 85,7 %: 31,2 puntos porcentuales más. Es un cálculo exploratorio que cambia el criterio de evaluación, no una mejora del modelo ni una medida comparable con la exactitud original.
Hemos realizado este cálculo para intentar cuantificar el impacto en accuracy por el hecho de haber trabajado con un par de categorías “algo menos excluyentes”.
Definir con más claridad la diferencia entre c0 y c9 podría ayudar a etiquetar y evaluar los datos. Aun así, una mejora del rendimiento tendría que comprobarse con un conjunto independiente. Al comparar repetidamente modelos sobre las mismas 1.002 imágenes, ese conjunto pasa a orientar la selección y deja de ser una prueba final independiente.
Por otro lado, entendemos que el estudio tiene que reflejar situaciones cotidianas, ya que serán la realidad a ser afrontada en el momento de desplegar cualquier modelo en la vida real.
Conclusiones
La gran capacidad computacional que requieren estos modelos nos llevó a dedicar una parte importante del proyecto a resolver problemas de ejecución del código.
Hemos tenido que aprender a utilizar los servicios de Amazon Web Services para hacerlo viable, y los modelos de este proyecto han podido ser entrenados gracias a las GPU disponibles de esta plataforma.
A continuación, se presentan algunas conclusiones y lecciones aprendidas tras desarrollar este proyecto:
- Añadir más capas a una red neuronal no siempre permite mejorar la accuracy del ajuste del modelo. Este hecho se ha podido ver en los ajustes de los Modelos 3 y 5.
- El recurso de Aumento de datos debe ser utilizado con criterio, tras un análisis del conjunto de imágenes inicial, ya que su uso indiscriminado puede ser contraproducente.
- El trabajo en equipo ha sido fundamental. La diversidad de perfiles del equipo y de la coordinación de Saturdays.AI Donostia nos aportó una visión amplia y enriquecedora.
El camino no ha sido fácil y ha requerido muchas horas de entrenamientos. Pero créenos: ¡ha merecido la pena!
Próximos Pasos
Como próximos pasos, nos planteamos lo siguiente:
Ajustar un segundo modelo más específico que aprenda a detectar las diferencias entre las categorías “c0” y “c9”.
Volver a entrenar el Modelo 4 (VGG19 + 5 capas + Aumento de datos), pero ahora con más “epochs”. La idea es observar si con más entrenamientos la red “VGG19” converge a los mismos resultados observados con la red “VGG16”.
Ejecutar el Modelo 3 en una Jetson Nano Nvidia, y evaluar el modelo con una cámara en un entorno controlado, antes de plantear cualquier uso en conducción real.
Equipo de Trabajo
Y para despedirnos, nos gustaría presentarnos.
Hola. Me llamo Imanol Areizaga y soy Ingeniero Industrial. Desde mis primeras experiencias laborales estoy trabajando en procesos de digitalización en el ámbito industrial. En el camino de Data Science vas descubriendo paso a paso nuevos horizontes y en este paso que estoy dando junto a Saturdays.AI estoy interesado en cómo aplicar Deep Learning en la industria, un ámbito exigente en el que la fiabilidad y los requisitos dependen de cada aplicación.
Hola a tod@s. Me llamo Henry Corazza Sef y soy estadístico. Aunque me haya decantado por trabajar en la implementación de la Metodología 6 Sigma en el área industrial, sigo muy interesado en Data Science en general. Tras este curso, he descubierto otra pasión: ¡el enigmático universo de las redes neuronales!
Agradecemos a los mentores y organizadores de Saturdays.AI Donostia, especialmente a Beñat Galdós, Joxemari Gallastegi e Imanol Echeverria, por su profesionalidad, dedicación y entusiasmo.
Repositorio
En el siguiente repositorio se encuentra el código usado para desarrollar esta aplicación: https://github.com/SaturdaysAI/Projects/tree/master/Donostia/Donostia2021/focusondriving-main
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 16 mar 2022.
← Más historias de la comunidad