Clasificación de expresiones faciales en tiempo real
Un prototipo de deep learning y visión por computador para clasificar expresiones faciales, con sus resultados y limitaciones.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
Nota editorial: este proyecto clasifica expresiones faciales según las etiquetas de sus datos. Esa tarea no permite establecer por sí sola las emociones, la atención o el bienestar de una persona. Los resultados descritos deben leerse como los de un prototipo educativo.
Evidencia sobre expresiones faciales y emociones
Quito. 2021
Ing. Benjamin Villegas Mendez, Ing. Mauricio Oroza Herbas
INTRODUCCIÓN
La pandemia de COVID-19 aceleró el paso a las clases virtuales y planteó dificultades para mantener la participación del alumnado. Este proyecto exploró un sistema de clasificación de expresiones faciales como posible fuente de información para el docente. El prototipo utilizó una red convolucional residual ResNet, imágenes de tres fuentes y técnicas de aumento de datos. Su resultado son etiquetas de expresiones faciales captadas por una webcam: no permite medir por sí solo la atención, el interés ni las emociones del estudiante. Cualquier posible uso educativo requeriría una evaluación adicional y considerar la privacidad y el consentimiento.
DESCRIPCIÓN DEL PROBLEMA
En las clases virtuales puede resultar difícil mantener la participación y obtener información sobre cómo está siguiendo la sesión el alumnado. El equipo quiso explorar este problema, sin que el prototipo permita cuantificar cuántos estudiantes prestan atención.
OBJETIVOS
El objetivo general fue crear un modelo de deep learning que clasificara expresiones faciales en tiempo real a partir de una webcam.
En los objetivos particulares, se cita seleccionar un dataset que pueda ser adecuado para el fin perseguido, implementar un sistema de reconocimiento facial solamente, y seleccionar un modelo de clasificación adecuado para poder crear el modelo general de reconocimiento de emociones.
SELECCIÓN DEL DATASET
Se hizo una búsqueda de datasets relacionados a emociones y se encontró una lista de los datasets más utilizados como se muestra en la figura a continuación:
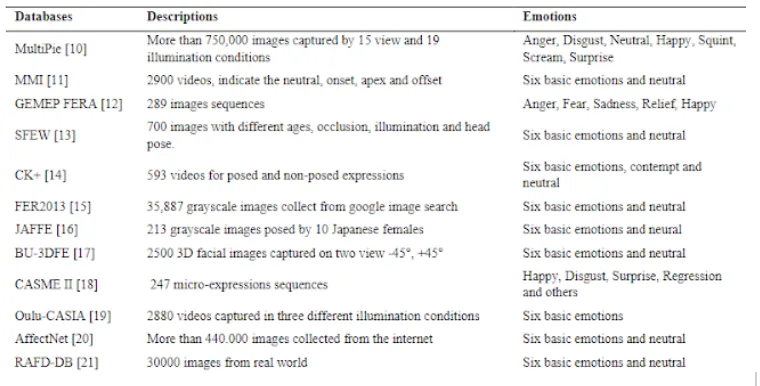
El principal criterio para la selección fue buscar datasets que estén disponibles de forma gratuita que estén dentro de la lista presentada anteriormente, los cuales son FER2013 y CK+. Para el presente proyecto se utilizó una mezcla de ambos datasets incluyendo un dataset propio creado. Los 2 primeros datasets son bastante utilizados para reconocimiento facial actualmente y tienen bastante cantidad de datos relevantes para el proyecto en curso. Por tema de costo, se buscó fragmentos de dichos datasets que estén disponibles de forma gratuita y se los integró en uno solo. Se revisaron los dataset manualmente para eliminar posibles imágenes que no correspondan con la emoción, se agregaron datos y se utilizó data augmentation.
SELECCIÓN DE LOS MODELOS
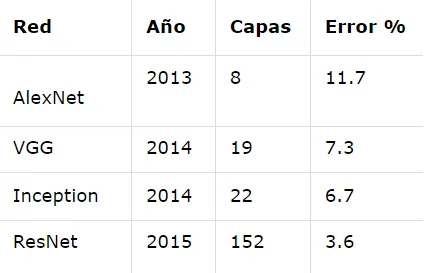
Dado que se trata de un problema de clasificación de imágenes con 7 posibles salidas (correspondientes a 6 emociones faciales detectables básicas y una neutral) se estudiaron varias posibles arquitecturas de computer vision y clasificación de imágenes entre las que se pueden mencionar: AlexNet, VGG, inception y ResNet. Siendo esta última la escogida para el modelo propuesto dada su versatilidad en el entrenamiento de redes profundas sin presentar el problema de desvanecimiento de gradiente (vanishing gradient).
En la siguiente tabla se puede observar su porcentaje de error frente al dataset de clasificación de imágenes de la competencia ImageNet de 2015.
El principio de funcionamiento de las redes residuales (ResNet) puede entenderse analizando lo que sus autores denominan bloque residual convolucional.
Si suponemos que la salida del bloque F(x) tiene la misma dimensión que su entrada x, se conoce a este bloque como bloque residual identidad que puede resumirse bajo la siguiente fórmula:
x = x + F(x)
Donde por simplicidad la salida del bloque también se llamará x.
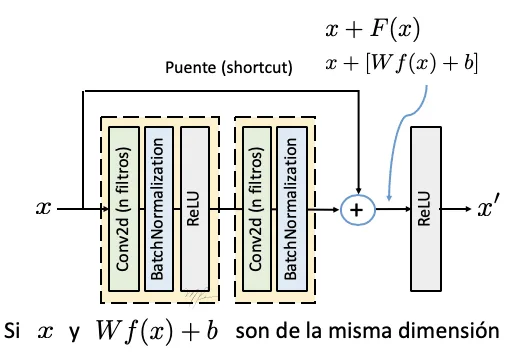
En el bloque de identidad no es necesario modificar la conexión de salto: F(x) y la entrada x tienen las mismas dimensiones y pueden sumarse directamente. Esto no significa que la salida sea idéntica a la entrada.
En el caso que las dimensiones de salida y el tensor de entrada sean diferentes porque se incrementen el número de canales o se modifiquen las dimensiones del tensor será necesario aplicar operaciones a x para hacer congruentes las dimensiones.
Por ello, para poder hacer la suma de la liga residual con los datos procesados, se agrega una capa convolucional (sin activación) en la liga puente con paso de dos y con el número de canales requeridos.
X = [Vx + b] + F(x)
A este bloque se le conoce como bloque residual convolucional.
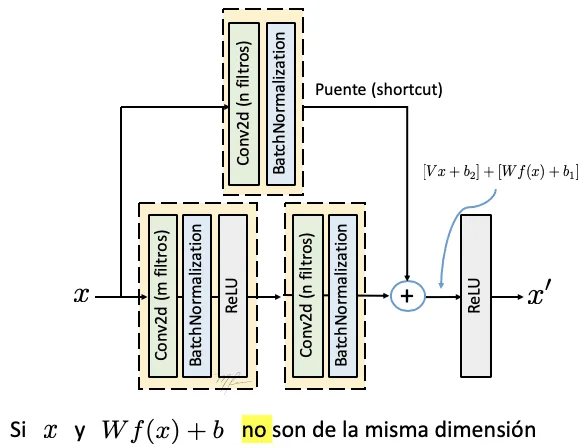
Para el caso del modelo implementado para reconocimiento de emociones se implementó una red ResNet de 9 bloques para que el entrenamiento no sea demasiado extenso ni consuma demasiados recursos del GPU y memoria asignados en el notebook diseñado.
TÉCNICAS IMPLEMENTADAS
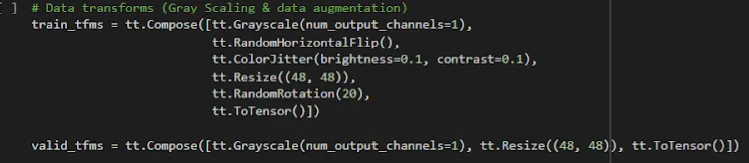
Dada la naturaleza del dataset compuesto utilizado, cuyas imágenes contienen variación de tamaños, imágenes a color y en escala de grises además de para algunas de las emociones detectadas se tienen menos imágenes para la etapa de entrenamiento que otras, se utilizaron las siguientes técnicas de data augmentation:
- Random horizontal flip: Utilizada para aleatoriamente espejar imágenes en sentido horizontal.
- Color Jitter: Para aleatoriamente ajustar el brillo y contraste de las imágenes.
- Resize: Para parametrizar el tamaño de las imágenes antes de la entrada al entrenamiento
- Random rotation: Para aleatoriamente girar imágenes en 20 grados de su posición original.
- Grayscale: para que todas las imágenes de entrada sean en escala de grises.
- To Tensor: Para convertir las imágenes en tensores previamente al entrenamiento
También se utilizaron algunas técnicas para hacer el entrenamiento más óptimo:
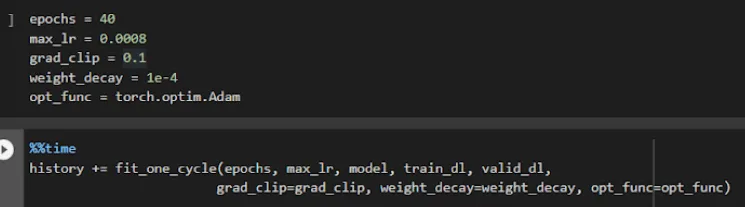
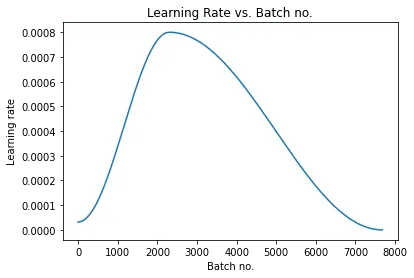
- Learning Rate Scheduling: Para tener un learning rate variable a medida que avanza el entrenamiento en cada epoch, siendo así que alrededor del 30 por ciento de las epochs se tenga el máximo valor del learning rate.
- Weight Decay: Previene que los pesos sean demasiado grandes.
- Gradient Clipping: limita los valores de los gradientes a un rango pequeño para evitar cambios no deseados en los parámetros debido a grandes valores de gradiente.
Cabe mencionar que en la construcción del modelo ResNet se utilizaron también técnicas conocidas de optimización como ser: batch normalization, maxpool y dropout.
En el caso de la detección de rostros para su posterior clasificación, se utilizó el modelo pre entrenado de Open CV “Haar cascade frontal face” cuya llamada a dicho modelo se hace dentro de un script de JavaScript para el manejo de Webcam dentro de Colab en tiempo real.
EVALUACIÓN DE LOS MODELOS
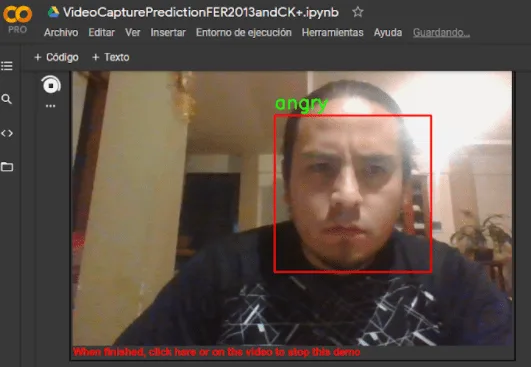
La función de acceso a la webcam combina la detección de rostros con el clasificador de expresiones faciales. Guarda las predicciones generadas durante la ejecución y permite visualizarlas después en gráficas.
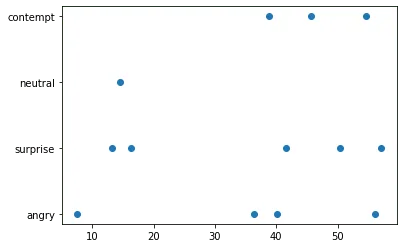
La siguiente captura muestra una predicción con la etiqueta “angry” (enfado). Es una salida del clasificador, no una constatación del estado emocional de la persona.
ANÁLISIS DE LOS RESULTADOS
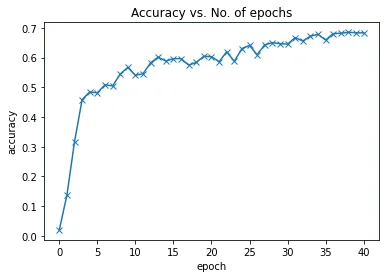
Se utilizaron 40 epochs para el entrenamiento del modelo diseñado logrando una precisión del 70% en un tiempo de entrenamiento de aproximadamente 40 minutos. Cabe mencionar que el accuracy a lo largo de las epoch no fluctúa demasiado, esto después de haber modificado el dataset de forma manual eliminando imágenes consideradas ruido.
Es posible ver el cambio del learning rate durante el entrenamiento en la siguiente imagen.
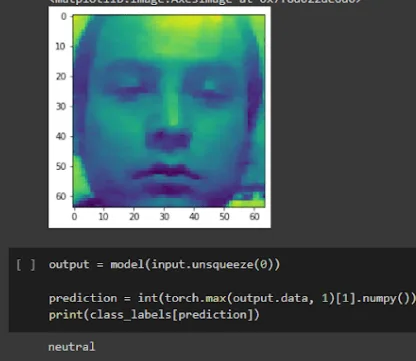
El equipo obtuvo una exactitud del 70 % en su evaluación, con los recursos de GPU y memoria disponibles en Google Colab. Ese resultado se refiere a las etiquetas del conjunto de datos, no a la medición de emociones reales.
CONCLUSIONES
-Un buen dataset es imprescindible para una buena detección, al conseguir fragmentos de datasets de forma gratuita, se evidenció que tenían imágenes erróneas que no correspondían con la emoción a detectar, es por eso que se tuvo que analizar cada imagen del dataset, limpiar y agregar datos para poder tener un resultado certero. Se recomienda acceder a dataset elaborados por universidades o instituciones dedicadas a la investigación.
-Utilizamos un detector de rostros preentrenado y un clasificador propio de expresiones faciales, que alcanzó una exactitud del 70 % en la evaluación descrita.
-La utilización de redes neuronales residuales que beneficiaron en un tiempo de entrenamiento más corto con resultados aceptables.
-Se implementó el sistema de reconocimiento de emociones en tiempo real dentro del entorno de Colab con funciones de JavaScript, de otra forma no sería posible el manejo de una webcam dentro de Colab.
-Se guardan los datos y se presentan distintas gráficas al final de la detección con el fin de que el docente pueda tener visualización de los datos obtenidos durante toda su clase.
- El equipo planteó posibles líneas de trabajo en marketing, creación de contenidos y desarrollo de productos. Su viabilidad y legitimidad requieren una evaluación independiente; no se puede asumir que las expresiones revelen las emociones de una persona.
El código completo tanto del notebook usado para el entrenamiento como el notebook usado para la ejecución misma del modelo pueden encontrarlos en:
https://github.com/benjorocker94/Face-emotion-recognition-with-cola
BIBLIOGRAFÍA
- Mellouck y Handouzi. (2020). Reconocimiento de emociones faciales mediante aprendizaje profundo: revisión y conocimientos. Procedia Ciencias de la Computación. https://www.sciencedirect.com/science/article/pii/S1877050920318019
- Minae et al. (2019). Deep-Emotion: Facial Expression Recognition Using Attentional Convolutional Network
- Rivera. (2019). La Red Residual (Residual Network, ResNet).http://personal.cimat.mx:8181/~mrivera/cursos/aprendizaje\_profundo/resnet/resnet.html#par%C3%A1metros-del-modelo-vs-la-exactitud-accuracy
- Bok. (2020). Primeros pasos con la albumentación: ejemplo de técnica ganadora de aumento de imágenes de aprendizaje profundo en PyTorch. https://towardsdatascience.com/getting-started-with-albumentation-winning-deep-learning-image-augmentation-technique-in-pytorch-47aaba0ee3f8
- Rohan Singh. (2020). Emotion Detection Using Pytorch. https://medium.com/swlh/emotion-detection-using-pytorch-4f6fbfd14b2e
Repositorio
En el siguiente repositorio se encuentra el código usado para desarrollar esa aplicación: https://github.com/SaturdaysAI/Projects/tree/master/Quito/2021/Face-emotion-recognition-with-colab-main
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 22 nov 2021.
← Más historias de la comunidad