TorchFakes: Detección de DeepFake
TorchFakes: Detección de DeepFake
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
Autores: Aarón Espasandín Geselmann, Concepción Olivares Herráiz, Jorge González Sierra y Jaime Merino Albert
Mentores: Alejandro Iñigo, Teresa García y Nerea Encina
Este es el proyecto final de la Bootcamp de los AI Saturdays.
Puedes probar este modelo usando el siguiente enlace, ¡solo ingresa una imagen y mira los resultados!
Introducción
Un DeepFake puede ser una imagen o un vídeo con sonidos creados artificialmente mediante una combinación de algoritmos de aprendizaje automático.
Se pueden encontrar similitudes entre esta tecnología y el software de edición de imágenes, sin embargo, es un paso más. Puede crear personas que no existen o crear un vídeo haciendo que una persona real diga o haga cosas que en realidad no hizo ni dijo, como en el caso del famoso vídeo de Obama.
Es una herramienta de desinformación, que puede usarse para estafas, manipulación electoral, robo de identidad e incluso para crear videos pornográficos falsos de celebridades.
La motivación detrás del proyecto.
Hoy en día parece cada vez más complicado detectar si el contenido que se difunde por la red es cierto y cada vez más complicado detectar qué es real y qué no.
Es por ello que la principal motivación de nuestro proyecto es desarrollar un modelo de detección de deepfakes que pueda ayudar a personas, instituciones y empresas a detectar imágenes falsas en situaciones en las que puedan ser manipuladas.
Pero no todas las aplicaciones deep fake están enfocadas a la manipulación o el engaño, también existen usos positivos de los deep fakes; aplicaciones en entretenimiento, publicidad, cine, investigación en usos médicos, etc.
Estructura del proyecto
Para el proyecto utilizamos InceptionResnetV1 con imágenes extraídas de vídeos HD de FaceForensics++ a 30 fotogramas por segundo. Buscamos equilibrar las clases de imágenes reales y manipuladas para el entrenamiento. Para extraer los rostros empleamos el modelo preentrenado MTCNN.
Decidimos utilizar el marco de aprendizaje profundo PyTorch debido a la libertad que ofrece en comparación con Keras.
Extraer rostros del conjunto de datos
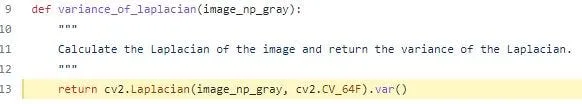
Partimos de 21.000 imágenes falsas y 5.500 reales de FaceForensics++. Para descartar las imágenes borrosas que podían perjudicar el entrenamiento, utilizamos un script que aplicaba el operador de Laplace y calculaba la varianza del resultado. En nuestro filtrado, consideramos borrosas las imágenes con una varianza inferior a 30.
Código para la convolución con LaPlace Kernel
Si quieres saber más sobre por qué usar el kernel de Laplace, puedes echar un vistazo a este artículo. En resumen, al aplicar una convolución, se resaltan los bordes de la imagen. Si hay una gran cantidad de aristas, entonces tiene una variación alta y, por lo tanto, podemos concluir que no está borrosa.
Aunque inicialmente realizamos un aumento de datos, que detallaremos a continuación, decidimos no usarlo porque no notamos una diferencia en los resultados y el conjunto de datos ya era diverso.
Para extraer los rostros de los vídeos e imágenes del conjunto de datos, utilizamos el modelo preentrenado MTCNN, que importamos con la siguiente línea de código:
from facenet_pytorch import MTCNN
Este modelo se explica a continuación. artículo de Medium. En resumen, el modelo consta de tres redes en cascada. La primera, P-Net, propone regiones candidatas a diferentes escalas; la segunda, R-Net, descarta candidatos y refina sus cuadros delimitadores.
La tercera y última etapa (O-NET) es similar a la anterior pero tiene como objetivo describir en detalle el rostro, posicionando los ojos, la nariz y la boca.
Pudimos ver que el proceso de extracción de caras de las imágenes estuvo bien hecho con este ejemplo:
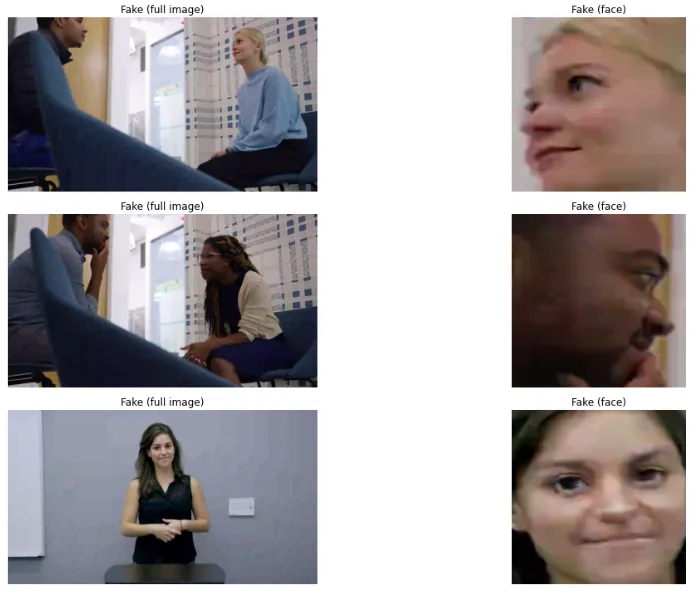
Ejemplo de caras extraídas con el modelo preentrenado MTCNN
Inicialmente, aunque luego lo prescindimos como se mencionó anteriormente, realizamos un aumento de datos para equilibrar adecuadamente nuestros conjuntos de datos de entrenamiento y validación. Para ello hemos utilizado las siguientes transformaciones:
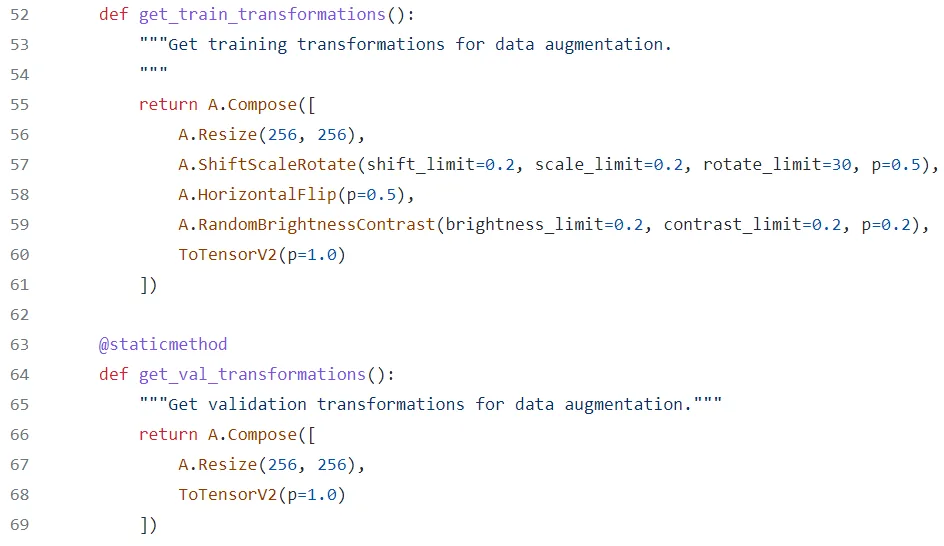
Código de aumento de datos
Clasificador de imágenes binarias mediante aprendizaje por transferencia
ResNetV1 pertenece a la familia de redes residuales presentada en 2015. Estas arquitecturas introducen conexiones de salto que facilitan el entrenamiento de redes profundas.
Las conexiones residuales ayudan a que la información y los gradientes fluyan a través de la red.
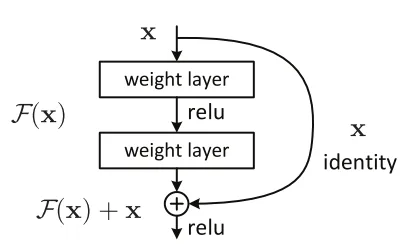
Ilustración de InceptionResnetV1
La información puede seguir tanto la secuencia de capas como las conexiones de salto. Esta estructura permite aprender ajustes residuales a las representaciones anteriores.
Si quieres saber más sobre ResNet y sus variantes, te recomendamos este artículo, del que hemos obtenido las imágenes de la arquitectura.
Para cargar el modelo en PyTorch necesitas esta línea de código:
from facenet_pytorch import InceptionResnetV1
Configuramos InceptionResnetV1 con una única salida para la clasificación binaria entre imágenes reales y falsas.
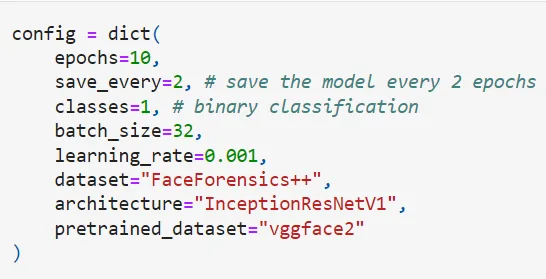
Configuración de InceptionResnetV1
Evaluación y Resultados
Resultados de métricas típicas como la precisión
Tras 80 épocas, la exactitud de validación fue del 96,6 % y la pérdida de validación, de 0,16. Estos resultados corresponden a nuestra partición de datos y no garantizan el mismo rendimiento ante cualquier deepfake.
Todas estas métricas se pueden ver en la siguiente imagen. Hemos realizado esta evaluación en Pesos y sesgos para la red InceptionResnetV1 entrenada con el conjunto de datos FaceForensics++.
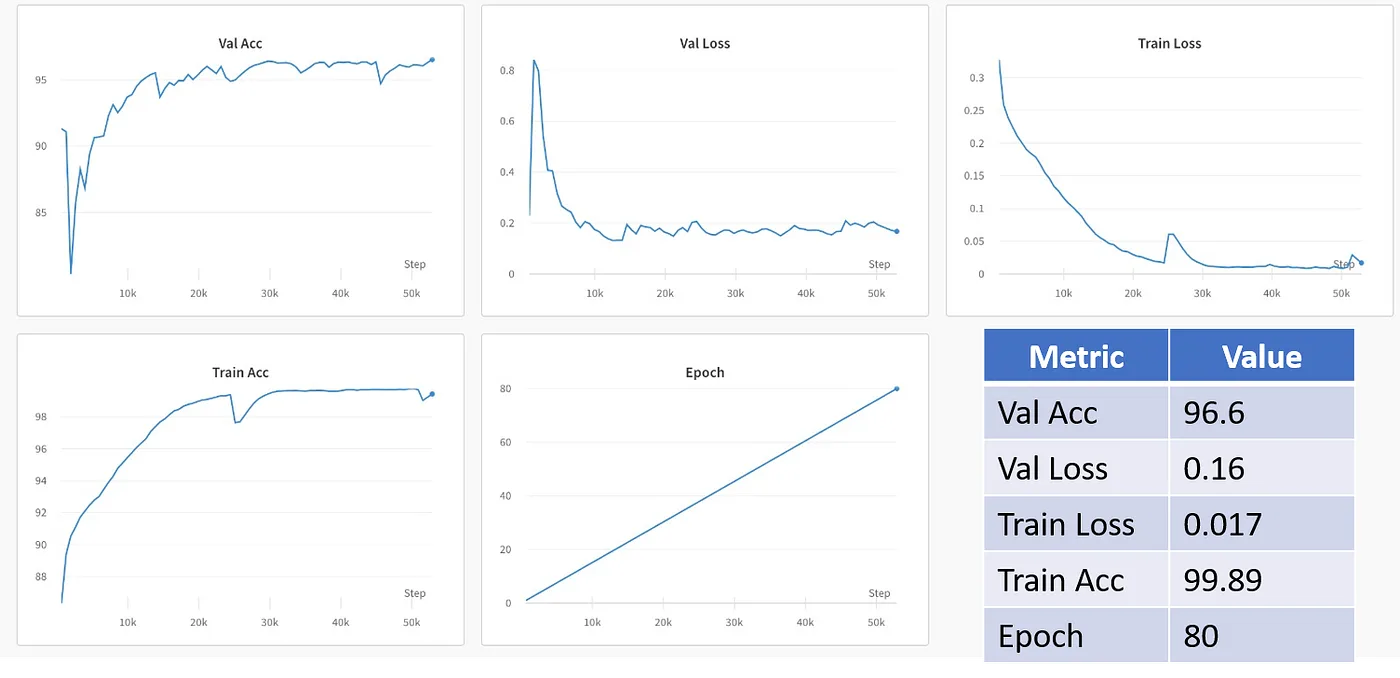
Métricas de nuestro modelo
En Weights & Biases también seguimos la evolución de los gradientes durante el entrenamiento.
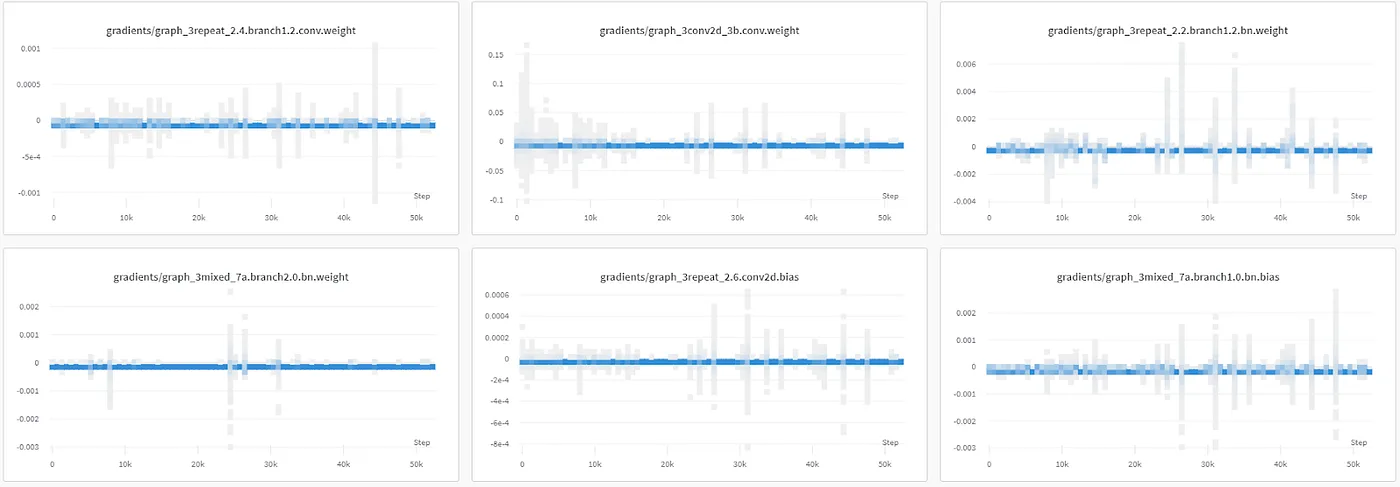
Seguimiento de los gradientes
Entrenamos el modelo en un portátil con una GTX 1070 y un tamaño de lote de 16 imágenes. Los lotes más grandes superaban la memoria disponible de la GPU.
La siguiente imagen muestra el uso de la GPU durante el entrenamiento.
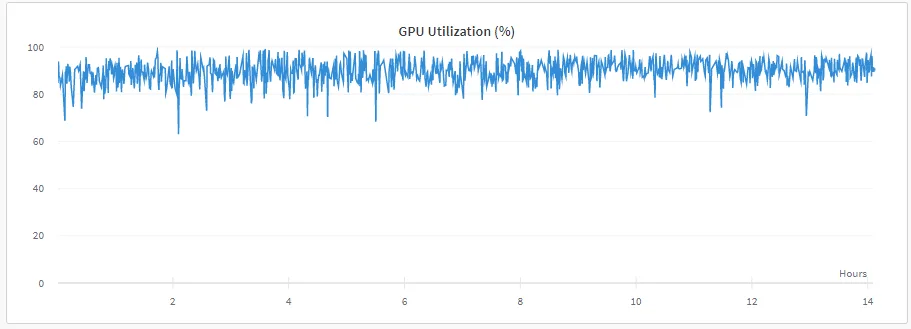
Uso de GPU durante el entrenamiento
Mapas de activación de clases para ver en qué se centra nuestro modelo
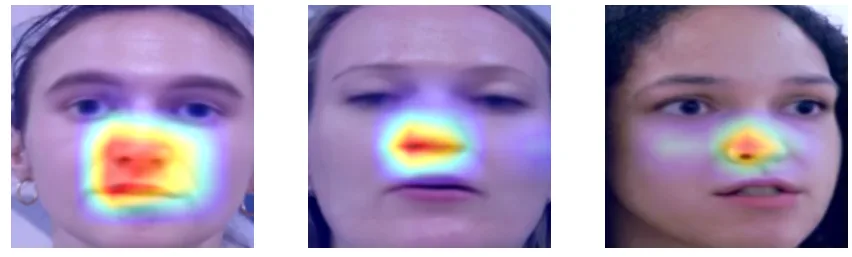
Para explorar las decisiones del modelo utilizamos Grad-CAM, un método que genera mapas de calor de las regiones que más contribuyen a una clasificación. La intensidad del mapa indica la relevancia aproximada de cada región para la clase analizada. Es una herramienta de interpretación: no demuestra por sí sola por qué una imagen es auténtica o falsa.
Tras analizar varios ejemplos, tanto reales como falsos, podemos llegar a algunas conclusiones. En primer lugar, nuestro modelo se centra principalmente en el área de la barbilla y la boca para detectar imágenes reales. Aquí podemos ver algunos ejemplos de imágenes reales donde podemos apreciarlo.
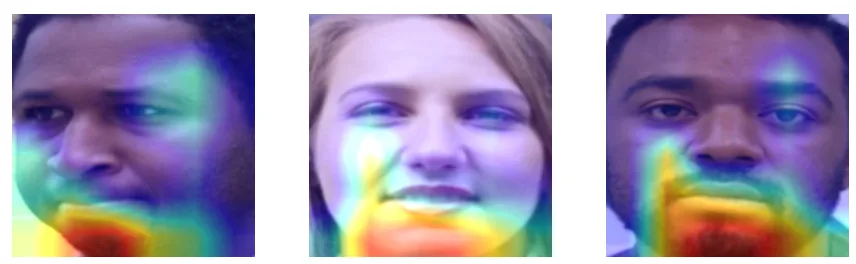
Sin embargo, cuando se trata de analizar imágenes falsas, nuestro modelo se centra más en el área de la nariz y la boca. Estos ejemplos de imágenes falsas lo demuestran claramente.
Inferencia usando Gradio
hemos usado GRADIO para crear una interfaz básica donde podamos implementar nuestro modelo.
Conclusiones, dificultades y próximos pasos
Próximos pasos: aplicación con PyTorch Live, clasificación de videos, tenga en cuenta el audio
Queremos explorar una aplicación con PyTorch Live y ampliar el proyecto al análisis de vídeo y audio.
Durante el proyecto hemos tenido una serie de dificultades, la principal ha sido a la hora de realizar la evaluación del modelo, tras las fases de entrenamiento, aunque la precisión binaria de ambas validaciones ha mostrado un buen resultado (96,39% tras 10 épocas), cuando probamos el modelo las clasificó erróneamente todas como “Reales”. Al principio atribuimos este error al conjunto de datos, que después de las transformaciones, había ciertas imágenes que tenían defectos y que teníamos que descargar los videos para extraer los rostros con mayor calidad.
Finalmente lo solucionamos filtrando las imágenes borrosas que eran muy perjudiciales para el entrenamiento del modelo. Evitamos el uso de transformaciones en el conjunto de datos de entrenamiento (solo cambiar el tamaño y convertir a tensor). Ampliamos el conjunto de datos de imágenes falsas filtrando las borrosas como se describe en la sección del conjunto de datos.
El siguiente paso de este proyecto sería crear un modelo que sea capaz de distinguir entre vídeos falsos y reales sin necesidad de extraer caras de diferentes fotogramas. Además de distinguir entre audio manipulado o audio generado por algoritmos de aprendizaje profundo.
El código se puede encontrar en nuestro repositorio de GitHub.
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicado originalmente el 17 de junio de 2022.
← Más historias de la comunidad