Detección de Discurso de Odio en Redes Sociales mediante Transformers y Natural Language Processing
Violentómetro Online explora la detección de lenguaje ofensivo en español con BETO, aumento de datos y explicaciones locales de las predicciones.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
La Paz. Deep Learning. 2021
La estrategia de las Naciones Unidas describe el discurso de odio como comunicaciones que atacan o emplean lenguaje despectivo o discriminatorio contra personas o grupos por factores de identidad, como la religión, el origen étnico o el género. Es una definición de trabajo, no una definición jurídica universal.
En 2021, distintos acontecimientos pusieron de relieve la difusión del discurso de odio. Por ejemplo, tras la final de la Eurocopa 2020 se produjo una oleada de ataques racistas en redes sociales contra jugadores de la selección inglesa que habían fallado penaltis. El anonimato, la distancia entre participantes y las dificultades de moderación pueden facilitar la difusión de estas agresiones.
Las plataformas utilizan mecanismos automáticos para detectar este contenido. La gráfica siguiente muestra publicaciones eliminadas por Facebook durante la pandemia. Estas cifras reflejan acciones de moderación; por sí solas no permiten medir cuánto aumentó el discurso de odio.
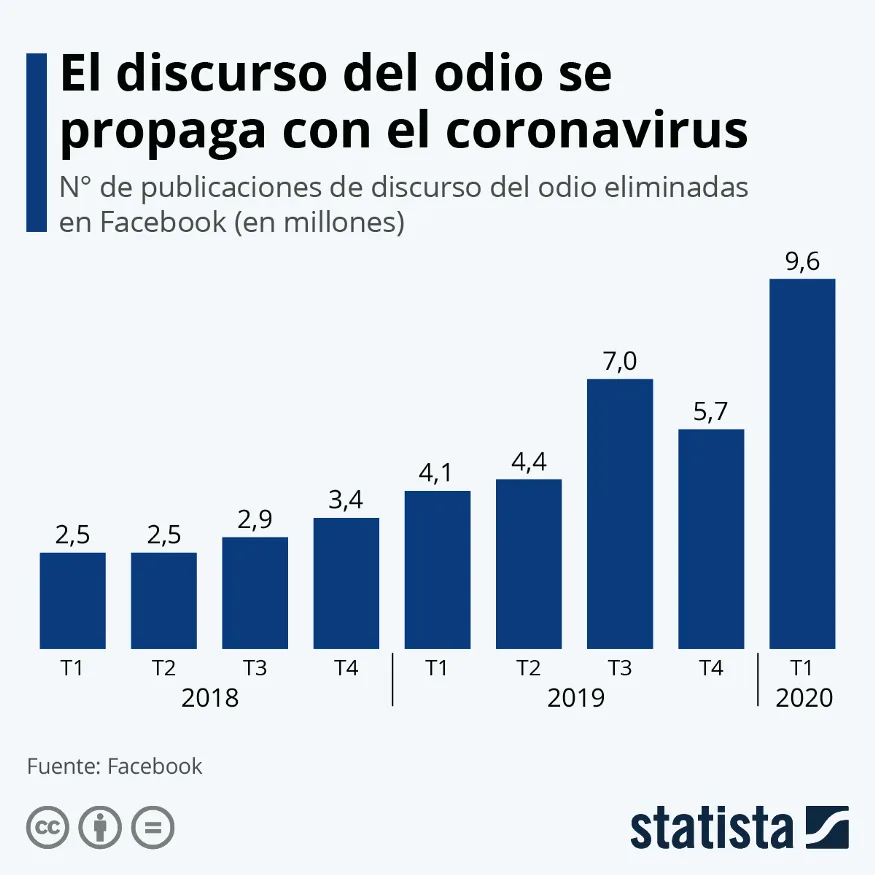
Figura 1: Publicaciones con discurso de odio eliminadas en Facebook. Fuente: https://es.statista.com/grafico/21710/publicaciones-de-discurso-del-odio-eliminadas-por-facebook/
Sin embargo, estas herramientas no se encuentran disponibles para cualquier ciudadano que quisiera analizar contenidos para determinar la existencia de discurso de odio. Es por esta razón que decidimos construir un método que sirviera como herramienta o base para la construcción de tecnologías que pudieran ayudar en la detección de este tipo de comentarios y así poder detener su propagación.
En este artículo, describimos cómo aplicamos métodos de Deep Learning y Procesamiento de Lenguaje Natural (NLP, por sus siglas en inglés) para la detección de discurso de odio en comentarios de Twitter en idioma español. Este trabajo es una continuación del proyecto Violentómetro Online. En dicho proyecto tuvimos un primer acercamiento al problema de detección de discurso de odio contra mujeres mediante el uso de técnicas clásicas de Machine Learning.
Solución
En esta sección, describimos la metodología (Transformers y Aumento de datos), así como los datos que utilizamos durante la realización de este proyecto. También detallamos los parámetros del modelo y las técnicas de interpretación que empleamos para entender sus predicciones.
Conjunto de Datos
MEX-A3T: Fake News and Aggressiveness Analysis es un evento organizado por la comunidad de NLP en México para detectar noticias falsas y textos con discurso de odio. Los organizadores compartieron con el equipo el conjunto de datos de entrenamiento que consiste en Tweets en el idioma español. El conjunto tiene las siguientes características:
- 7 mil 332 registros
- 2 columnas:
- Text: Texto del tuit, sin identificadores de usuario.
- Category:
- 1: Contiene odio en general (2110 registros)
- 0: No contiene odio (5222 registros)
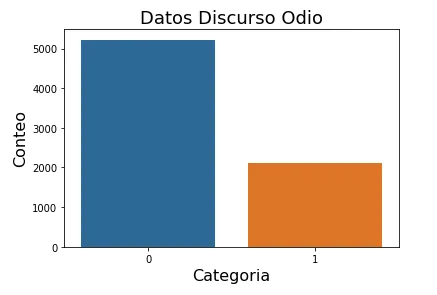
Figura 2: Distribución del conjunto de datos MEX-A3T
Aumento de datos
La distribución del conjunto de datos (figura 2) muestra menos registros de la categoría 1 que de la categoría 0. Para reducir este desequilibrio, generamos ejemplos sintéticos de la clase minoritaria.
Las operaciones de data augmentation que se aplicaron al 50% de mensajes de discurso de odio del dataset para obtener más ejemplos son las siguientes:
- Synonym Replacement: Reemplazo de algunas palabras por su sinónimo.
- Random Deletion: Borrado de algunas palabras de manera aleatoria con probabilidad p.
- Random Swap: Intercambio de palabras de manera aleatoria.
- Random Insertion: Inserción de un sinónimo en una posición aleatoria n.
Modelo
Para crear el modelo utilizamos la librería de Transformers de Hugging Face que contiene modelos preentrenados para clasificación de texto, extracción de información y traducción, entre otras tareas. Utilizamos el modelo BETO, el cual es un modelo con la arquitectura BERT entrenado con un corpus en español, para obtener la representación vectorial del texto (embeddings). Además se utilizaron dos capas adicionales: multi-layer bi-directional GRU y otra lineal que obtiene las predicciones. Es posible utilizar otras arquitecturas en lugar de multi-layer bi-directional GRU, pero para este proyecto decidimos utilizar ésta ya que es más eficiente computacionalmente que LSTM.
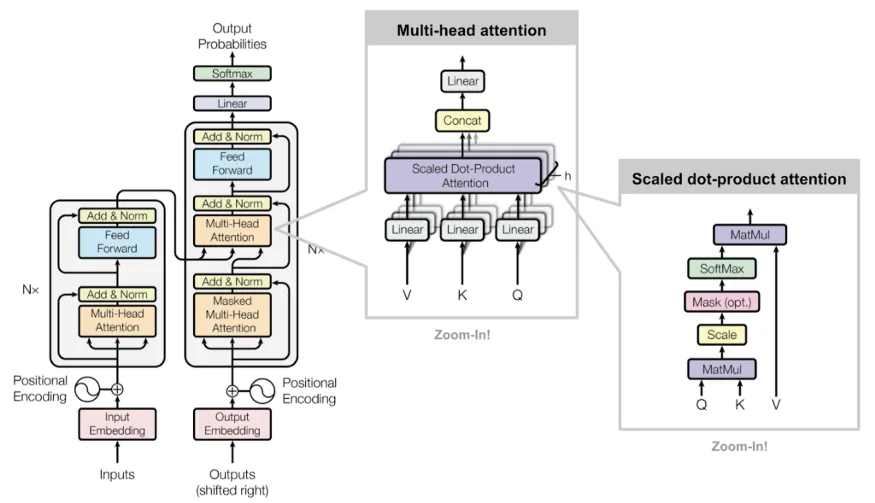
Figura 3: Arquitectura de Transformers. Fuente: https://lilianweng.github.io/lil-log/2018/06/24/attention-attention.html#transformer
Nota: El código completo se puede consultar en el repositorio del proyecto violentometro-online.
Mejores Parámetros
Probamos diferentes variaciones de BETO para obtener los mejores parámetros de entrenamiento para el modelo final. Evaluamos cada modelo utilizando la métrica F1 ya que ésta es comúnmente utilizada en problemas de clasificación de textos además de tomar en cuenta las siguientes variaciones:
- Model: Variación de BETO (cased y uncased).
- Epochs: Número de pasadas completas por los datos de entrenamiento.
- Preprocessed: Preprocesamiento del texto que incluye operaciones como remover emojis, dígitos, stopwords, entre otros.
- Sample frac: Proporción de ejemplos sintéticos en el conjunto de datos.
La siguiente tabla muestra los modelos con los que obtuvimos los mejores resultados:
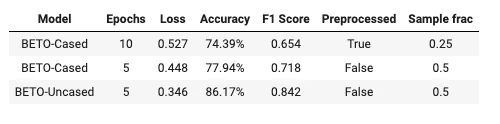
Tabla 1: Resultados de los mejores parámetros del modelo
El mejor modelo de nuestras pruebas, BETO-Uncased, obtuvo un F1 de 0,842 sin el preprocesamiento descrito y con una cantidad importante de datos sintéticos. Este resultado superó el que habíamos obtenido anteriormente con Random Forest.
Explicación de las Predicciones
Utilizamos la API Lime para aproximar qué elementos del texto influyeron en una predicción concreta. Para utilizar LIME, creamos una función que devuelve un array de NumPy con las probabilidades de las clases. LIME estima la contribución local de las palabras; no ofrece una explicación completa del funcionamiento interno del modelo. La figura 4 muestra un ejemplo:
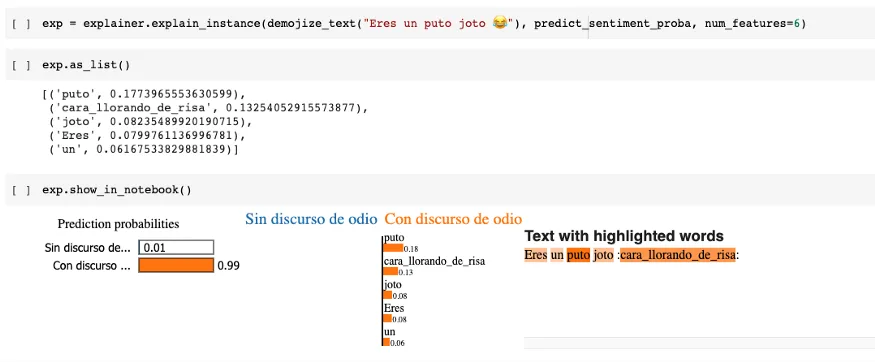
Figura 4: Ejemplo de explicación de la predicción de un texto con discurso de odio
Se puede observar que en la predicción del modelo, se le dio más peso a la palabra que aparece primero en la lista además de la representación en texto del emoji.
Aplicación Web
Desarrollamos el prototipo de una aplicación web con el modelo que obtuvo los mejores resultados. Dicha aplicación web se puede consultar aquí. El prototipo fue desarrollado con el framework Streamlit y utilizamos GitHub Actions para desplegarlo en AWS mediante integración continua. La siguiente imagen muestra el prototipo:
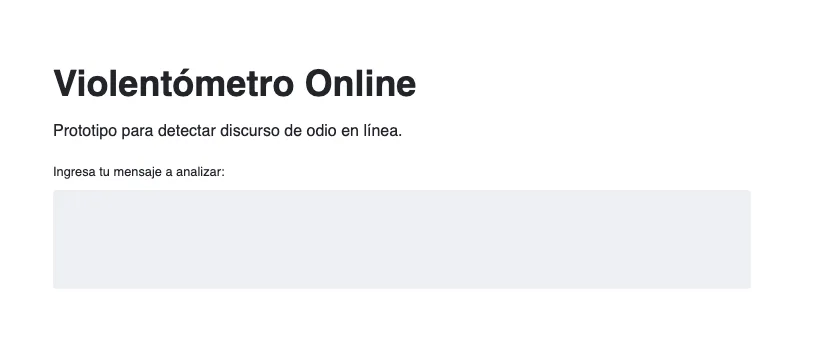
Figura 5: Aplicación Web Violentómetro Online
Los usuarios pueden introducir cualquier texto en la aplicación. Cuando los usuarios pulsan las teclas Ctrl+Enter, la aplicación (modelo) devuelve como resultado las siguientes categorías:
- 1 = Contiene discurso de odio
- 0 = No contiene discurso de odio
Conclusiones
El objetivo de nuestro proyecto es desarrollar un método efectivo para detectar automáticamente la violencia verbal en idioma español que ocurre en discursos en línea. Con este proyecto pudimos crear un método que tiene una efectividad bastante razonable utilizando técnicas avanzadas como Deep Learning y data augmentation, además de estar construido con herramientas gratuitas y de código abierto. También se utilizó una API que nos permitió entender las predicciones del modelo.
Entre los siguientes pasos de nuestro proyecto podemos destacar lo siguiente:
- Utilizar otras variantes del idioma español.
- Recopilar ejemplos dirigidos a distintos grupos, por ejemplo por motivos de género, religión u origen, para evaluar y mejorar la robustez del modelo.
- Incorporar un mecanismo de feedback para los usuarios de la aplicación web.
Agradecimientos
Queremos agradecer a María José Díaz-Torres, Paulina Alejandra Morán-Méndez, Luis Villasenor-Pineda, Manuel Montes-y-Gómez, Juan Aguilera, Luis Meneses-Lerín, autores del Dataset MEX-A3T y del artículo Automatic Detection of Offensive Language in Social Media: Defining Linguistic Criteria to build a Mexican Spanish Dataset. También queremos agradecer al equipo que hizo posible Saturdays.AI La Paz por todo su trabajo y dedicación en la organización del programa.
Fuentes
- LA ESTRATEGIA Y PLAN DE ACCIÓN DE LAS NACIONES UNIDAS PARA LA LUCHA CONTRA EL DISCURSO DE ODIO: https://www.un.org/en/genocideprevention/documents/advising-and-mobilizing/Action_plan_on_hate_speech_ES.pdf
- Detección de discursos de odio por motivos de género en español con procesamiento del lenguaje natural: https://becominghuman.ai/detecting-gender-based-hate-speech-in-spanish-with-natural-language-processing-cdbba6ec2f8b
- EDA: técnicas sencillas de aumento de datos para mejorar el rendimiento en tareas de clasificación de texto. Jason Wei, Kai Zou. EMNLP-IJCNLP 2019
- BETO: Spanish BERT: https://github.com/dccuchile/beto
- Lime project: https://github.com/marcotcr/lime
Integrantes
Presentación del proyecto: DemoDay
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Explora los cursos disponibles
Conoce la comunidad de Saturdays.AI

Una historia de la comunidad Saturdays.AI. Publicada originalmente el 4 oct 2021.
← Más historias de la comunidad