res.txt: Resumen y traducción de texto con Machine Learning
res.txt combina un modelo BART de resumen y otro de traducción para ayudar a leer documentos en inglés. Compartimos el proceso y los resultados.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
La Paz. 2021
Introducción
Resumir consiste en seleccionar la información esencial de un documento y expresarla de forma más breve. Las personas lo hacemos al comprender el texto y reformular sus ideas. Los métodos automáticos pueden ayudar cuando el volumen de información supera el tiempo disponible para leerla, aunque sus resultados necesitan revisión.
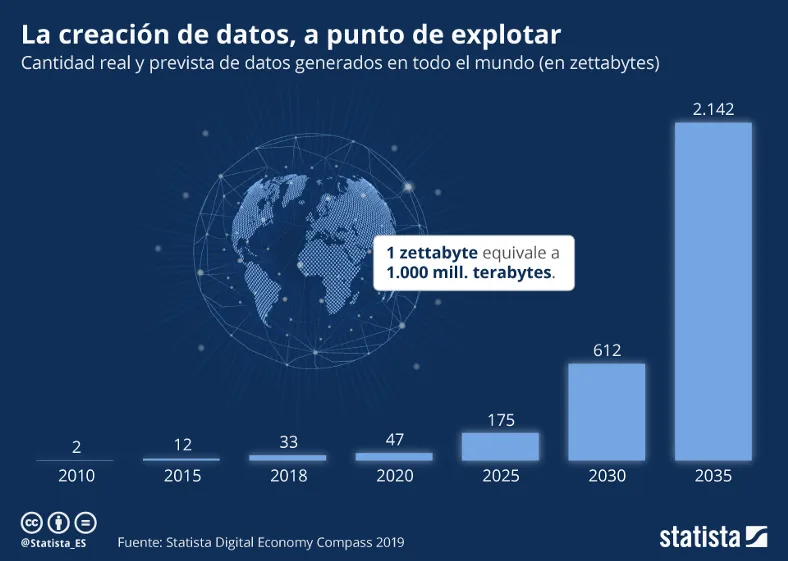
Figura 1: Cantidad de datos generados de manera anual
Problema
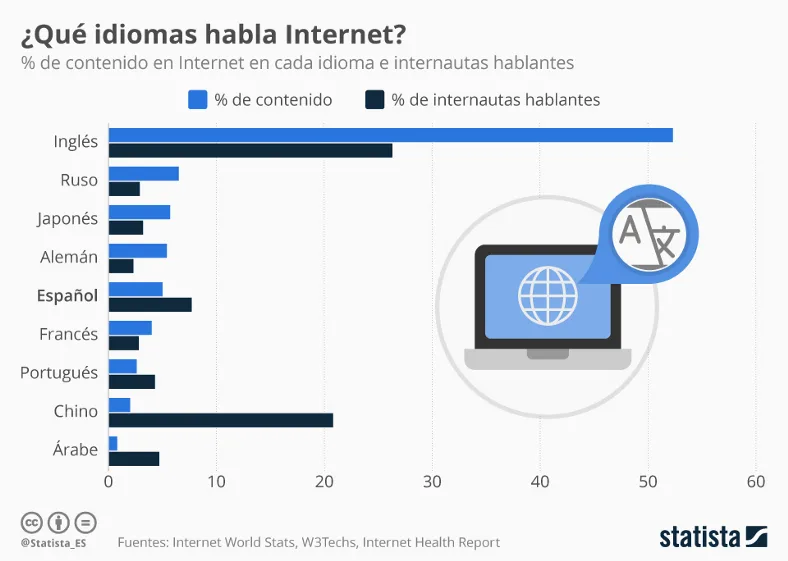
Figura 2: Idiomas predominantes en internet
Mantenerse al día exige leer fuentes que a menudo son extensas y, en muchos ámbitos, están en inglés. Esto puede añadir una barrera de tiempo y de idioma.
Objetivo
Desarrollar una aplicación que pueda ayudar a la comprensión de un documento de texto en inglés y acorte el tiempo de comprensión de un texto largo.
Solución propuesta
Construir una aplicación con modelos de deep learning que utilicen mecanismos de atención. Estos mecanismos calculan relaciones entre partes de la entrada y ayudan al modelo a ponderar la información relevante; no reproducen literalmente la atención humana.
Dataset
CNN/Daily Mail reúne más de 300.000 artículos periodísticos en inglés. La versión utilizada ocupaba aproximadamente 1,27 GiB y ofrece artículos junto a sus resúmenes de referencia. Se usa para tareas de comprensión y resumen, tanto extractivo como abstractivo.
Modelo de DL
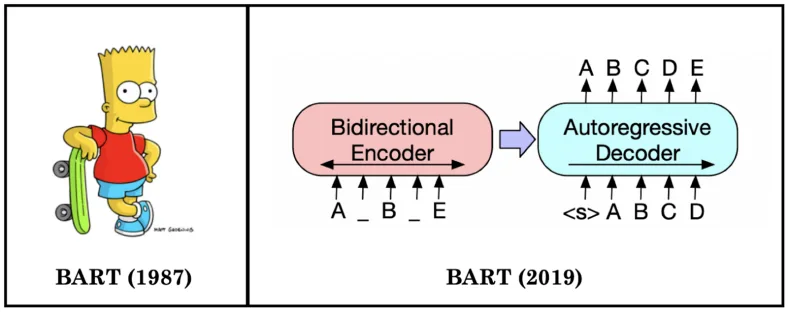
Figura 3: Esquema BART
BART utiliza una arquitectura transformer de codificador-decodificador. Combina un codificador bidireccional, como BERT, con un decodificador autorregresivo, como GPT, y utiliza activaciones GeLU. Entre sus características destacan:
- Cada capa del decodificador, además, realiza una atención cruzada sobre la capa oculta final del codificador (como en el modelo de secuencia a secuencia del transformador)
- En la arquitectura descrita por sus autores, BART no añade la capa feed-forward que BERT utiliza antes de predecir palabras.
En pocas palabras, el codificador representa el texto de entrada y el decodificador genera el texto de salida.
Partimos del modelo base disponible en Hugging Face.
Hugging Face ofrece herramientas de código abierto y un catálogo de modelos y datasets. En este proyecto utilizamos sus bibliotecas y recursos para preparar los datos y ajustar el modelo.
Entrenamiento del modelo
Los siguientes fragmentos conservan las API utilizadas en el proyecto de 2021. Hemos recuperado el formato del código; para ejecutarlo con versiones actuales habría que adaptar las dependencias y sus interfaces.
El proyecto fue realizado en base a los modelos provistos por la página de Hugging Face, la cual posee una gran colección tanto de modelos como de datasets para tareas de NLP (Procesamiento de Lenguaje Natural). De todas las opciones se seleccionó el modelo de sumarización abstractiva BART.
El código hace uso de las librerías “datasets” y “transformers” de HuggingFace, además de nltk para realizar la evaluación.
# Imported libraries
from datasets import load_dataset, load_metric
from transformers import (
    AutoTokenizer, AutoModelForSeq2SeqLM, DataCollatorForSeq2Seq,
    Seq2SeqTrainingArguments, Seq2SeqTrainer, pipeline,
)
import nltk
import numpy as np
Para realizar el fine tuning se hizo uso del dataset “cnn_dailymail”, para la evaluación se utilizó la métrica “rouge”, y el modelo base que se usó fue “facebook/bart-base”.
raw_datasets = load_dataset("cnn_dailymail", "3.0.0")
metric = load_metric("rouge")
model_checkpoint = "facebook/bart-base"
Se cargaron un tokenizer y un modelo haciendo referencia al modelo base seleccionado.
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
Del dataset “cnn_dailymail” se extrajeron los elementos que se encuentran bajo las etiquetas de “article” y “highlights” como datos de entrada y salida respectivamente.
max_input_length = 512
max_target_length = 128

def preprocess_function(examples):
    inputs = [doc for doc in examples["article"]]
    model_inputs = tokenizer(inputs, max_length=max_input_length, truncation=True)
    with tokenizer.as_target_tokenizer():
        labels = tokenizer(examples["highlights"], max_length=max_target_length, truncation=True)
    model_inputs["labels"] = labels["input_ids"]
    return model_inputs

tokenized_datasets = raw_datasets.map(preprocess_function, batched=True)
Antes de entrenar el modelo se realiza la configuración de hiperparámetros.
batch_size = 4
args = Seq2SeqTrainingArguments(
 "BART_Finetuned_CNN_dailymail",
 evaluation_strategy = "epoch",
 learning_rate=2e-5,
 per_device_train_batch_size=batch_size,
 per_device_eval_batch_size=batch_size,
 gradient_accumulation_steps=2,
 weight_decay=0.01,
 save_total_limit=2,
 num_train_epochs=1,
 predict_with_generate=True,
 fp16=True,
)
Se crea una función para realizar el cómputo de métricas haciendo uso de rouge score.
def compute_metrics(eval_pred):
    predictions, labels = eval_pred
    decoded_preds = tokenizer.batch_decode(predictions, skip_special_tokens=True)
    # Replace -100 in the labels before decoding.
    labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
    decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)
    # ROUGE expects a newline after each sentence.
    decoded_preds = ["\n".join(nltk.sent_tokenize(pred.strip())) for pred in decoded_preds]
    decoded_labels = ["\n".join(nltk.sent_tokenize(label.strip())) for label in decoded_labels]
    result = metric.compute(predictions=decoded_preds, references=decoded_labels, use_stemmer=True)
    result = {key: value.mid.fmeasure * 100 for key, value in result.items()}
    prediction_lens = [np.count_nonzero(pred != tokenizer.pad_token_id) for pred in predictions]
    result["gen_len"] = np.mean(prediction_lens)
    return {k: round(v, 4) for k, v in result.items()}
Una vez inicializado el modelo, definidos los hiperparámetros, datasets, tokenizer y métricas creamos un Trainer.
data_collator = DataCollatorForSeq2Seq(tokenizer, model=model)
trainer = Seq2SeqTrainer(
 model,
 args,
 train_dataset=tokenized_datasets["train"],
 eval_dataset=tokenized_datasets["validation"],
 data_collator=data_collator,
 tokenizer=tokenizer,
 compute_metrics=compute_metrics
)
Descargamos punkt tokenizer que nos permite transformar un texto por oraciones.
nltk.download('punkt')
Finalmente realizamos el entrenamiento y la evaluación
trainer.train()
trainer.evaluate()
Resultados
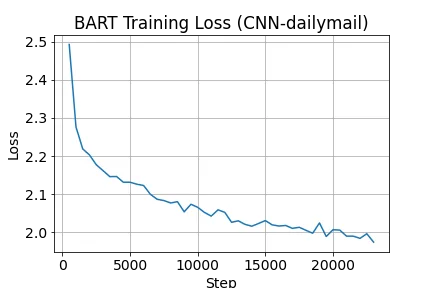
Figura 4: Pérdida a lo largo del entrenamiento
Una vez finalizada la fase de entrenamiento podemos observar la pérdida a lo largo del entrenamiento realizado en el dataset “train”.
Si bien se muestran buenos resultados, se pueden mejorar haciendo mejor sintonización y tiempos de entrenamiento con el modelo.
Los resultados obtenidos al evaluar el modelo entrenado con la métrica rouge score fueron los siguientes:
eval_loss: 1.5510817766189575
eval_rouge1: 46.8771
eval_rouge2: 23.5647
eval_rougeL: 39.6525
eval_rougeLsum: 43.3625
eval_gen_len: 17.8154
Conclusiones
Construimos una aplicación que resume y traduce texto. Los resultados de este experimento fueron prometedores, aunque las métricas ROUGE no garantizan que cada resumen sea correcto o que conserve todos los matices.
Utilizamos dos modelos: uno para resumir, ajustado por el equipo y publicado en huggingface , y otro ya entrenado para traducir del inglés al español:https://huggingface.co/Helsinki-NLP/opus-mt-en-es).
Trabajo Futuro
Mejorar los tiempos de inferencia que tienen los modelos al usar servicios en la nube.
Ampliar las entradas admitidas: además de texto pegado, permitir archivos como TXT o DOCX.
Integrantes
Sergio Flores. — www.linkedin.com/in/sergio-flores-ll
Anna Montevilla. — www.linkedin.com/in/anna-i-montevilla
Koichi Sato. — www.linkedin.com/in/koichi-sato-316902182
Josmar Suarez. — www.linkedin.com/in/josmar-suarez-l
Referencias
https://arxiv.org/abs/1910.13461v1
https://huggingface.co/datasets/cnn_dailymail
https://huggingface.co/transformers/model_doc/bart.html
https://arxiv.org/abs/1810.04805
https://medium.com/walmartglobaltech/the-journey-of-open-ai-gpt-models-32d95b7b7fb2
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Explora los cursos disponibles
Conoce la comunidad de Saturdays.AI
Autoría
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 22 nov 2021.
← Más historias de la comunidad