Descubriendo la calidad del sueño con técnicas de Machine Learning
Un proyecto analiza encuestas de sueño durante la pandemia con Random Forest y Gradient Boosting, explicando sus resultados y límites de interpretación.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
Latinoamérica en línea. Segunda Edición. 2021
El brote de COVID-19 y las respuestas sociales adoptadas para combatir su propagación (por ejemplo, el confinamiento y el distanciamiento social) han tenido consecuencias de gran alcance, pero han brindado también una oportunidad única para examinar los efectos que el estrés crónico y la incertidumbre pueden tener en los patrones de sueño de la población en general.
El estrés y el sueño están relacionados, y los cambios en el descanso pueden acompañarse de dificultades emocionales. El metanálisis citado sobre la pandemia de COVID-19(1) estimó una prevalencia agrupada de problemas de sueño del 32,3% en la población general, con variación entre estudios. Esta asociación no demuestra por sí sola que todos los casos fueran causados por la pandemia.
Se sabe que además del estrés debido a la pandemia por COVID-19, hay otros factores que podrían alterar la resiliencia mostrada bajo estrés, por ejemplo,la falta de interacción social, la falta de ejercicio físico, el bienestar económico etc.
El proyecto explora asociaciones entre la calidad del sueño y variables personales y contextuales durante una situación de estrés prolongado. El objetivo es generar preguntas e hipótesis que puedan investigarse, no emitir recomendaciones clínicas a partir del modelo.
Metodología
Utilizamos la encuesta de sueño y bienestar de Boston College, descrita por Cunningham y colaboradores en 2021. El proyecto trabajó inicialmente con datos de 1.518 participantes reclutados a través de redes sociales, con variables como edad, situación económica, pertenencia a minorías y factores de riesgo.
Una vez seleccionada la base de datos proseguimos a la limpieza y procesamiento de los datos. Después de este proceso, el número de variables de nuestra base de datos fue de 216 y el tamaño de la muestra se redujo a 839 sujetos debido a que no toda la información estaba completa.
Las variables principales incluyen información demográfica (edad, identidad de género, ingresos, etc.), información relativa a los hábitos de sueño, niveles de ansiedad, regulación emocional cognitiva, y personalidad, entre otras.
Utilizamos la puntuación total del índice de calidad del sueño de Pittsburgh (PSQI), que va de 0 a 21. Cuanto mayor es la puntuación, peor es la calidad del sueño percibida. Es una medida de cuestionario y no sustituye una evaluación clínica.
Análisis del dataset
Observamos la distribución de los datos
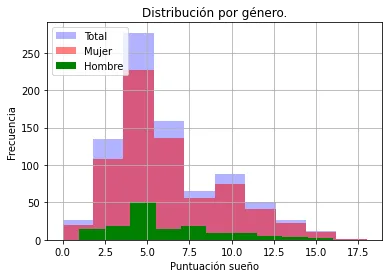
Puntuación sueño
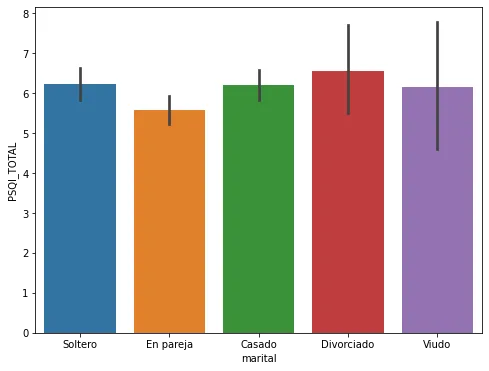
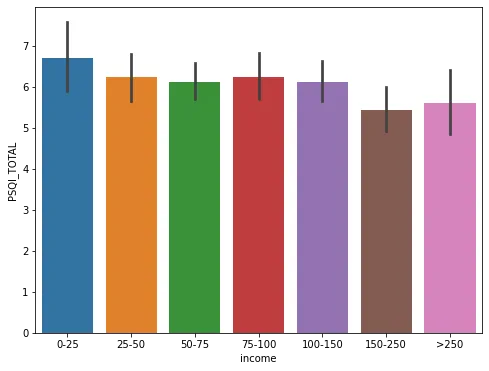
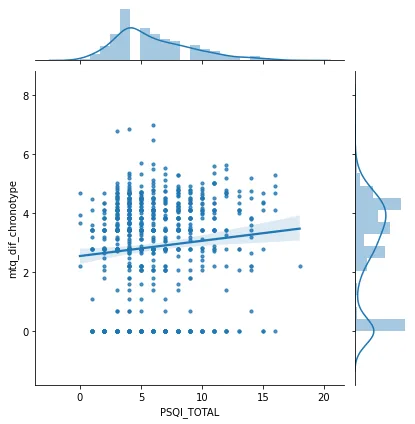
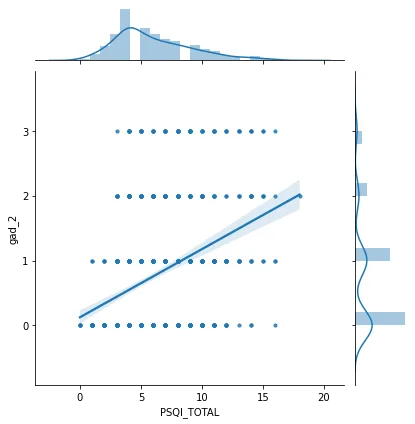
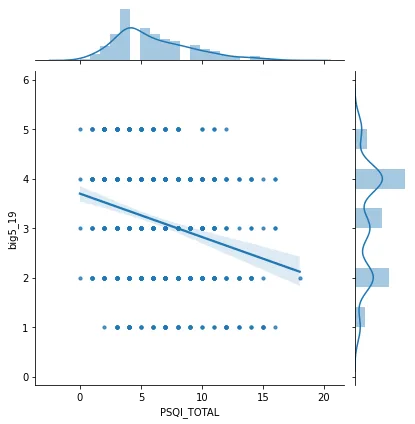
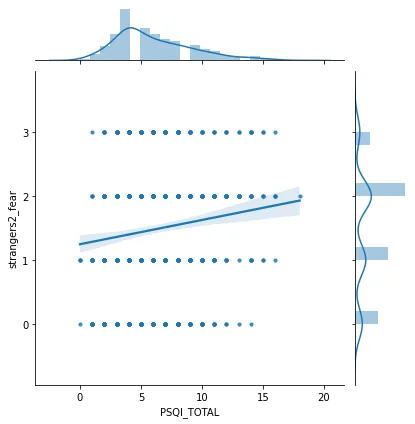
Exploramos la correlación de la puntuación del sueño con otras variables:
- Diferencia de cronotipo antes y durante la pandemia
- Variable de ansiedad (No consigue dejar de preocuparse)
- Variable de personalidad (Se considera relajado)
- Variable de ansiedad social (Miedo a extraños post covid)
Modelos
Clasificación
En el conjunto de datos, nuestra métrica elegida para evaluar toma valores del 0 al 18 (no se han observado casos de 19 a 21). Si tomamos estos valores como si fueran clases o subconjuntos podemos aplicar un método de clasificación.
RandomForestClassifier obtuvo inicialmente una puntuación cercana a 0,20. Al agrupar los valores en menos clases, el resultado aumentó: aproximadamente 0,5 con seis clases y 0,7 con cuatro. Las tareas resultantes son distintas, por lo que estas cifras no representan una mejora directamente comparable del mismo problema.
Para tener una explicación de estos resultados mostramos los shap values de las predicciones:
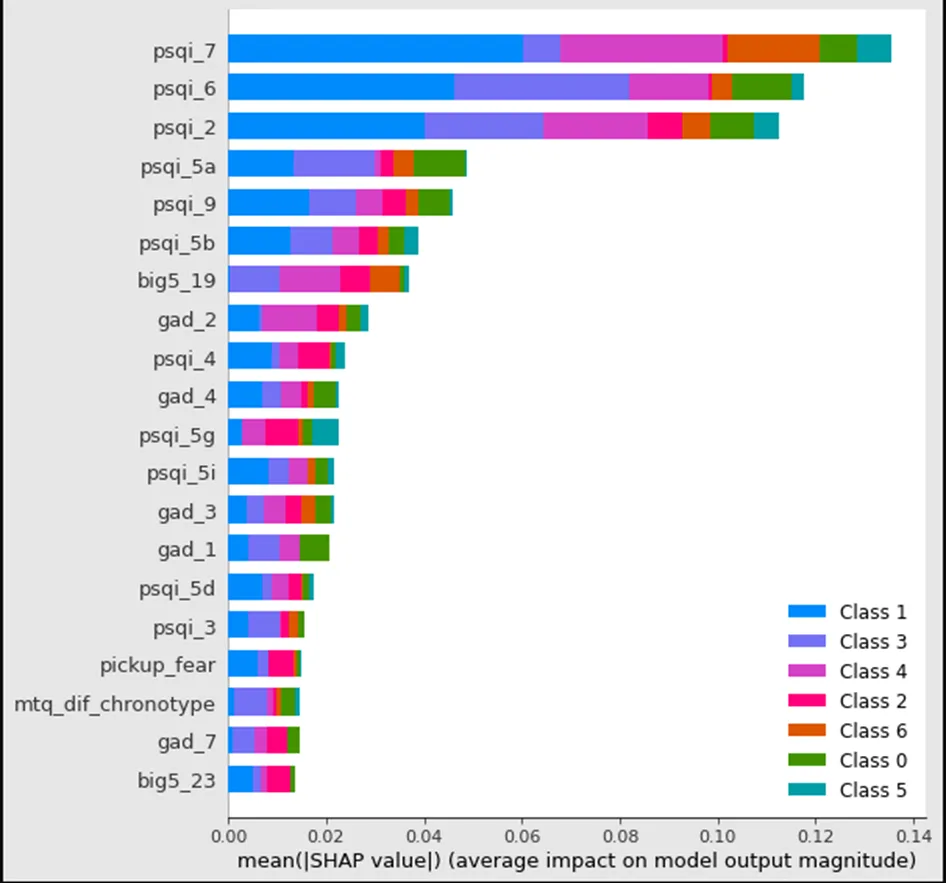
Podemos observar que las variables que aparecen con más peso, son las que están directamente ligadas con datos de sueño (psqi_*). Las primeras de todas ellas son si la persona ha recurrido a medicinas para dormir, la percepción que declara de su calidad de sueño, y el tiempo que tarda en conciliar el sueño. Dentro de estas variables también observamos que tienen impacto datos de personalidad (big5_*) , como si se considera una persona relajada, o ansiedad (gad_*), como la capacidad de dejar las preocupaciones.
Que las variables del propio cuestionario PSQI tengan mucho peso es esperable, pero limita la interpretación: si se usan componentes del índice para predecir su total, el modelo puede estar reconstruyendo la puntuación. Para estudiar factores externos habría que excluir esos componentes y volver a evaluar. Además, la muestra es pequeña para distinguir tantas clases.
Regresión
Para estimar la puntuación exploramos Random Forest, Gradient Boosting y HistGradientBoosting. El listado original también incluía regresión logística, que corresponde a clasificación y no a regresión de una puntuación continua.
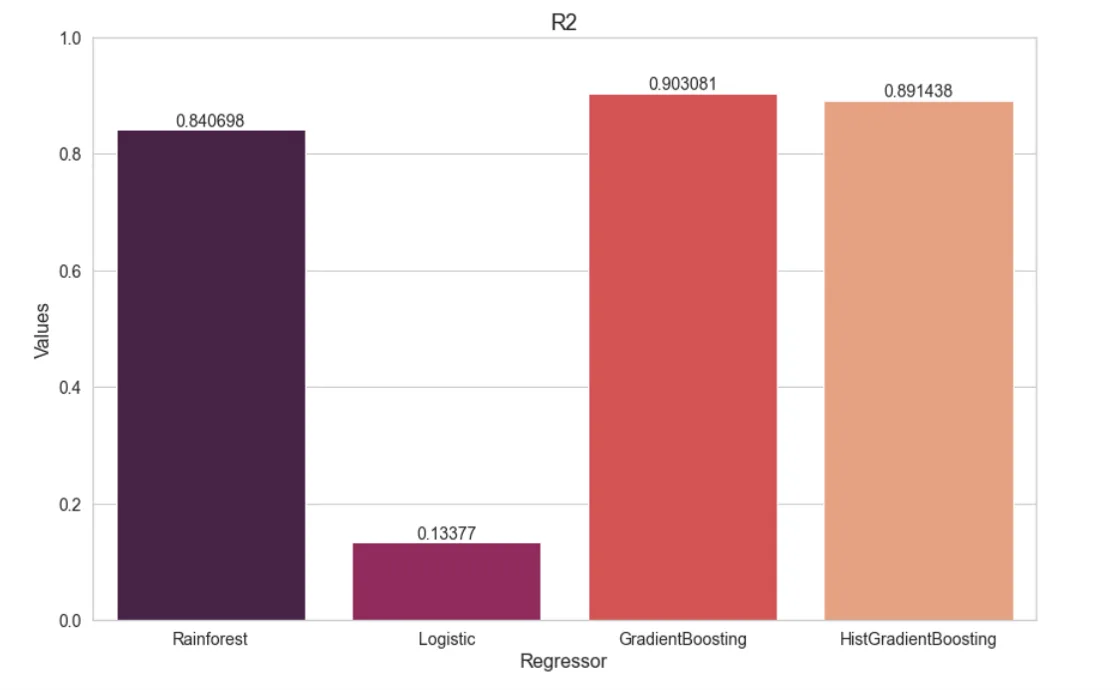
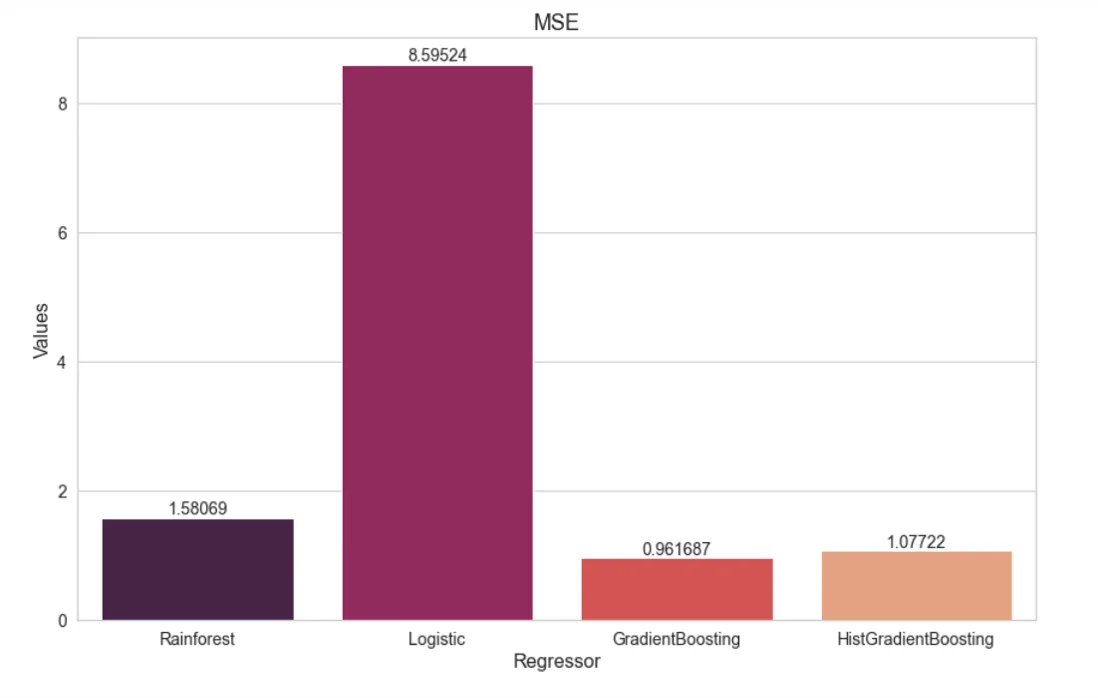
Gradient Boosting obtuvo el mayor coeficiente de determinación reportado: R² = 0,9. Esta cifra resume la varianza explicada respecto a una predicción constante de referencia; no significa que el 90% de los puntos coincida con una recta ni que haya un 90% de aciertos.
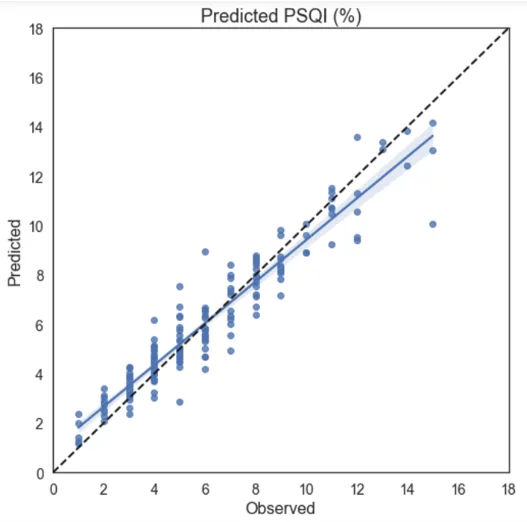
Probamos la búsqueda de hiperparámetros con RandomizedSearchCV sin mejorar el resultado. También redujimos las variables a 138 componentes mediante PCA, pero el R² bajó a 0,57.
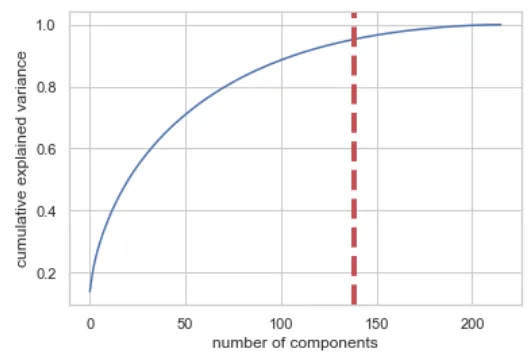
Análisis PCA para reducir el número de variables
Por esta razón decidimos quedarnos con el resultado obtenido con el algoritmo de GradientBooster como la mejor opción para predecir la calidad del sueño.
Conclusión
El resultado de R² = 0,9 debe interpretarse con las limitaciones anteriores, especialmente la inclusión de variables que forman parte del propio índice. Entre las variables destacadas por el modelo estaban:
- Medicación
- Tiempo que toma a la persona conciliar el sueño
- Entusiasmo por llevar a cabo cosas
- Manejo del estrés
- Control de las preocupaciones
Estas asociaciones pueden orientar investigaciones posteriores, pero no demuestran causas de la mala calidad del sueño ni permiten prescribir intervenciones. Antes habría que revisar las entradas del modelo y validar su generalización.
El siguiente paso sería ampliar la muestra, revisar posibles fugas de información y evaluar con datos independientes.
Referencias
1. Jahrami, H. et al. Problemas del sueño durante la pandemia de COVID-19 por población: una revisión sistemática y un metanálisis. J Clin Sleep Med, jcsm-8930. (2020).
2. Cunningham, TJ, Fields, EC y Kensinger, EA. (2021) Datos de la encuesta de bienestar y sueño diario de Boston College durante la fase inicial de la pandemia de COVID-19. Datos de ciencia 8, 110. https://www.nature.com/articles/s41597-021-00886-y
Integrantes
- Ana Galindo Alonso
- Bianey Palma
Presentación del proyecto: DemoDay
¡Más Inteligencia Artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 9 mar 2022.
← Más historias de la comunidad