Machine Learning para prevenir el acoso online de menores
Tótem explora el uso de machine learning para identificar conversaciones que requieren atención, con un prototipo entrenado en datos en inglés.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
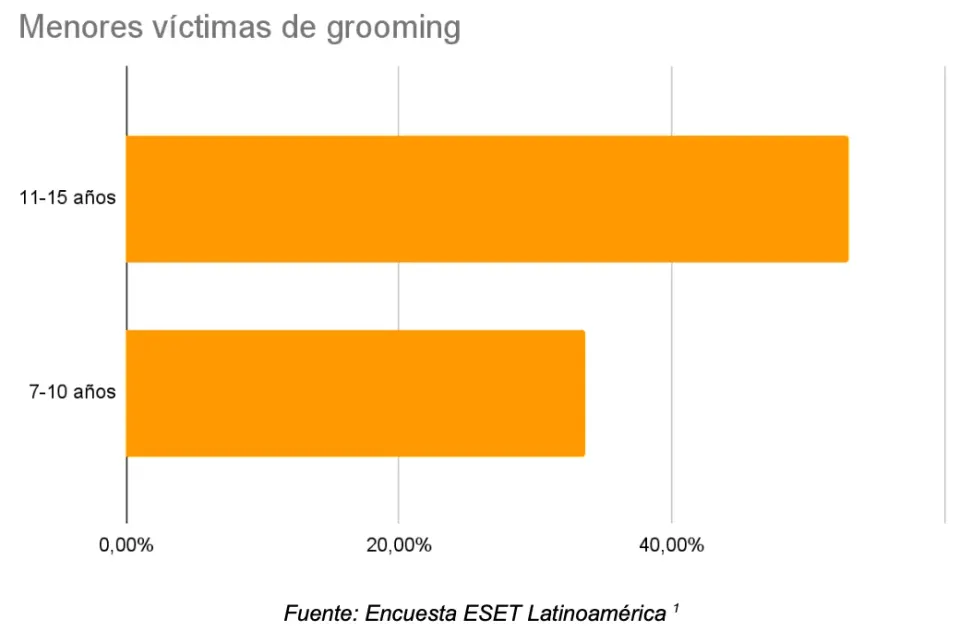
Acompañar a los menores para que naveguen con más seguridad
Cuando tus hijos navegan en internet, ¿aplicas o configuras algún filtro de control parental?
Latinoamérica en línea. Segunda Edición. 2021
En la actualidad, el hostigamiento o acoso sexual online es conocido en el lenguaje anglosajón como grooming online; donde un adulto logra tener contacto a través de un medio tecnológico contra un menor de edad, siendo el objetivo del abusador atacar a través de interacciones como: acoso a su moral, hablar de sexo, conseguir material íntimo o acordar un encuentro sexual.
El grooming online se ha incrementado a raíz del confinamiento por el COVID-19. En Argentina aumentó más del 30% en el 2020(2), en datos del INEGI del 2019 arrojan que en México creció el 27%(3) , mientras que el diario ABC de España, reportó un incremento del 410% en los últimos años (4).
Contexto… please!
Las herramientas de control parental pueden bloquear aplicaciones o sitios, limitar compras y gestionar el uso de dispositivos. Nuestro proyecto explora una tarea distinta: analizar el texto de conversaciones para señalar posibles riesgos que después debe valorar una persona.
Derivado del confinamiento por el COVID-19 los niños y adolescentes se han visto más vulnerables debido a la necesidad de utilizar los dispositivos móviles como parte de sus actividades diarias, gran parte de eso fue para tomar clases virtuales, realizar tareas y en otras ocasiones como medio de entretenimiento y comunicación, al verse limitados por no poder salir y compartir tiempo con familiares y amigos.
La nula supervisión ha permitido que menores de edad hayan experimentado situaciones indeseadas sin el conocimiento de los adultos.
De acuerdo al sitio salud con lupa, el 39% de los acosos se han experimentado por Facebook, seguida por el 23% en Instagram y un 14% por WhatsApp (5).
La propuesta
Tótem significa protector
Tótem: «Déjalo navegar sin preocupaciones»
Sin tanto rollo, esto es lo que hicimos.
Actualmente contamos con un dataset de conversaciones en inglés, las cuales son analizadas y catalogadas como normales o peligrosas, una vez obtenido esté resultado se enviará una notificación al padre o tutor si se detecta una conversación inapropiada.
¡¿Cómo hicieron eso?!
Aquí te explicamos qué fue lo que aplicamos para obtener los resultados que te mostraremos más adelante…
Fase 1 (Aquí vamos…)
Obtención de los datos
Obtuvimos los datos del proyecto PAN Lab 2012, citado en la referencia 6, tras solicitar y recibir permiso para usarlos. El corpus contenía conversaciones de distintas duraciones y estilos de escritura en formato XML. Lo convertimos a CSV (valores separados por comas) para continuar el procesamiento.
Fase 2 (Analicemos esto…)
Limpieza de datos
La segunda tarea presentó un grado de dificultad alto, debido al ruido de la data. Por lo tanto se siguieron los siguientes pasos.
- Se eliminó cualquier tipo de puntuación.
- Se convirtieron los números a palabras usando la librería num2words.
- Se buscaron abreviaturas y textos con jergas cibernéticas como: “u” para “you”, “ur” para “your”, “what ‘s” para “what is”, entre otras. Además se creó un diccionario con estas palabras nuevas.
- Se eliminaron palabras frecuentes de escaso valor para este análisis, como the, and, that, a, any, an, be y with.
- Se eliminaron emojis, URL, hashtags y cualquier tipo de valor alfanumérico.
- Se empleó la técnica de lematización, para llevar todos los verbos a su forma en infinitivo. Para así crear incrustaciones a partir de palabras más simples.
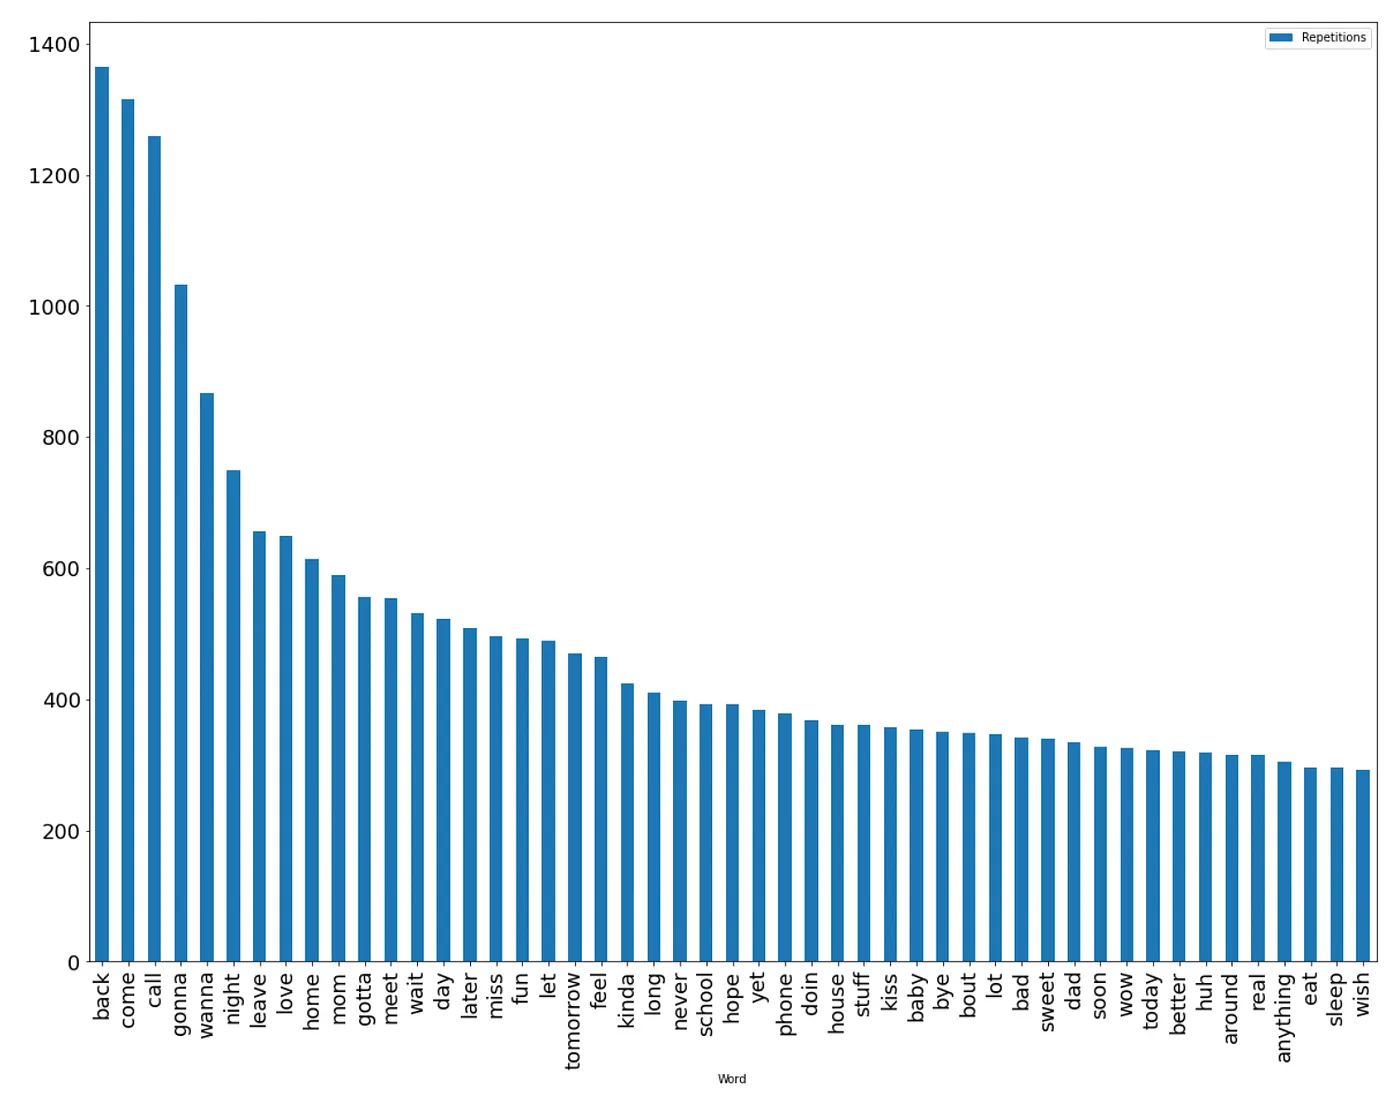
- Se exploraron los datos, analizando las 100 palabras más comunes en las conversaciones de los predadores.
Fase 3 (Entrenemos esto…)
Vectorización
La extracción de características representó un desafío particular, en primera instancia se optó realizarlo con base a las palabras más frecuentes presentes en las conversaciones de depredadores; no obstante, varias de estas eran de uso común, por lo que fue necesario analizar alternativas para lograr un óptimo desempeño. Es así que se optó por el uso del método TF-IDF (Term Frequency — Inverse Document Frequency), siendo una de sus características el resaltar la importancia de una palabra en un conjunto de documentos (corpus). En ese sentido, para transformar la secuencia de palabras (provenientes de las conversaciones) a vectores de características con representaciones numéricas se usó el vectorizador TF-IDF (TfidfVectorizer) de la librería de scikit-learn. Este transformador permitió generar una matriz de características, con una representación adecuada para realizar el entrenamiento del modelo. Para dicho propósito, se dividió el dataset en:
- Datos de entrenamiento: 80%
- Datos de testeo: 20%
Entrenamiento
Para el entrenamiento del modelo se usó la librería scikit-learn y se escogió el modelo Support Vector Machines (SVM) para emplear un clasificador binario.
Los hiper parámetros fueron:
- Parámetro de regularización (C): 10
- Kernel: RBF
- Coeficiente de kernel (gamma): Scale
Evaluación
Durante la evaluación del modelo se obtuvieron los siguientes resultados:
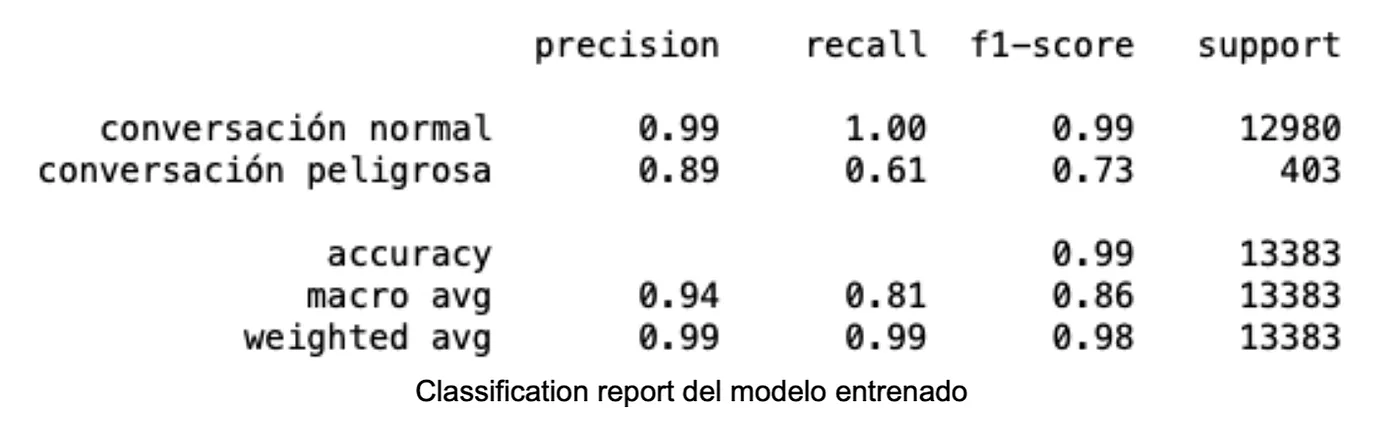
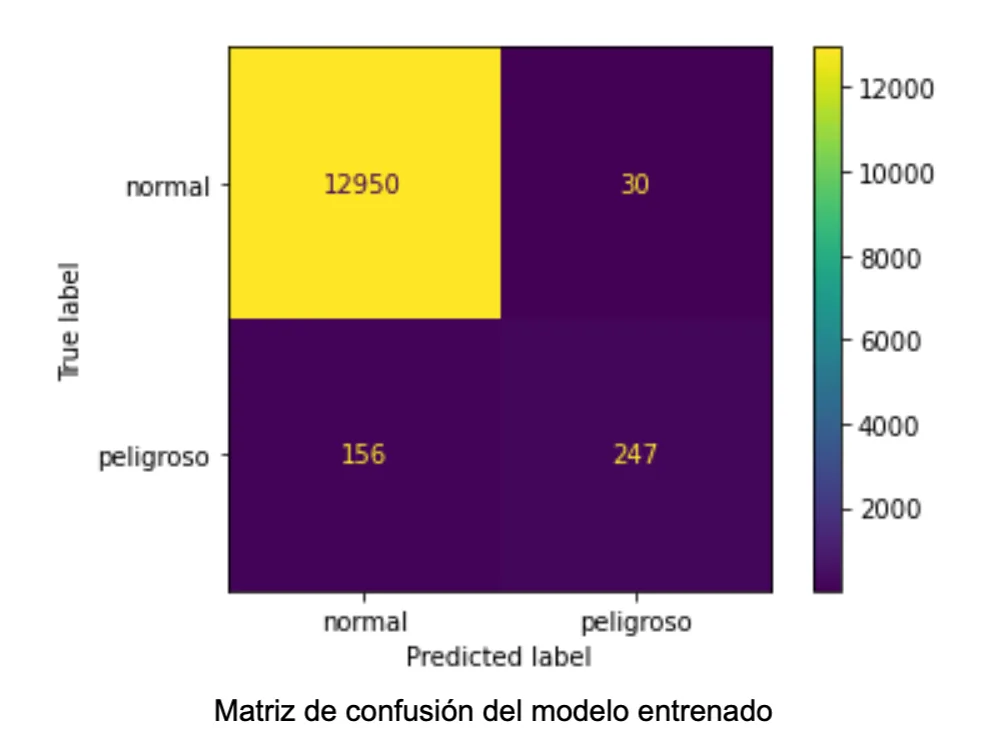
Siendo la matriz de confusión la siguiente:
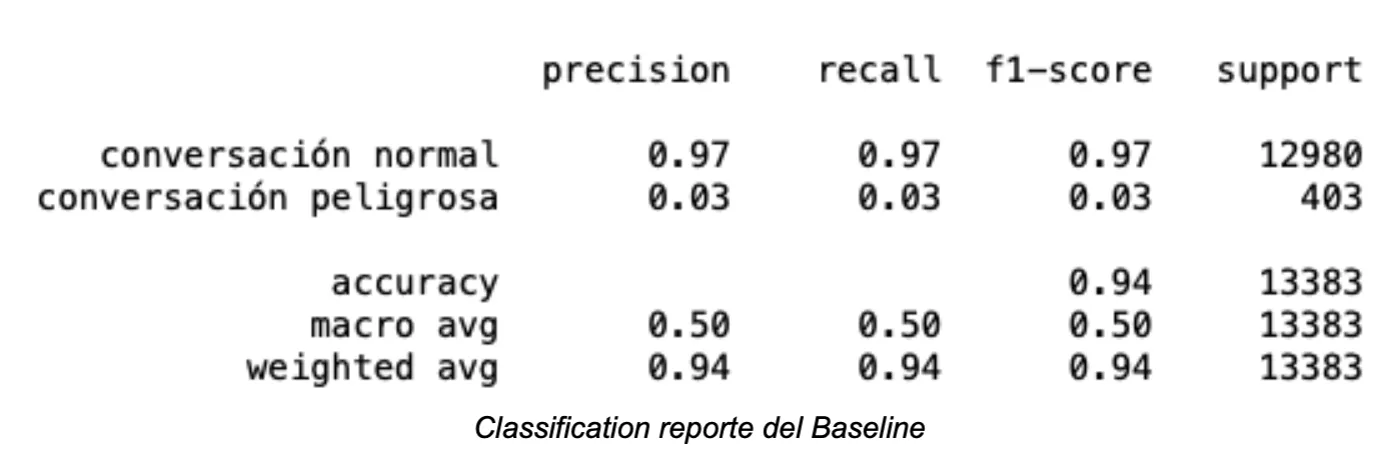
Los resultados del modelo muestran una notable mejora en comparación a aquellos correspondientes al Baseline:
Desplegamos el modelo en una aplicación web con Streamlit. La persona usuaria introduce una conversación y la aplicación muestra la categoría predicha. Los siguientes ejemplos ilustran su funcionamiento; una alerta requiere revisión y no demuestra por sí sola que haya abuso.
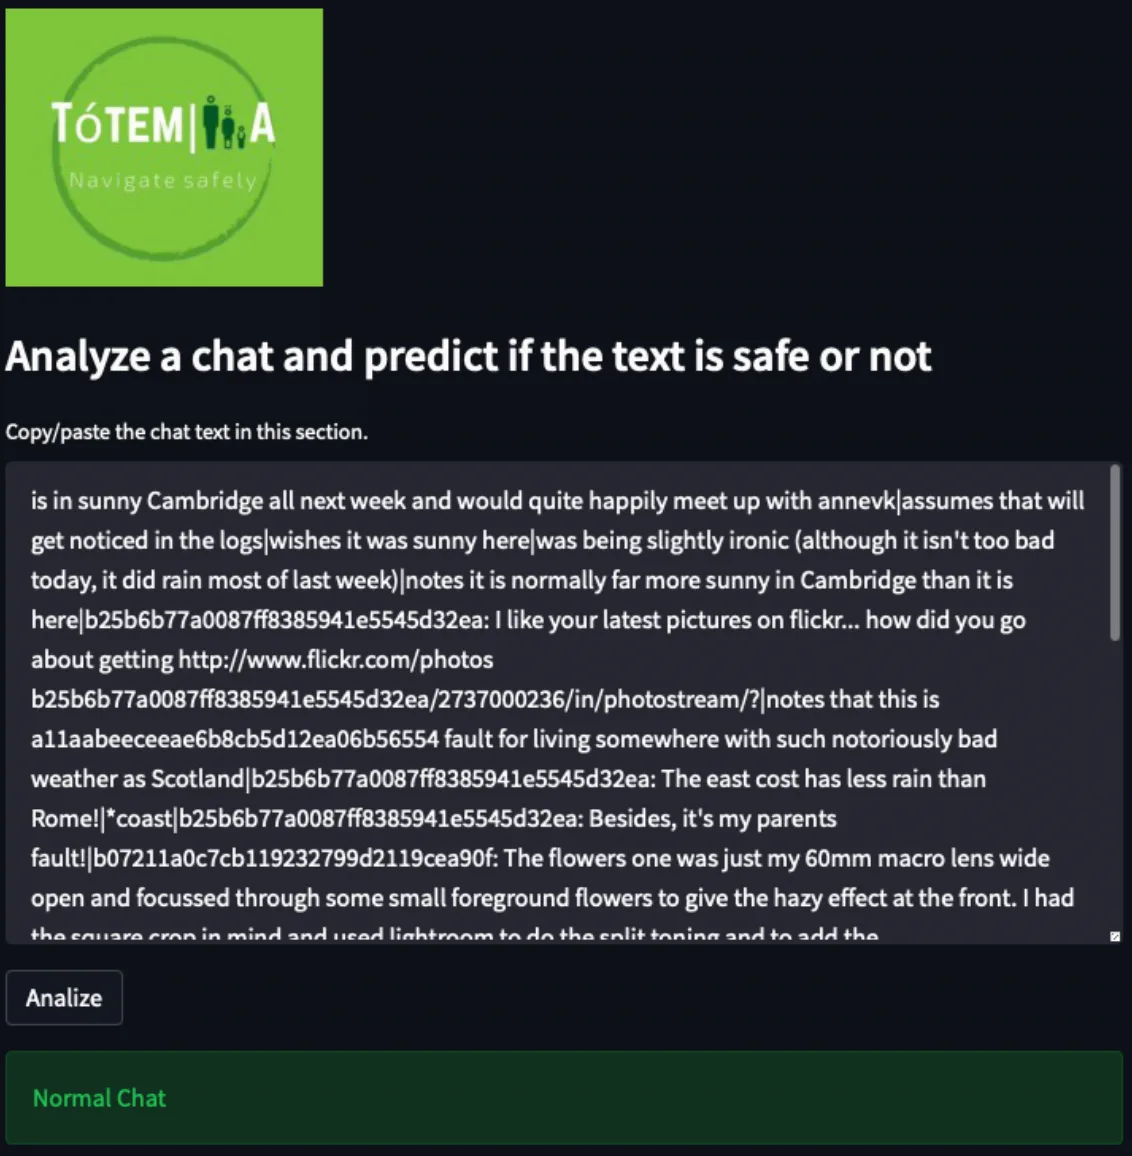
Resultado del análisis en una conversación normal
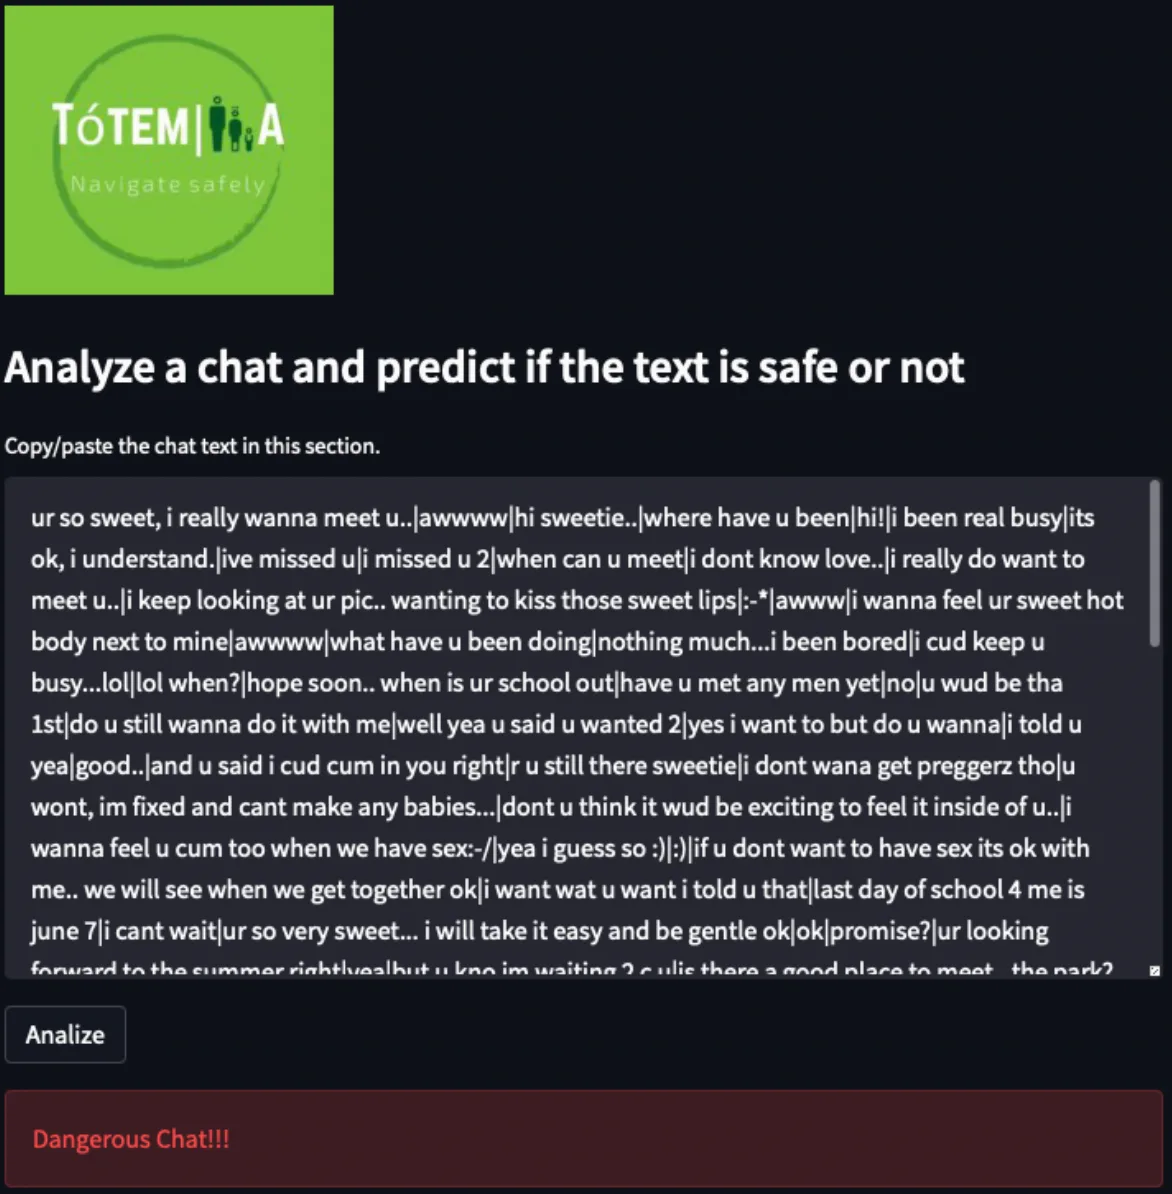
Resultado del análisis de una conversación peligrosa
¿Te hace sentido nuestra propuesta?
El prototipo permite clasificar conversaciones del conjunto estudiado y explorar alertas para su revisión. Una herramienta de supervisión de conversaciones también afecta a la privacidad: su desarrollo debe considerar consentimiento, acceso a los datos, errores de clasificación y el bienestar de los menores. No sustituye el acompañamiento de personas adultas de confianza.
En el futuro, sería genial desarrollar estas alertas al alcance de padres de familia como parte de las restricciones de algunas aplicaciones, que se preocupan por aplicar reglas de control parental para los usuarios vulnerables que hacen uso de sus servicios, tales como: https://www.facebook.com, https://www.instagram.com, https://www.tiktok.com, https://www.whatsapp.com, etc.
Referencias
- http://www.eset-la.com/micrositios/proteccion-infantil/descargar/grooming_chicos_eset.pdf
- https://www.unidiversidad.com.ar/por-la-hiperconectividad-en-cuarentena-el-grooming-aumento-un-30-en-argentina
- https://alumbramx.org/ciberacoso-y-grooming-contra-ninas-ninos-y-adolescentes-en-aumento-por-covid-19/
- https://www.abc.es/familia/padres-hijos/abci-grooming-y-aumentado-410-por-ciento-ultimos-anos-201903081632_noticia.html?ref=https%3A%2F%2Fwww.google.com%2F
- https://saludconlupa.com/la-vida-de-nosotras/ninas-y-mujeres-hablan-del-acoso-en-linea/
- http://pan.webis.de
- https://www.welivesecurity.com/la-es/2020/05/20/grooming-crece-durante-cuarentena/
Aquí puedes ver un video que describe nuestra propuesta
Integrantes
- Aarón Arguello
- Edson Segales
- Ingrid Velecela
- Karla Avilés
- Viridiana Vergara
Presentación del proyecto: DemoDay
Repositorio
Y si quieres ver la fuente de datos y el código que aplicamos, lo puedes encontrar en GitHub:
https://github.com/SaturdaysAI/Projects/tree/master/LATAM_remote/TotemIA
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 9 mar 2022.
← Más historias de la comunidad