Detección de datos de facturas manuales
Un prototipo de La Paz que extrae identificadores de facturas mediante reconocimiento óptico de caracteres y los exporta para facilitar su registro.
Proyecto de aprendizaje compartido por la comunidad. El artículo documenta el equipo, el método y los resultados; no acredita que el prototipo esté listo para su uso fuera del entorno de aprendizaje.
La Paz. Deep Learning. 2021
Introducción
La declaración de facturas forma parte de las obligaciones de determinados contribuyentes en Bolivia, tanto trabajadores por cuenta ajena como independientes. Los datos de algunas facturas electrónicas pueden importarse mediante un código QR, pero las facturas manuales requieren transcribir el NIT, el número de autorización y el número de factura. Este proceso lleva tiempo y puede resultar especialmente difícil para quienes tienen poca experiencia con herramientas digitales.
Figura 1. Imágenes de una Factura Manual
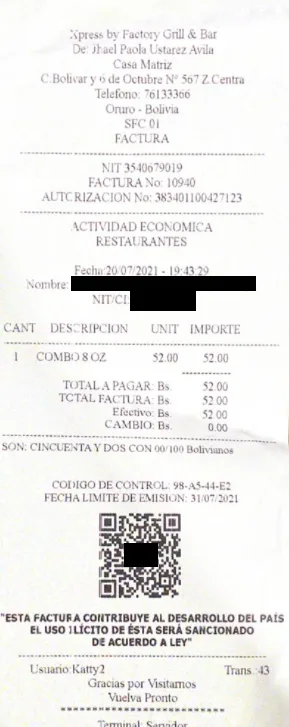
Figura 2. Imágenes de una Factura Manual y una Factura Digital
Por ello desarrollamos un prototipo de reconocimiento óptico de caracteres que identifica esos valores y permite exportarlos a un archivo CSV o XLSX, para importarlos en la plataforma SIAT (Sistema Integrado de Administración Tributaria).
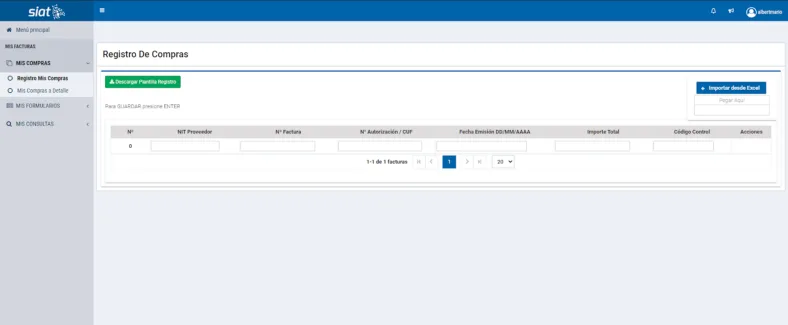
Figura 3. Pantalla principal de la plataforma SIAT, para la importación de datos de facturación.
Figura 4. Botón de importación de archivos xls o xlsx.
Descripción del problema
El problema identificado es la cantidad de tiempo que se invierte a la hora de transcribir la información de cada una de las facturas manuales; tanto a personas con tiempo limitado por múltiples actividades personales o profesionales, como a personas con poca habilidad computacional.
Objetivo
El proyecto busca facilitar la extracción de los identificadores más largos de las facturas manuales: el NIT de la empresa, el número de autorización y el número de factura. Después los exporta en formato CSV o XLSX para su importación en la sección Mis Facturas de SIAT.
Selección del modelo
CRAFT
Se utiliza CRAFT (Conciencia de región de caracteres para detección de texto) [1], porque permite localizar regiones correspondientes a caracteres individuales y agruparlas en texto. Tesseract era otra opción de OCR, aunque los textos curvos o las formas irregulares de algunas fuentes planteaban dificultades para nuestro caso de uso.
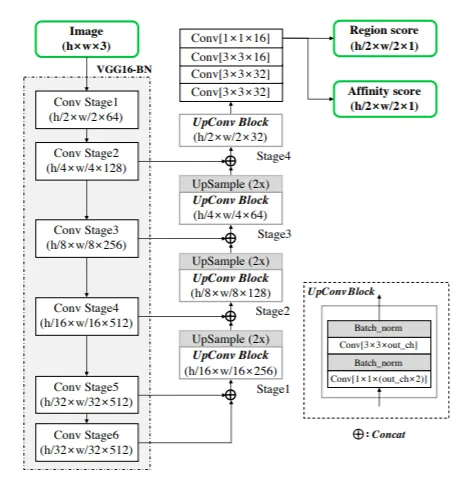
Figura 5. Ilustración esquemática de la Arquitectura del modelo CRAFT
La arquitectura utiliza VGG-16 [2], una red neuronal convolucional, para extraer características de la imagen de entrada. Estas representaciones alimentan la etapa de decodificación de CRAFT.
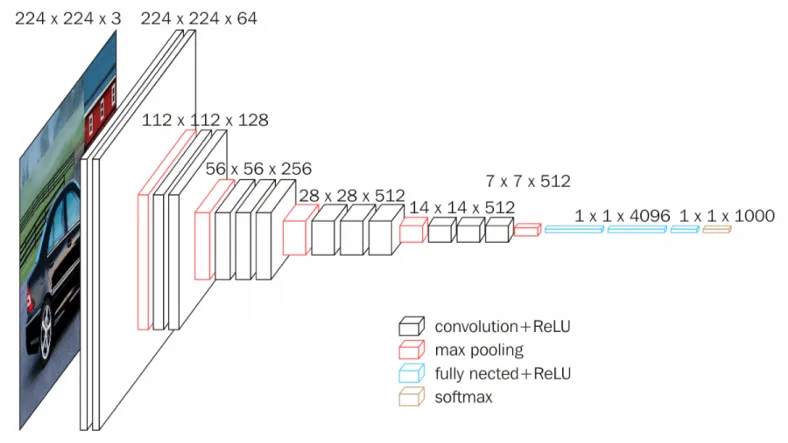
Figura 6. Modelo de la CNN VGG-16.
Técnicas implementadas
Las técnicas implementadas por el modelo CRAFT son las básicas para la detección de caracteres, como ser: cortes, rotaciones y/o también variaciones de colores.
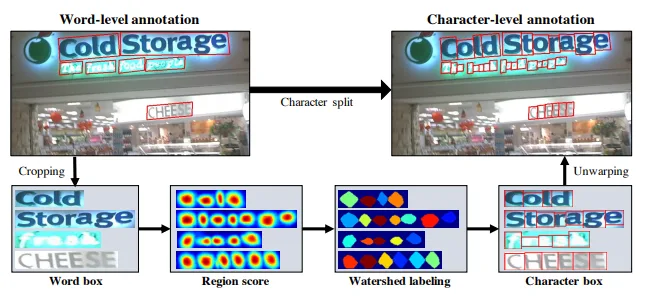
Figura 7. Procedimiento de división de caracteres para lograr anotaciones a nivel de caracteres a partir de anotaciones a nivel de palabra: 1) Se recorta la imagen a nivel de palabra; 2) Se predice la puntuación de la región; 3) Se aplica el algoritmo cuenca; 4) Se obtienen los cuadros delimitadores de caracteres; 5) Se desempaquetan los cuadros delimitadores de caracteres.
Evaluación de modelos
Utilizamos el modelo CRAFT preentrenado incluido en KERAS-OCR [3]. La siguiente comparación muestra sus resultados frente a otros modelos de detección de texto:
.
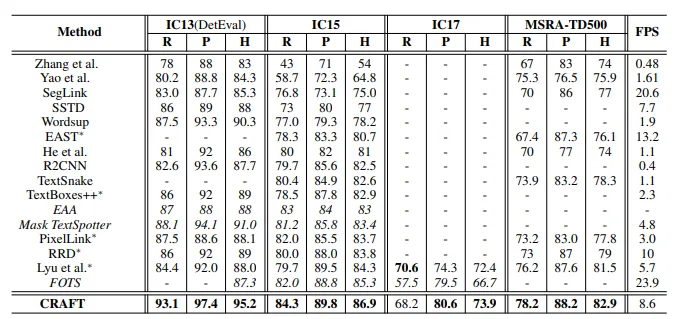
Figura 8. Comparativa de diferentes modelos, donde se utilizaron los dataset ICDAR y MSRA-TD500. Dónde: P es la Precisión, R es Recall, H es la H-mean y FPS los cuadros analizados por segundo [4].
Análisis de resultados
El sistema detecta inicialmente el texto de toda la factura. Como en nuestros ejemplos los identificadores buscados se encuentran en la mitad derecha, recortamos la imagen para limitar la información que debemos procesar. La figura 9 muestra la cantidad de texto detectado sin ese recorte.
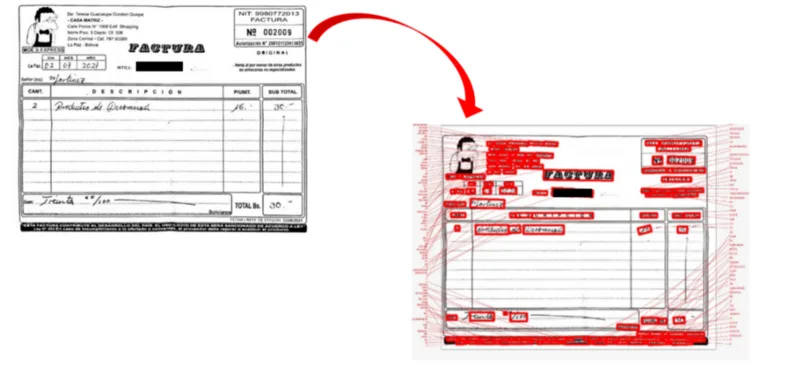
Figura 9. Detección de caracteres de una factura manual.
Convertimos el texto detectado en cadenas de caracteres y lo organizamos en un dataframe de Pandas. Después buscamos candidatos según su longitud: de 8 a 10 caracteres para el NIT del proveedor, de 14 a 16 para el número de autorización y de 4 a 6 para el número de factura. Estas reglas nos ayudan a localizar los valores en los ejemplos analizados.
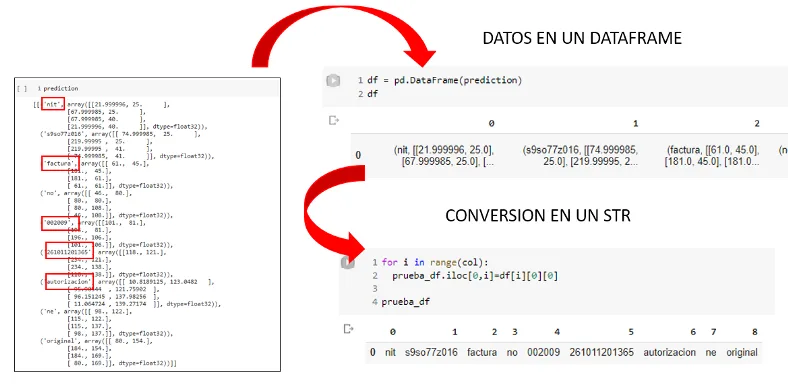
Figura 10. Detección de valores deseados, transformación a un dataframe con Pandas y conversión de los datos a STRING para su posterior comparación.
Finalmente, guardamos estos valores en un dataframe con la estructura requerida por Mis Facturas de SIAT y los exportamos a CSV o XLSX, como muestra la figura 11.
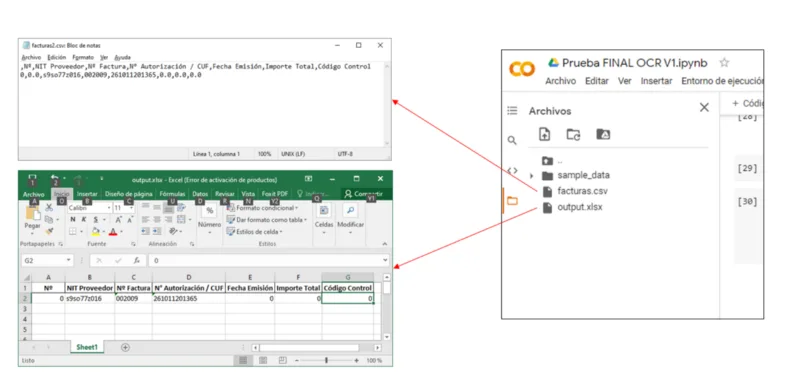
Figura 11. Exportación de datos generados a los archivos CSV y XLSX.
Conclusión
Por medio de este prototipo, se puede identificar los valores más relevantes y complicados de transcribir para la mayoría de las personas que realizan su declaración de facturas. Además, que el importarlos desde una foto o imagen escaneada reduce drásticamente el tiempo de transcripción de datos. Lo que sería de mucha ayuda para personas no muy familiarizadas con las computadoras, como un buen porcentaje de adultos mayores en el país.
Aunque se identifican muchos de los datos, la calidad de la imagen sigue siendo la principal limitación. Una resolución o nitidez insuficiente dificulta reconocer algunos caracteres. Como trabajo futuro, proponemos evaluar un entrenamiento específico para estas facturas, además del modelo preentrenado.
Una interfaz gráfica de usuario (GUI) también haría más sencillo utilizar el prototipo, desde cargar fotografías o facturas escaneadas hasta revisar y exportar los datos reconocidos.
Código
https://github.com/albmarale/SaturdaysAIDeepLearning
Bibliografía
[1] "PyTorch: Detección y reconocimiento de texto de escena mediante CRAFT y una red de cuatro etapas | por Nikita Saxena | Hacia la ciencia de datos". https://towardsdatascience.com/pytorch-scene-text-detection-and-recognition-by-craft-and-a-four-stage-network-ec814d39db05 (consultado el 13 de julio de 2021).
[2] M. ul Hassan, "VGG16-Red convolucional para clasificación y detección", en l{\’\i}nea].[consulta 10 abril 2019]. Dispon. en https//neurohive. io/en/popular-networks/vgg16, 2018.
[3] F. Morales, “keras-ocr — documentación keras_ocr”, 2021, consultado: 13 de julio de 2021. [En línea]. Disponible: https://keras-ocr.readthedocs.io/en/latest/.
[4] Y. Baek, B. Lee, D. Han, S. Yun y H. Lee, “Conocimiento de la región del carácter para la detección de texto”, en Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, págs. 9365–9374.
Este proyecto fue elaborado por:
- Albert Martínez Alegría
- Alvaro Alanoca Huaycho
- Belinda Alcón Sullcani
- Rodrigo Aliaga
Para el programa Saturdays.AI La Paz.
Presentación del proyecto: DemoDay
Repositorio
En el siguiente repositorio se encuentra el código usado para desarrollar esa aplicación: https://github.com/SaturdaysAI/Projects/tree/master/Lapaz/2021.DL/Deteccion-facturas-manuales-main
¡Más inteligencia artificial!
Saturdays.AI acerca la IA a más personas a través del aprendizaje en comunidad y de proyectos con impacto social. Nuestro lema es AI4ALL IS AI4GOOD.
Explora los cursos disponibles
Si quieres aprender más sobre este proyecto (y otros) únete a nuestra comunidad o aprende a crear los tuyos en nuestro programa AI Saturdays.

Autoría
Una historia de la comunidad Saturdays.AI. Publicada originalmente el 22 nov 2021.
← Más historias de la comunidad